コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 故障を一つ名指す予想する failure pattern を書きます。
- 部品を一つ変えるdata、budget、evaluation を固定します。
- 全結果を残すpositive、null、negative は全部必要です。
小さなお話:全部を交換した整備士
車が左へ寄ります。整備士は tire、steering、engine、road map、driver を全部交換しました。車は真っすぐ走りました。何かは効きましたが、修理からほとんど学べません。
world-model system にも分けられる部品があります。data/preprocessing、representation、action-conditioned dynamics、planning cost、CEM search、execution/evaluation です。全部を一緒に動かすと、高い success number からどの idea が効いたか分かりません。
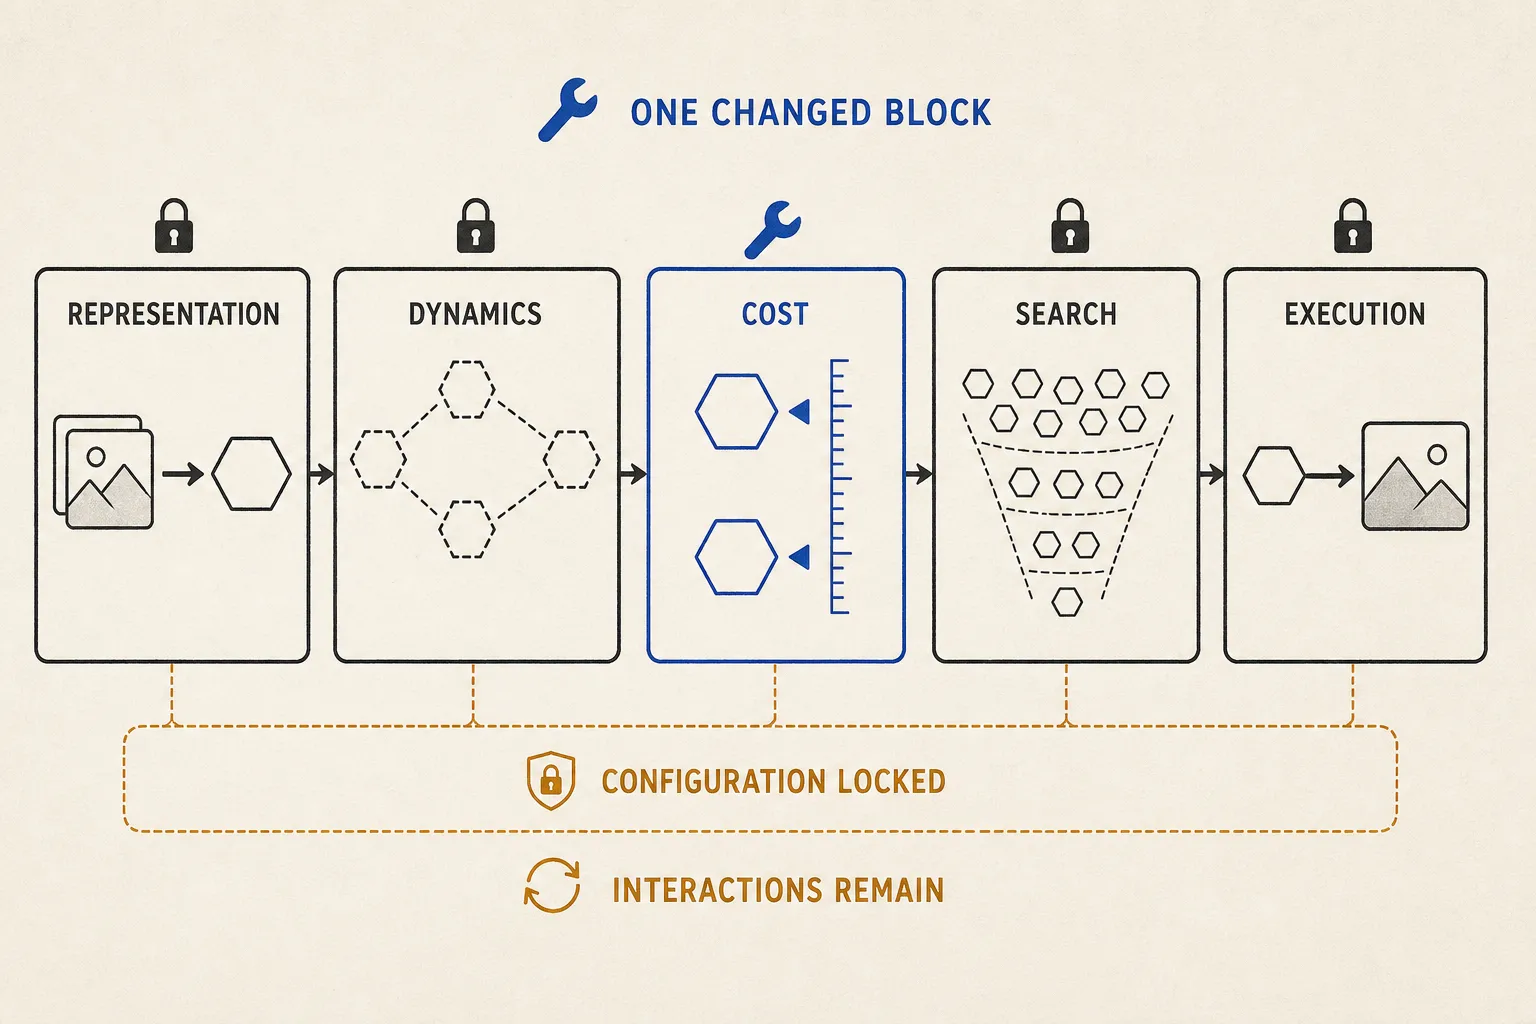
一つの locked comparison は claim を局所化します。同じ repair が全 environment で効く証明ではありません。
技術のリュック
run の前に claim を書きます。
- Failure mechanism: 例として terminal Euclidean cost が壁越し endpoint を不当に高順位にする。
- Predicted interaction: reachability-aware cost は matched open-room goal より wall-separated goal を大きく助けるはず。
- Falsifier: 壁を除いても同じ大きな gain、oracle dynamics で消える、または追加 CEM budget だけで起きる。
- Locked contract: dataset/hash、preprocessing、encoder、predictor、checkpoint rule、seed、start/goal、action budget、CEM population/elites/refinements、executed prefix、episode count、metric。
ablation ladder を使います。baseline → component を追加 → 削除 → signal を shuffle/randomize → strength sweep です。可能なら parameter count と compute の両方を合わせます。training budget と planning budget は別通貨です。extra epoch を fewer candidate plan と黙って交換したり、extra CEM candidate を representation gain と呼んだりできません。
oracle substitution は bottleneck を切り分けます。
| Dynamics | Cost | この cell が尋ねること |
|---|---|---|
| learned | learned | full system は働くか |
| oracle | learned | rollout error を除いても failure が残るか |
| learned | oracle | 同じ model を良い ranking が救うか |
| oracle | oracle | simulator knowledge 下でも search/execution が限界か |
oracle state、shortest path、dynamics は simulator-only diagnostic tool です。oracle gain は headroom を示しますが、learned replacement が達成可能だとは示しません。
壊してみる
matched TwoRoom layout を使います。一方は separating wall と doorway があり、もう一方は wall を除きます。同じ start、goal、candidate bank、model checkpoint、budget を再利用します。topological-cost hypothesis は wall case でより大きな改善を予測します。“repair” が open space でも同じだけ勝つなら、単なる score rescaling や optimization change かもしれません。
一つの best run ではなく seed と goal type ごとの distribution を報告します。代表 trajectory を保存し、failure を encoder aliasing、action-insensitive prediction、self-fed rollout drift、wrong cost ranking、CEM miss、execution mismatch に分類します。null result は「この条件で支持される gain なし」であって「永遠に不可能」ではありません。予想した境界に一致する negative result は、ときに最も強い手掛かりです。
実験レシートと証拠の境界
- diagnostic を動機付ける source: LeWorldModel v3、RC-aux v1、TwoRoom reproduction v1、VIScore v2、ACPC v1、Objective Bottleneck v1、DA-LeWM v1、stable-worldmodel v1。
- 凍結 public snapshot: LeWM
8edfeb3、RC-auxecb4496、tinylabefa9e5d、VIScorebbb60fc、ACPC90d4276、stable-worldmodeladdbab4、release0.1.1。DA-LeWM code は未確認です。 - 引用 diagnostic version は 2026-08-10 から 2026-08-19、cutoff は 2026-08-20、Asia/Tokyo。明記した TwoRoom 再実装以外の source evaluation は author-reported です。ここで提案する experiment は、誰かが run するまでは tutorial construction です。
- 許される結論は「この design 内で isolate」「locked condition 下で mechanism を支持」「ここでは改善しなかった」です。「原因を証明」「universal reachability を学習」「platform が fairness を保証」「TwoRoom が robotics generalization を確立」は避けます。
3つのクイック質問
- representation、predictor、planner を一緒に変える実験が弱いのはなぜですか?
- 四つの oracle cell は、どの異なる bottleneck を切り分けますか?
- wall-removal test のどんな結果が topology explanation を弱めますか?