コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
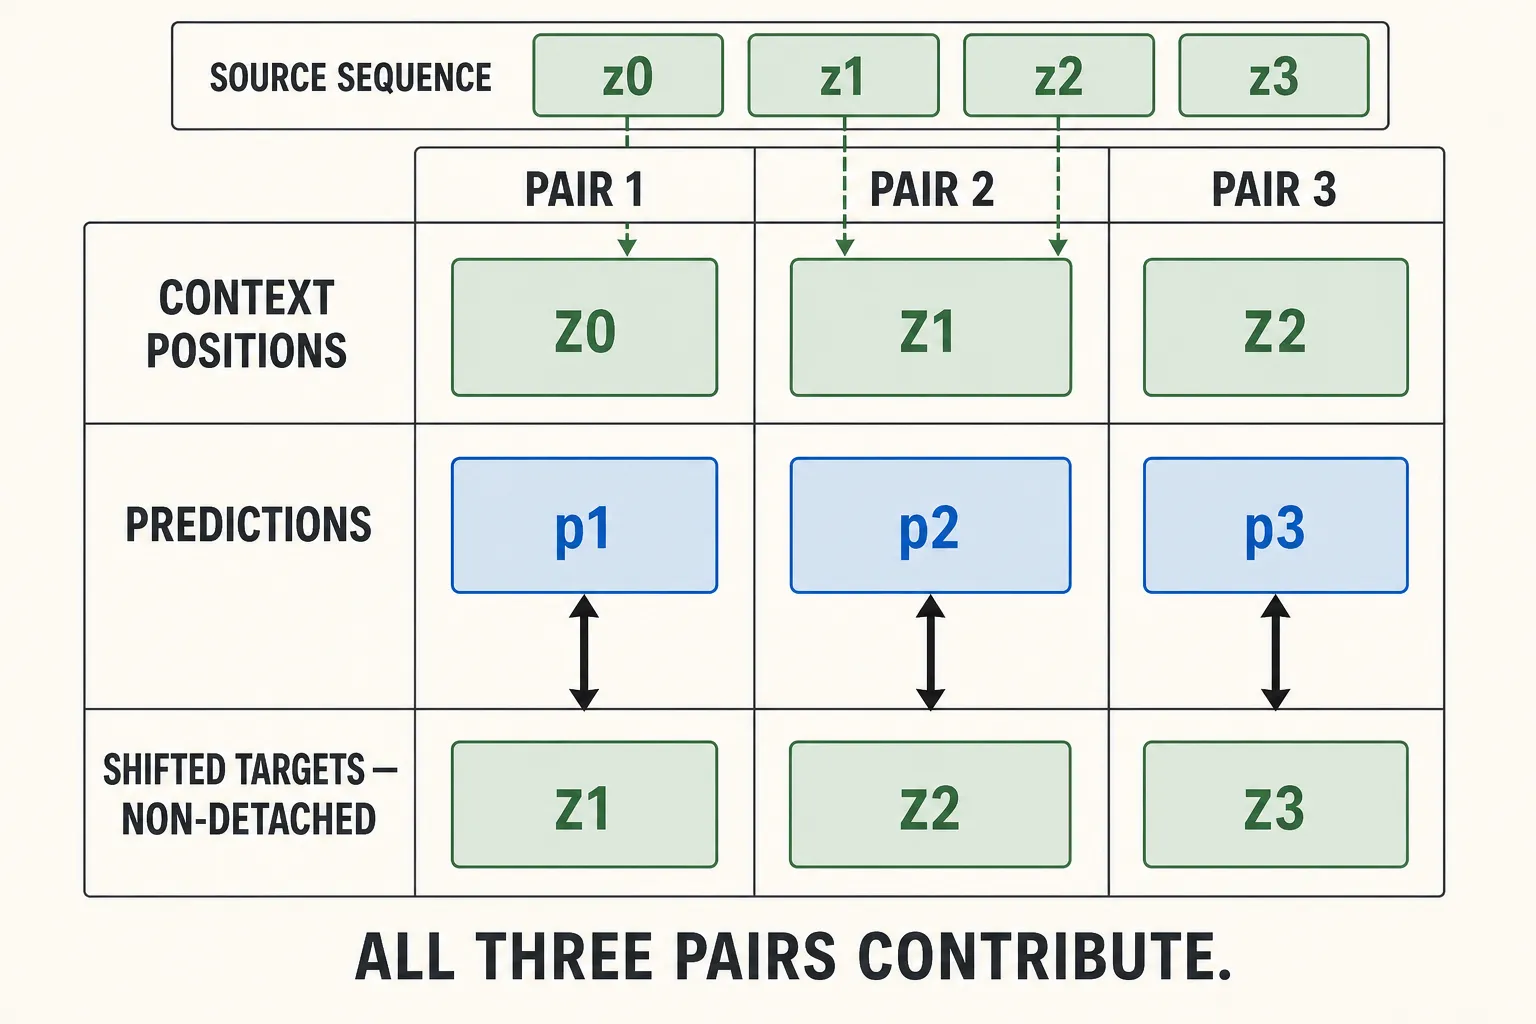
- 4つencodez0 z1 z2 z3
- 3つ揃えるa0 a1 a2
- 3つ予測p1 p2 p3
- targetとzipp1↔z1, p2↔z2, p3↔z3
小さなお話
工場は正しい大きさの箱に、間違ったlabelを入れて出荷できます。LeWM batchも同じです。prediction 3本とtarget 3本のshapeが揃っていても、predictionをnextではなくpresentと比べたり、最後のpairだけ学習したり、targetをdetachしたりできます。
本章の約束はprovenanceです。各slotで、どのobservation、action block、prediction、targetが対応するかを指差せるようにします。
技術バックパック
frozen defaultはforward pass全体を具体化します。batch B=128、history_size=3、num_preds=1、latent width D=192、frameskip=5です。
pixels                 [B,4,C,H,W]
flattened pixels       [B×4,C,H,W]
observation latents    [B,4,192]
raw action blocks      [B,4,5×A]
encoded actions        [B,4,192]
state/action context   [B,3,192]
connected targets      [B,3,192]
predictions            [B,3,192]
SIGReg input           [4,B,192]
losses                 scalar
paperはTwoRoomのhistoryを1、PushT/OGBench-Cubeを3と報告し、frozen global defaultは3です。これらはfrozen defaultのshapeであり、全LeWMの定数ではありません。
最短のfaithful forward cardは次です。
z = encode_each_frame(images)              # [B,4,D]
u = encode_each_action_block(actions)       # [B,4,D]
z_pred = causal_predict(z[:,:3], u[:,:3])  # [B,3,D]
z_next = z[:,1:]                            # [B,3,D], detachしない
L_pred = mean_square_gap(z_pred, z_next)
L_sig = sigreg(time_first(z))               # [4,B,D]
L_total = L_pred + lambda * L_sig
3つのshifted one-step pairすべてが寄与します。num_preds=1はone-position target offsetであり、最後の1出力ではありません。このdata configの1 model stepは5 environment actionsをまたぎます。
prediction branchはvisual encoder、encoder projector、action encoder、causal predictor、prediction projectorを直接学習します。z_nextはconnectedなので、predictionは同じvisual encoderのtarget useからも戻ります。SIGRegが直接学習するのはvisual encoderとそのprojectorだけです。1 optimizerがconnected learned systemを更新し、target-encoder optimizerやEMA updateはありません。
SIGRegは各relative time positionでbatch populationを見ます。B×Tを1 populationへflattenしてはいけません。temporal changeとacross-example diversityは別物です。frozen codeは1,024 random projectionsと0〜3の17 frequency knotsを使います。paper appendixのquadrature presentationは異なります。paper method weightは0.1、frozen YAMLは0.09です。source labelを残します。
だまされる仕掛け
わざと間違えたbranchを作ります。
wrong targets: [z0,z1,z2]
right targets: [z1,z2,z3]どちらも[B,3,D]です。wrong branchはpresentのcopyを学び、よいlossを出せます。time checksumを見える形で付け、prediction_slot / last_visible_context / target_sourceをprintします。正しいrowは0/0/1、1/1/2、2/2/3です。
次にgraphを試します。disposable probeで正しいtarget sliceだけdetachし、target-side gradient routeが消え、context routeが残ることを確かめます。encoderに何らかのgradientがあるだけでは十分ではありません。
5つのcheap checkは、exact shape、shift provenance、causal future-mutation、expected moduleのfinite/non-null gradient、NaN/infinityなしです。通過が証明するのはmechanicsであり、有用なdynamicsやplanningではありません。
実験レシート
LeWorldModel v3、固定train.py、jepa.py、module.pyがfrozen alignmentとconnected graphを裏づけます。paperのdisplayed training pseudocodeにはmalformed F.mse_loss callがあるため、exact indexingはexecutable train.pyを典拠にします。
next targetをplanning goalと呼ぶ、JEPAの癖でdetachする、SIGRegでbatch/timeを混ぜる、matching shapeをcorrectnessとみなす、のはいずれも誤りです。
3問クイックチェック
- 4 observationsから作る3 prediction–target pairsは何ですか。
- prediction lossはvisual encoderのどの2つのuseから流れますか。
- wrong temporal targetが通常のshape assertionを全部通れるのはなぜですか。