コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
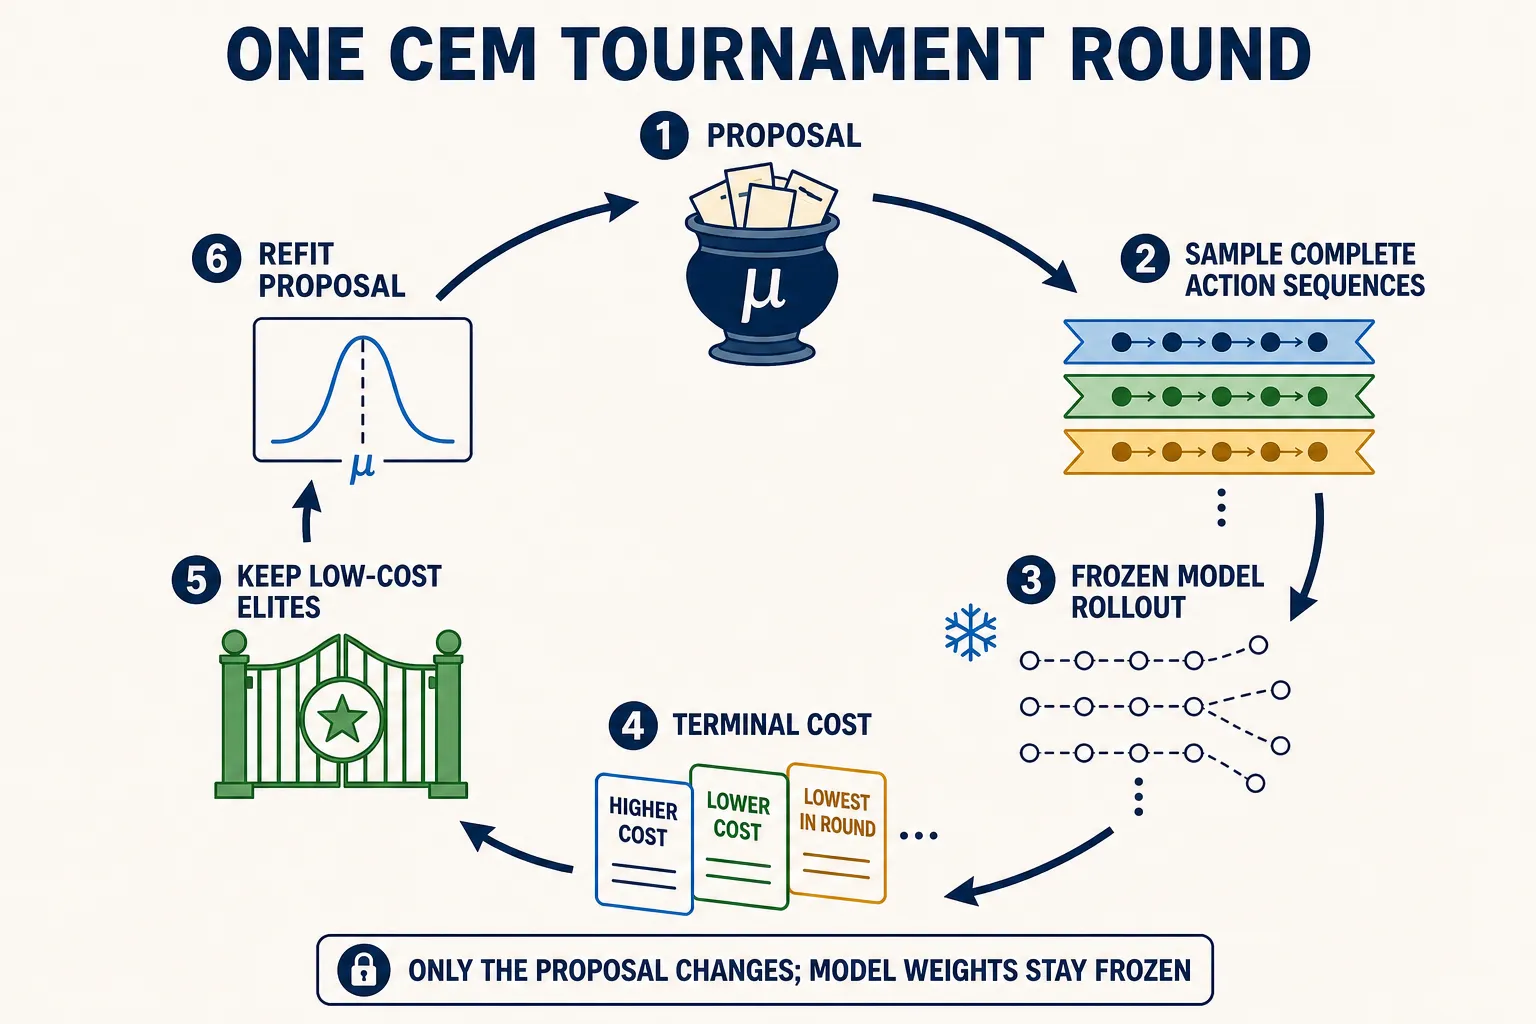
- 候補を出す行動列を丸ごと引く。
- 想像する凍結モデルで全候補を進める。
- 選ぶ低コストの elite を残す。
- 寄せる提案分布を更新して繰り返す。
小さなお話
監督は、考えられるすべての踊りを見られません。そこで300人に最初から最後まで踊ってもらい、モデル内の点数がよい30人を次のオーディションの参考にします。何回か繰り返すと、有望そうな踊りの近くに候補が集まります。
これが LeWM の計画で使う Cross-Entropy Method(CEM)です。ここでの cross-entropy は分類 loss ではなく、sampling optimizer の名前です。encoder と predictor は凍結したままです。変わるのは行動列を引く提案分布だけです。
本当のルール
候補は、貪欲な1行動ではなく、未来の行動列全体です。概念上の shape [B, N, H, A] は、環境 batch、候補数、計画 horizon、action block 幅を表します。
行動列全体に対する提案分布を初期化
決めた round 数だけ繰り返す:
  候補を sample
  凍結 world model で rollout
  候補ごとに終端 goal cost を1つ計算
  低 cost の elite を残す
  elite から提案分布を fit し直す
宣言した solver 規約で plan を返す
LeWM の設定は 300 candidates と 30 elites です。論文の一般説明と凍結 shared YAML は refinement 30 rounds、Appendix D は PushT が最大30、その他が10と述べます。これらを1つの「公式値」に混ぜてはいけません。
連続制御には multivariate Gaussian proposal が記述されています。clipping、covariance、smoothing、bound 処理の正確な挙動は、解決した外部 solver revision に属します。LeWM core はその依存版を pin していません。離散行動用の categorical CEM は一般には作れますが、この凍結 baseline で動く証拠にはなりません。
だまされる反例
障害物の左と右に、同じくらいよい2本の道を作ります。elite は2群に分かれます。しかし Gaussian の平均は、その真ん中の障害物を指すかもしれません。
そのため、実際に sample された最良候補と、最後の proposal mean を別々に保存します。LeWorldModel Appendix B は final mean、Algorithm 2 は best sequence または final mean の先頭行動を許します。調査した stable-worldmodel の 0.0.5 と addbab4 は、どちらも final mean を返します。ただし LeWM が歴史的依存版を pin していないため、著者がどちらを使ったかの証明ではありません。best_seen 実行は明記した tutorial variant です。
探索を増やせば必ず安全になるわけでもありません。CEM は細い良経路を見逃し、早く縮みすぎ、平らな cost に迷い、2つの mode を平均し、action bound に張り付き、learned model の穴を上手に見つけることがあります。elite は現実の成功者ではありません。
実験のレシート
horizon、action 幅と変換、proposal seed と初期 scale、population、elite、round、cost 分布、horizon 位置ごとの spread、bound 比率、support 警告、model call、hardware、時間を記録します。実行した real action 予算と imagined predictor work は分けます。
根拠は LeWorldModel v3、凍結 config 8edfeb3、別に調査した solver snapshot です。独立 TwoRoom 再実装 は1環境で10と30 roundsを比べましたが、歴史的依存版や全 benchmark を確定しません。
言えるのは「CEM は有限 sample を、モデル内 cost が低い行動列の近くへ集める」までです。global optimum も現実成功も保証しません。
3つのクイック質問
- CEM 中に変わるものと、凍結されたままのものは何ですか。
- 2つのよい elite 群の平均が悪くなるのはなぜですか。
- 非 PushT の refinement 数について、どの source card が食い違いますか。