コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 見る今の観測
- 動かす揃ったaction block
- もう一度見る観測された結果
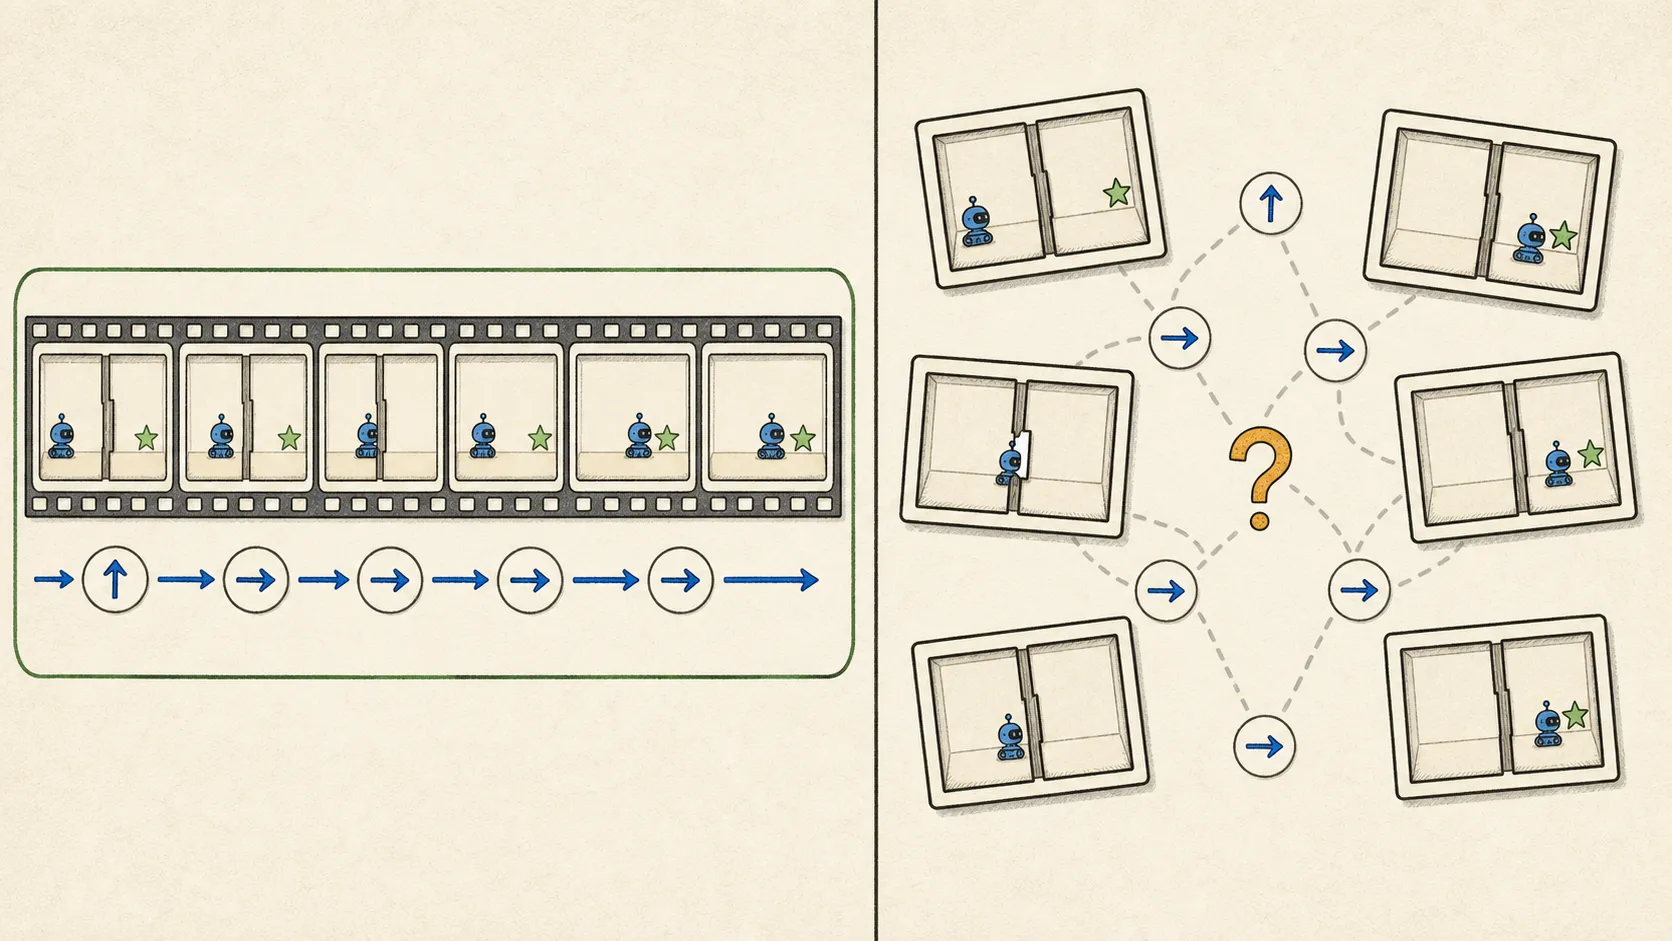
小さなお話
1回のTwoRoomの旅から、2冊の写真albumを作ります。1冊目はframeを順番どおりにし、間にcontrolを書きます。2冊目は同じ写真を混ぜ、controlを捨てます。どちらも部屋の見た目を教えられますが、特定行動の後に何が起きたかを教えられるのは1冊目だけです。
episode boundaryも同じくらい大切です。あるrunの最後と次runの最初をつなぐと、偽のteleportationを教えます。world modelに必要なのはtransitionであり、見た目の在庫ではありません。
本当のルール
LeWMのworld-model trainingはofflineかつreward-freeです。記録済みepisodeを再生し、base objectiveにtask rewardやgoalを使いません。しかしaction-free、deployment時もgoal-free、無制限な外挿、という意味ではありません。
frozen data configはframeskip=5です。1 model transitionは5つの連続lower-level environment actionsをdense blockにまとめます。最後のactionだけを取ったり、1つを5回繰り返したりしません。train.pyはactionを含むnon-pixel columnをz-scoreし、action encoder widthを次で実行時に決めます。
frameskip × environment action dimensionfrozen defaultはhistory_size=3、num_preds=1なので、sampled windowには4 observation positionsがあります。最初の3 latentがcausal context、1位置shiftした列が3つのone-step targetです。
z0 -> z1
z1 -> z2
z2 -> z3num_preds=1はoffsetであり「最後のpairだけ」ではありません。v3 paperはTwoRoomのhistoryを1、PushT/OGBench-Cubeを3と報告し、frozen global configは3です。runがどちらを使ったか記録します。
coverageはx-y heatmap以上のものです。transitionは、見えているもの、recent motion/contact、proposed actionに依存します。全位置をゆっくり訪れても高速のdoorway motionは覆いません。静止中のPushT object angleを見ても、同じ画像でcollision中の状態は覆いません。この組合せsupport外で滑らかな出力が出ても、根拠があるとは限りません。
だまされる仕掛け
Collector Aは1つの部屋を回り、何百万枚ものきれいなframeを記録します。Collector Bは少ないframeでも、両方のdoorへ近づき、衝突し、停止し、双方向に通り、速度を変えます。画像数はAが多くても、cross-room dynamics evidenceはBの方が優れるかもしれません。
次にBのaction logを1 indexずらします。visitation mapは立派なままですが、結果が誤ったcontrolと結びつきます。あるいはtraining windowをreset越しにすると、teleportationを学びます。どちらもshape checkだけでは見逃せます。
学習前にcomplete episodeを再生し、timestamp/action blockを見て、完全なdoor crossingを数え、regionとmotionごとのaction histogramを調べ、欠けた組合せを書き出します。
実験レシート
LeWorldModel v3、固定train.py、固定TwoRoom data configurationがtrajectory interfaceとconfig factを裏づけます。paperはnoisy doorway-travel heuristicで収集したTwoRoom 10,000 episodes、平均92 environment stepsを報告します。これはdataset descriptionであり、普遍的最低量やcomplete coverageの証明ではありません。
独立TwoRoom reproductionは、dense action gathering、runtime action width、ImageNet pixel normalization、action z-scoringを、YAMLだけでは揃わないreproduction-critical conventionとして特定しました。証拠はsingle-seedの1 environmentに限られます。
3問クイックチェック
- 同じframeでもshuffleするとaction-conditioned dynamicsを教えられないのはなぜですか。
- windowがepisode resetをまたぐと、どんな偽eventが生まれますか。
- x-y全位置を訪れてもtransition coverageを証明できないのはなぜですか。