コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- capability を名付けるpredict、decode、control のどれか。
- test を名付けるmetric、baseline、intervention。
- condition を名付けるdata、support、budget、seeds。
- 境界を名付けるまだ何が言えないか。
小さなお話
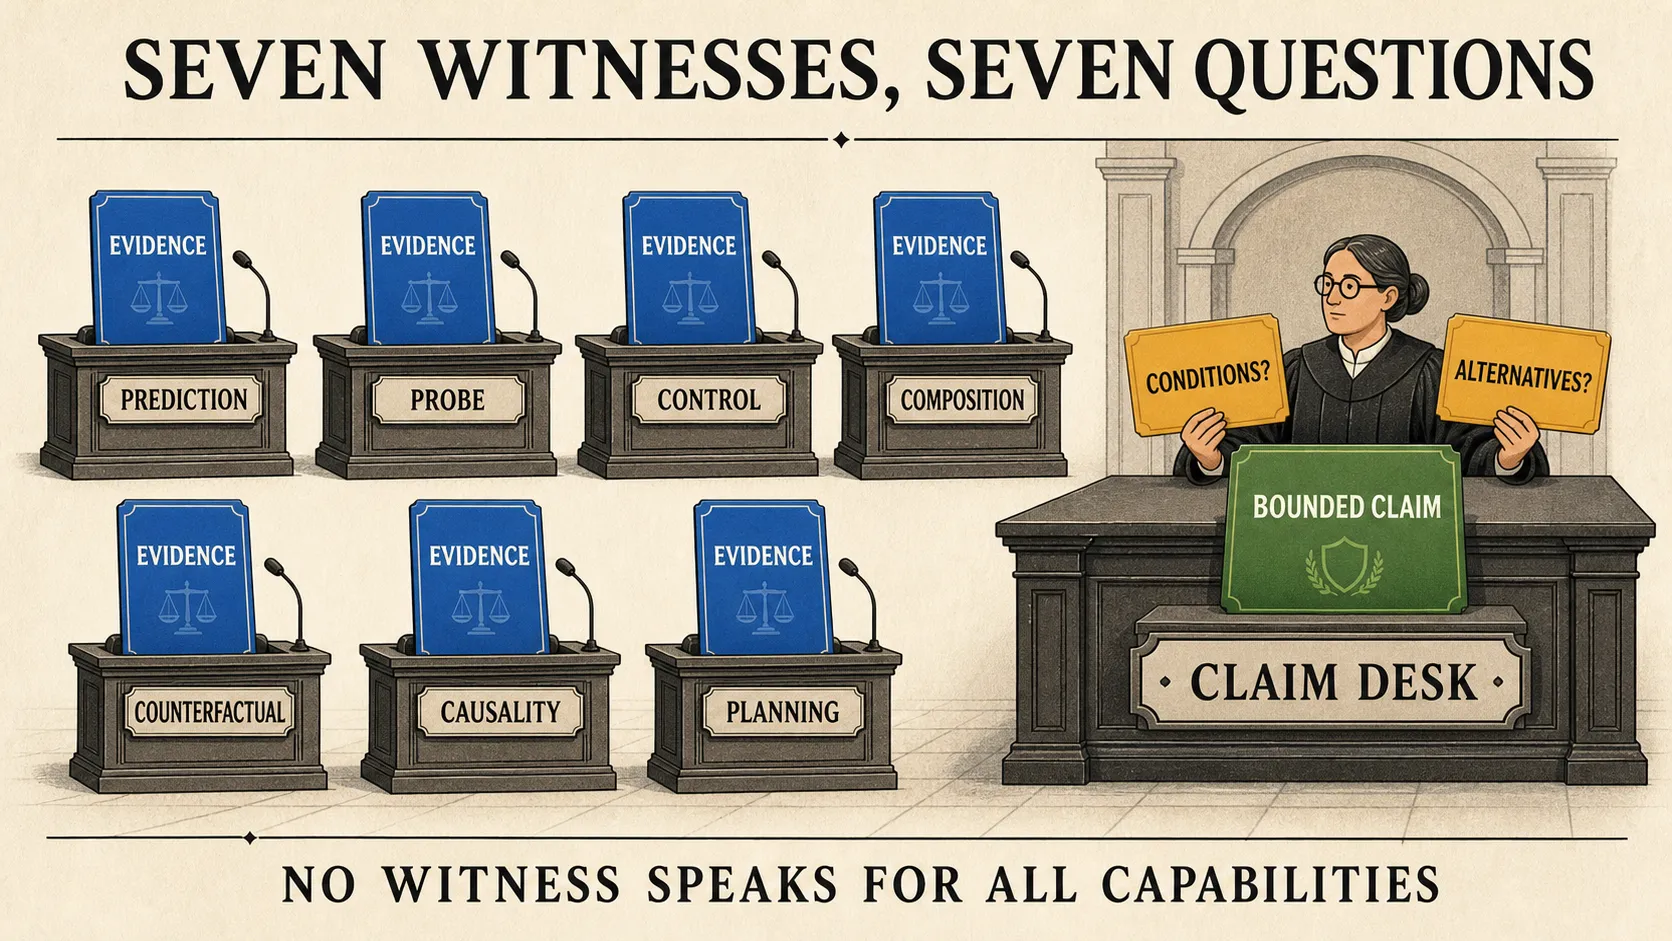
7人の witness が「model は world を理解した」と言います。1人は low prediction error、1人は position decode、1人は action change、1人は unseen combination、1人は teleport spike、1人は causal intervention、1人は planner success を見ました。
どれも本当の observation かもしれません。しかし同じ capability を見てはいません。
本当のルール
7つの coordinate に分けます。
- Predictability: named actions、horizons、support で held-out latent consequence を予測。
- Decodability: 指定 readout が frozen representation から label を回収。
- Controllability: action が budget 内で predicted/executed outcome を動かす。
- Compositional generalization: familiar parts が unseen combination で働く。
- Counterfactual consistency: paired change に正しい sensitivity/invariance。
- Causal identification: explicit intervention assumptions の下で variables/relations を回収。
- Planning utility: fixed task/search contract 下で action choice を改善。
これは ladder ではなく coordinates です。1つが他を自動で与えず、positive tests の多数決も証明になりません。
random held-out episode は compositional とは限りません。本物の composition split は、parts を別の場所で残しながら start–goal、object–action、layout、phase combination を hold out します。同じ trajectory の25 steps 先 goal は有用な control task ですが、arbitrary-goal composition ではありません。
causality には named variables、valid interventions、confounder assumptions、identifying invariances、support controls、alternative structures が必要です。decodable direction と behavior-changing ablation だけでも、entangled/OOD かもしれません。
だまされる反例
familiar trajectory fragments を大量に保存する lookup navigator を想像します。同じ trajectory の future goal でよく成功します。background/time と場所が相関するので probe は position を decode します。last-frame predictor は teleport で spike します。
planning utility、decodability、VoE sensitivity は全部 positive です。しかし policy speed を randomize、background を変更し、新 layout で familiar actions を組み合わせると失敗します。
これは LeWM の説明ではありません。複数 diagnostics が同じ shortcut を共有できるという論理的反例です。triangulation は、tests の failure mode が違い、各 test が1つの alternative を狭めるときに強くなります。
よくある表現を監査します。
- “position is inside” → “この readout で position が recoverable”。
- “decoder shows imagined future” → “auxiliary decoder が predicted latent から view を reconstruct”。
- “t-SNE shows learned map” → “sampled projection が neighborhood pattern を示唆”。
- “planner understands control” → “この protocol の budgeted result”。
- “model knows teleport is impossible” → “この perturbation で mismatch が増加”。
実験のレシート
claim を5 fields で作り直します。
- capability。
- test、metric、baseline、intervention。
- model/paper version、data、environment、support、horizon、budgets、seeds。
- result と evidence level—primary method fact、author-reported、independent reproduction、tutorial observation。
- alternatives と explicit non-implications。
wording ladder も守ります。probe 後は recoverable、declared shift 後は generalizes across the tested split、matched controls 後は behaviorally implicated under this intervention。necessary、sufficient、causal、understands は対応する design/assumption があるときだけです。
LeWorldModel v3 は action-conditioned latent prediction、TwoRoom/Reacher/PushT/OGBench-Cube の budgeted planning、selected-variable probes、qualitative latent views、PushT straightening、tested teleport sensitivity の author-reported evidence を出します。frozen commit 8edfeb3 には全 analysis scripts がありません。全部を合わせても complete state、broad composition、calibrated futures、causal physics、real-world reliability、human-like understanding は確立しません。
3つのクイック質問
- 7 capabilities が stage ではなく coordinate なのはなぜですか。
- genuine compositional split は何を変えますか。
- five-field claim は “proves” を “suggests” に変えるだけより、なぜよいですか。