コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 新しい舞台pixel は変わっても物理は同じかも。
- 新しい芝居同じ画像でも goal が違うかも。
- 本物の舞台noise、delay、contact、safety が来ます。
小さなお話:ロボットの巡業
ロボットが一つの芝居を練習します。暖かい照明の下では、青い cup はいつも左へ運びます。巡業先では curtain が赤くなり、camera が動き、別の芝居では同じ cup を右へ運びます。さらに手が contact の瞬間を隠します。
変化は無害な scenery、別 task、別 physical state、見えなかった証拠のどれでしょうか。全部を “domain shift” と呼ぶと、model が必要とする答えを消します。multi-task training は shortcut を暴けますが、task ごとの tablecloth、camera、episode length という新しい shortcut も作れます。
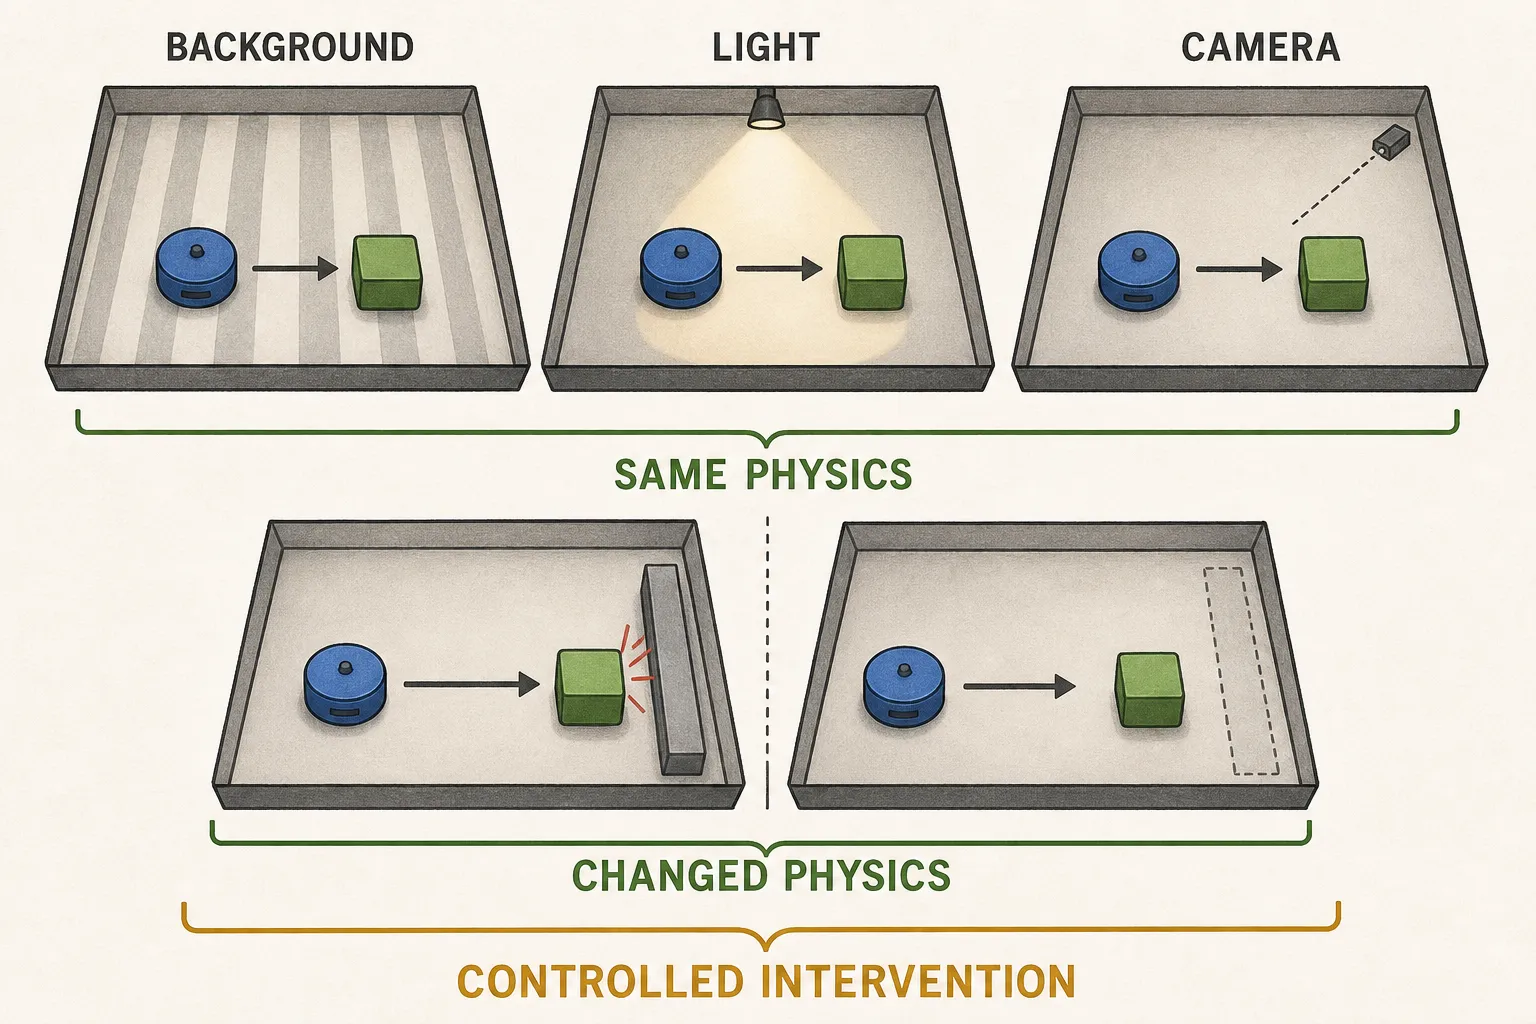
この matrix は既知の factor を一度に一つ変えます。background、light、viewpoint が常に無関係だとは宣言しません。
技術のリュック
paired control を使います。同じ simulator state と action を replay し、dynamics を変えないと分かっている texture、light、camera variable だけを変えます。次に future consequence を本当に変える positive control を入れます。すべてに invariant なら collapse、すべてに sensitive なら appearance shortcut です。望ましいのは選択的な反応で、closed-loop planning でも確かめます。
一枚の image が正しい action の異なる二 task に属するなら、current-frame encoder は省かれた task を当てられません。goal image、token、language condition を渡すか、欠けた変数が痕跡を残すなら history を使います。token は dataset-ID shortcut になれますし、history は一度も観測されない情報を復元できません。
後続 evidence は身份を保ちます。
| 後続ルート | 追加 signal / setting | 狭い境界 |
|---|---|---|
| TC-LeWM v2 | temporally centered SIGReg。from-scratch multi-view ViT-S/16 と task-conditioned flow-matching behavior cloning による multi-task LIBERO | baseline CEM/MPC、TwoRoom、robot deployment ではありません |
| Depth-regularized JEPA v1 | depth supervision と training-only overparameterization。real agricultural-robot video 上の報告 18M model | offline visual-odometry probe、surprise、latent rollout で、online planning や safety ではありません |
| PhyLatent v1 | simulator physical-state supervision | privileged training で、pixels-only recovery ではありません |
| PSG-JEPA v1 | training-only proprioceptive-state と multi-horizon joint-change grounding | 著者報告の Mobile ALOHA downstream policy evidence で、original-LeWM MPC や safety certificate ではありません |
| stable-worldmodel v1 | data、training、solver、MPC、evaluation の共通 plumbing | infrastructure は choice を見せますが、中立性や独立 reproduction を保証しません |
Original LeWM v3 は fully end-to-end のままです。stop-gradient target、EMA teacher、pretrained visual encoder はありません。後続 auxiliary head でその graph を描き替えてはいけません。大きな predictor も仮説にすぎません。parameter-matched と compute-matched の width、複数 seed、one-step prediction、self-fed rollout、action sensitivity、nuisance invariance、planning を比べます。
壊してみる
current image と action history が同じ二 episode を作ります。Task A は “cup left”、Task B は “cup right” です。instruction を隠します。一方を一貫して選ぶなら、recover した context ではなく dataset prior です。次に goal image、task token、earlier instruction frame、training で task と相関させ test で交換する background を、一つずつ追加します。
deployment では evidence ladder を上ります。original simulator → controlled visual change → sensor noise / missing frame → delayed / imperfect actuation → hardware・object・calibration variation → abort と recovery rule を持つ safety-constrained run です。一段を通っても次段の許可証にはなりません。MPC feedback は open-loop trust を短くしますが、実行した一歩を安全にはしません。
実験レシートと証拠の境界
- Source: LeWorldModel v3、TC-LeWM v2、depth-regularized JEPA v1、PhyLatent v1、PSG-JEPA v1 と project page、stable-worldmodel v1。
- 凍結 code: LeWM
8edfeb3。PSG-JEPA8de96b8、2026-08-14。stable-worldmodeladdbab4、2026-08-18。ただし formal release は 2026-06-06 の0.1.1のままです。TC-LeWM、depth paper、PhyLatent の author-linked code は未確認です。 - 日付: depth 2026-07-15、TC-LeWM v2 2026-07-31、PhyLatent 2026-08-06、PSG-JEPA 2026-08-07。証拠 cutoff は 2026-08-20、Asia/Tokyo。
- 後続結果は著者報告で、これらの method や robot result の独立 reproduction は確立していません。method、controller、data、intervention、safety protocol を正確に報告します。“real video” は “online robot planning” ではなく、“robot policy experiment” は “safe deployment” ではありません。
3つのクイック質問
- camera change が自動的に nuisance ではないのはなぜですか?
- identical-frame / opposite-task の例は missing context について何を示しますか?
- simulator robustness claim を robot safety claim にする前に、どんな新しい evidence が要りますか?