课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
全局图景
- 只指出一个故障写下预测的失败模式。
- 只改一个部件锁定数据、预算和评估。
- 保留所有结果正结果、零结果和负结果都算数。
一个小故事:什么都换了的机修师
一辆车总往左偏。机修师同时更换了轮胎、转向系统、发动机、道路地图和司机,随后车子果然走直了。其中某些改动起了作用——但这次修理几乎没有教会我们任何东西。
世界模型系统也有同样可分离的部件:数据与预处理、表示、动作条件动力学、规划代价、CEM 搜索,以及执行/评估。如果它们全部一起改变,更高的成功数字就无法告诉我们究竟是哪个想法奏效了。
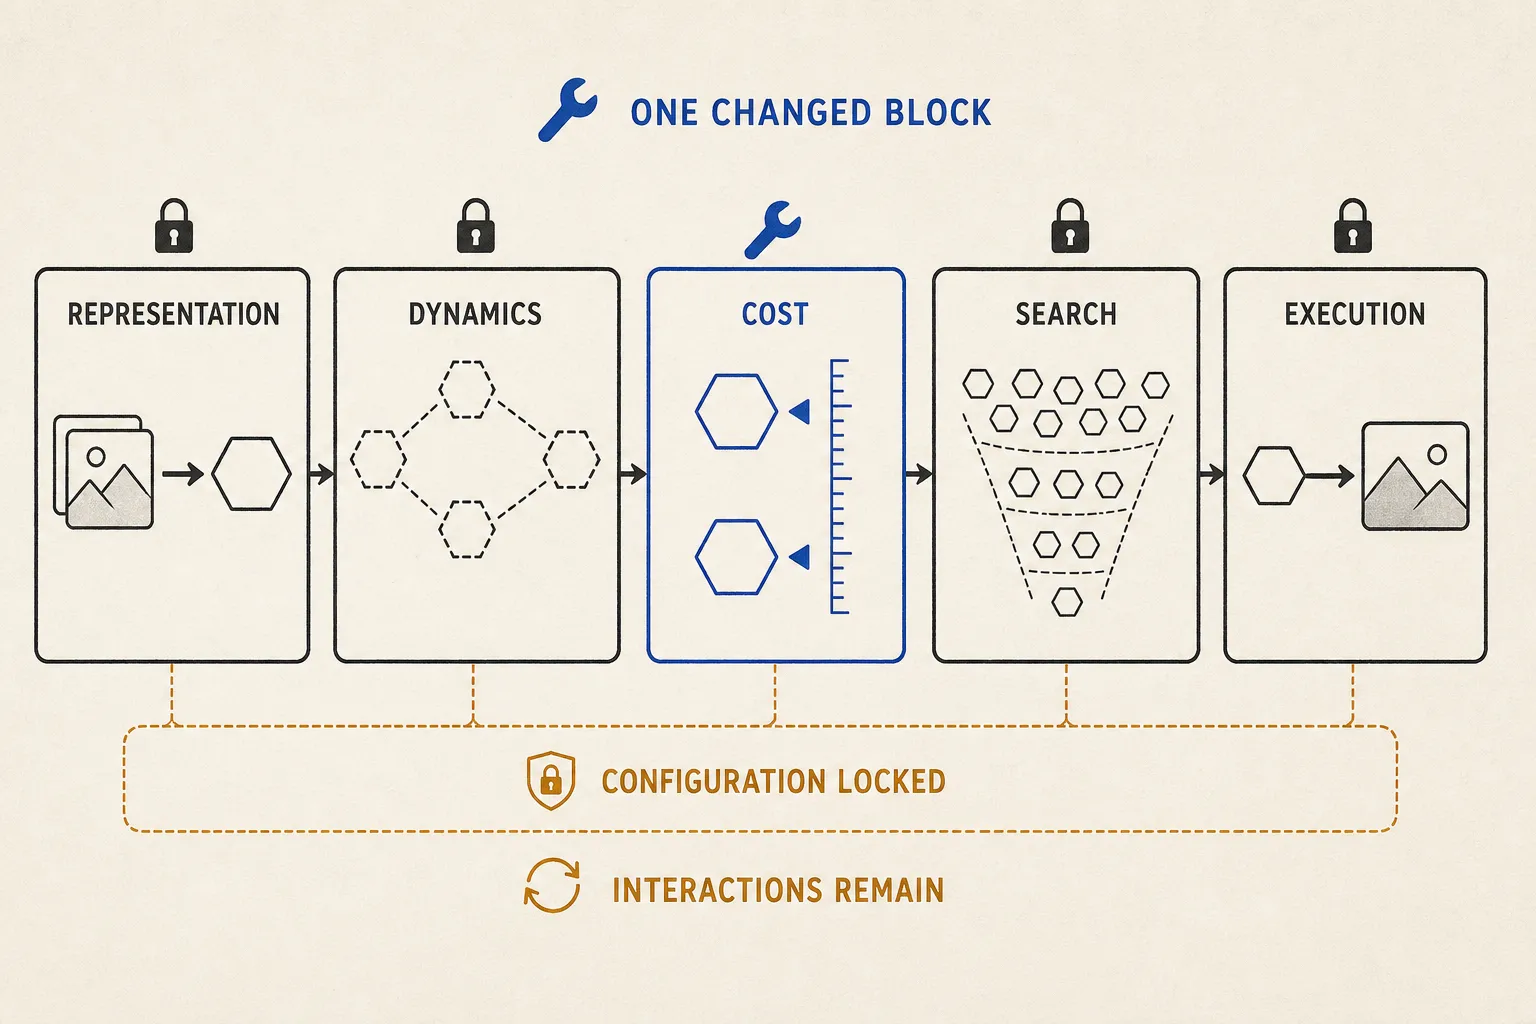
一次锁定的比较可以将声明定位到局部。它不能证明同一种修复方法在每个环境中都有效。
技术背包
在运行实验前先写下声明:
- 失败机制: 例如,终端欧氏代价把隔墙终点过分优先地排在前面。
- 预测交互: 感知可达性的代价,对隔墙目标的帮助应该大于对匹配开阔房间目标的帮助。
- 证伪条件: 拆除墙后收益仍然同样大;改用预言机动力学后收益消失;或收益只来自额外的 CEM 预算。
- 锁定契约: 数据集/哈希、预处理、编码器、预测器、检查点规则、随机种子、起点/目标、动作预算、CEM 种群/精英/细化次数、执行前缀、回合数和指标。
使用一架消融梯:基线 → 添加所提组件 → 移除该组件 → 打乱或随机化其信号 → 扫描其强度。尽可能同时匹配参数量和计算量。训练预算和规划预算是两种不同的货币;额外训练轮数不能悄悄支付更少的候选计划,额外 CEM 候选项也不能被称为表示增益。
预言机替换可以定位瓶颈:
| 动力学 | 代价 | 该单元在询问什么 |
|---|---|---|
| 学习 | 学习 | 完整系统能否工作? |
| 预言机 | 学习 | 消除滚动误差后,失败是否仍然存在? |
| 学习 | 预言机 | 更好的排序能否拯救同一个模型? |
| 预言机 | 预言机 | 在已知仿真器信息时,搜索/执行本身是否成为限制? |
预言机状态、最短路径或动力学,都是仅限仿真器的诊断工具。预言机增益表明存在提升空间,不表示所学替代物一定可以达到这一水平。
尝试推翻这个想法
使用匹配的 TwoRoom 布局:其中一个有分隔墙和门口;另一个则拆除这面墙。重复使用相同的起点、目标、候选库、模型检查点和预算。拓扑代价假设预测,改进在有墙情况下应当更大。如果这个“修复”在开放空间里获得同样的收益,它可能只是重新缩放了分数,或改变了优化过程。
报告跨随机种子和目标类型的分布,不要只报告一次最佳运行。保存代表性轨迹,并将失败分类:编码器混叠、预测对动作不敏感、自我馈入滚动漂移、错误的代价排序、CEM 未命中,或执行不匹配。零结果意味着“在这些条件下没有获得受支持的收益”,而不是“这个想法永远不可能成功”。当负结果符合预测的失败边界时,它可能是最有力的线索。
实验凭据与证据边界
- 为诊断提供动机的来源:LeWorldModel v3、RC-aux v1、TwoRoom 复现 v1、VIScore v2、ACPC v1、Objective Bottleneck v1、DA-LeWM v1 和 stable-worldmodel v1。
- 固定的公开快照:LeWM
8edfeb3,RC-auxecb4496,tinylabefa9e5d,VIScorebbb60fc,ACPC90d4276,stable-worldmodeladdbab4,发布版0.1.1。未找到 DA-LeWM 代码。 - 引用的诊断版本日期从 2026-08-10 到 2026-08-19;截止时间为 2026-08-20,Asia/Tokyo。除明确声明的 TwoRoom 重新实现外,来源评估均为作者自报。在真正有人执行之前,本文提出的实验仍是教程构造。
- 允许的结论是“在该设计内隔离”、“在锁定条件下支持该机制”,或“在此处未能改善”。应避免“证明了原因”、“学到了通用可达性”、“平台保证公平”,或“TwoRoom 确立了机器人泛化”。
三个快问快答
- 为什么同时改变表示、预测器和规划器,在科学上很薄弱?
- 四个预言机单元分别隔离了哪些不同瓶颈?
- 在拆墙测试中,什么结果会削弱拓扑解释?