コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 同じ taskstart、goal、success を固定。
- 資源を見せるdata、pretraining、parameters。
- 予算を合わせるactions、candidates、horizon、refinements。
- 分布を見せるseeds、episodes、failures。
小さなお話
3人の走者が42、48、51秒を出しました。しかし1人は短い track、1人は途中まで自転車、1人は warm-up 後に時計を始めました。数字が全部正しくても、順位は1つの競走を表しません。
world-model score にも receipt が必要です。raw latent MSE は dimension、scale、normalization、learned target に依存します。success rate は start、goal、tolerance、termination、action budget、search budget、environment version に依存します。wall time は hardware と batching に依存します。
本当のルール
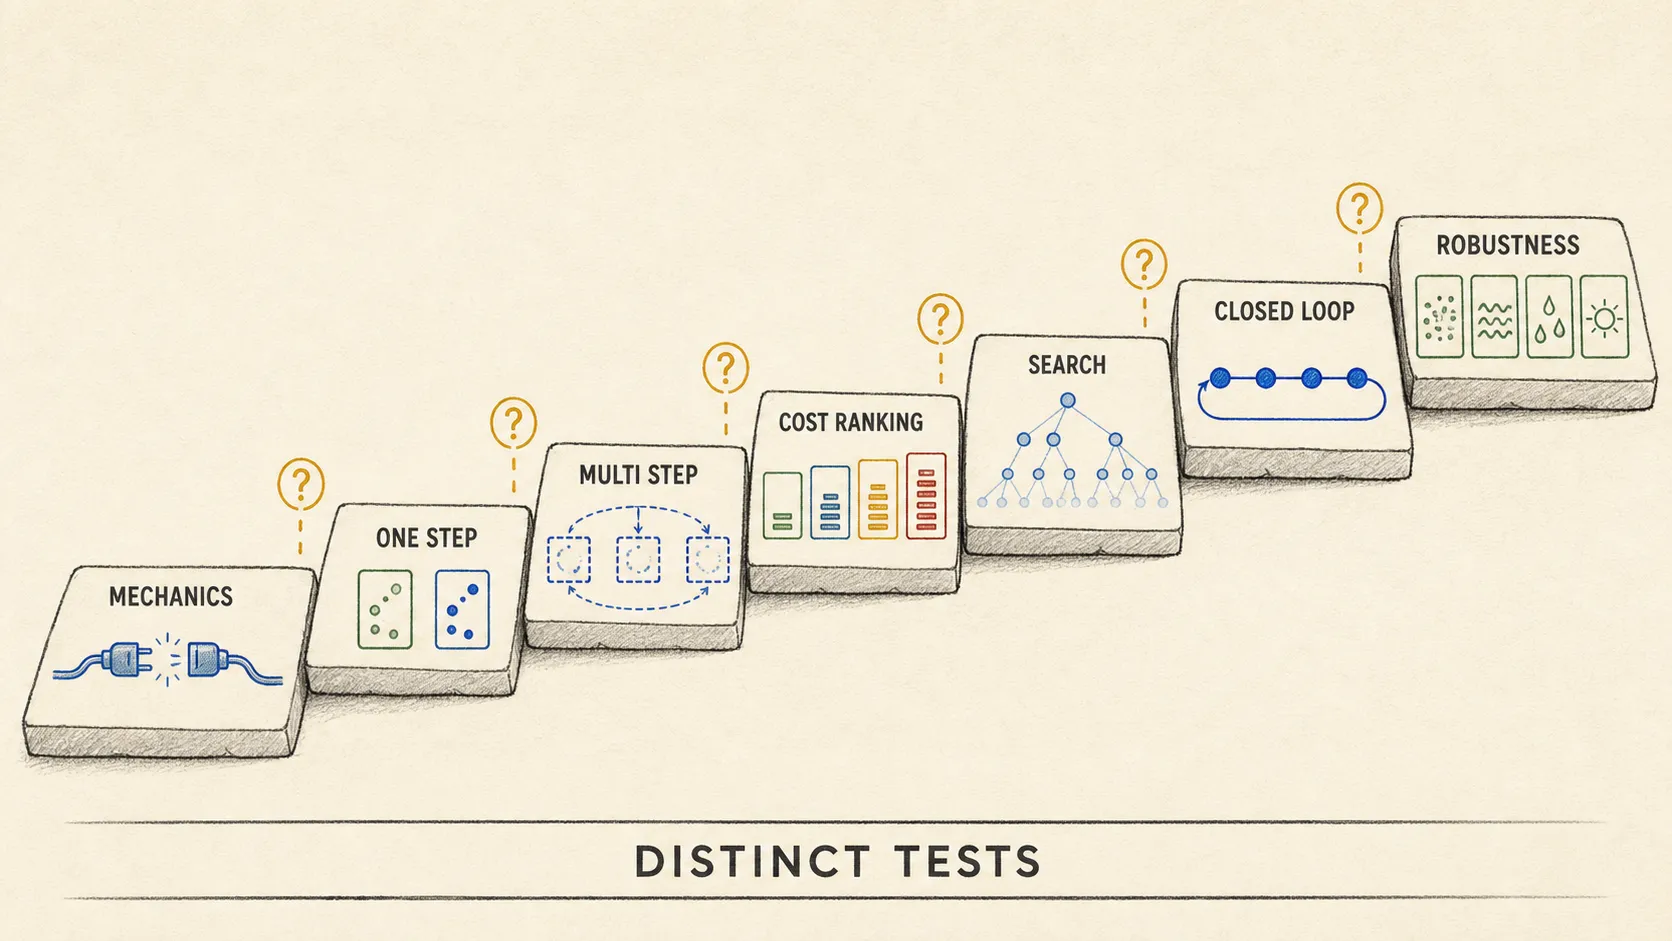
evaluation layer を分けます。
- mechanical validity と episode-safe data。
- recorded context の one-step prediction。
- fixed-action self-fed rollout を horizon ごと。
- candidate cost ranking。
- search progress。
- closed-loop control。
- robustness と support shift。
LeWM v3 は TwoRoom、Reacher、PushT、OGBench-Cube を評価します。reported protocol では offline trajectory から start を取り、同じ trajectory の25 environment steps 後を goal にし、real-action budget は50です。その behavior で到達記録がある goal ですが、任意の visual goal が解ける意味ではありません。
2つの予算を固定または公開します。environment budget は real actions、termination、replanning frequency。planning-compute budget は candidates、horizon、actions/model block、elites、refinements、model calls、batch shape、parallelism。wall time には hardware、precision、warm-up、synchronization、compilation、transfer、timed region も付けます。
比較の見方は別の問いです。matched task data、matched trainable parameters、matched task-training compute、native method settings、compute frontier のどれかを明記します。1つを抽象的に “fair” と呼びません。
だまされる反例
DINO-WM は frozen pretrained DINOv2 representation を持って task training に来ます。元の LeWM は task trajectories から visual encoder を end-to-end training します。task-training cost と upstream provenance を別々に報告します。proprioception を含む input modality もすべて書きます。
baseline は診断器です。
- random policy:偶然でも簡単な task か。
- goal-conditioned behavior cloning:直接 imitation で足りるか。
- oracle cost + learned dynamics:ranking の bottleneck か。
- oracle dynamics + learned cost:rollout の bottleneck か。
- 両 oracle + same finite search:candidate coverage/action parameterization か。
oracle は privileged simulator information を受けます。deployable competitor ではありません。
training seed、evaluation episode、planner seed を分けます。同じ50 trajectories 上の3 checkpoints は、50 independent training runs ではありません。すべての ± を SD、SE、bootstrap interval、CI、その他のどれかと resampling unit まで定義します。LeWM PushT caption は quantity を “variance” と呼ぶので、勝手に解釈し直しません。
実験のレシート
episode identity、seeds、success/timeout、final/best task distance、actions、replans、time、first failure、support slice、crash、exclusion を公開します。mean は rare catastrophic exploitation と、いつも惜しい failure を同じに見せます。
LeWM v3 は selected setup で foundation-model-based world models より planning speed が**最大48×**と報告し、figure は50 runs の平均です。歴史的 hardware receipt が不完全なので intrinsic property ではありません。
後続 VIScore v2 は Veracity、Influence、Sobriety を掛けます。著者は tested pools で cross-task Spearman correlation 0.75 以上を報告します。deterministic success prediction ではありません。constants/calibration は development runs で選ばれ、Cube は pooled calibration claim から除外され、rollout-error direction が horizon 間でおおむね安定するという仮定があります。
source claim は LeWorldModel v3、frozen commit 8edfeb3、各 baseline version に結び付けます。「誰が勝ったか」の前に「どの資源と protocol か」を聞きます。
3つのクイック質問
- 2つの encoder の raw latent error をそのまま比べられないのはなぜですか。
- planner 比較で公開すべき2つの予算は何ですか。
- oracle cost と oracle dynamics は何を別々に試しますか。