コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- frame224 × 224 pixel
- patch256個の画像片
- [CLS]1本のsummary carrier
- passport192個の数
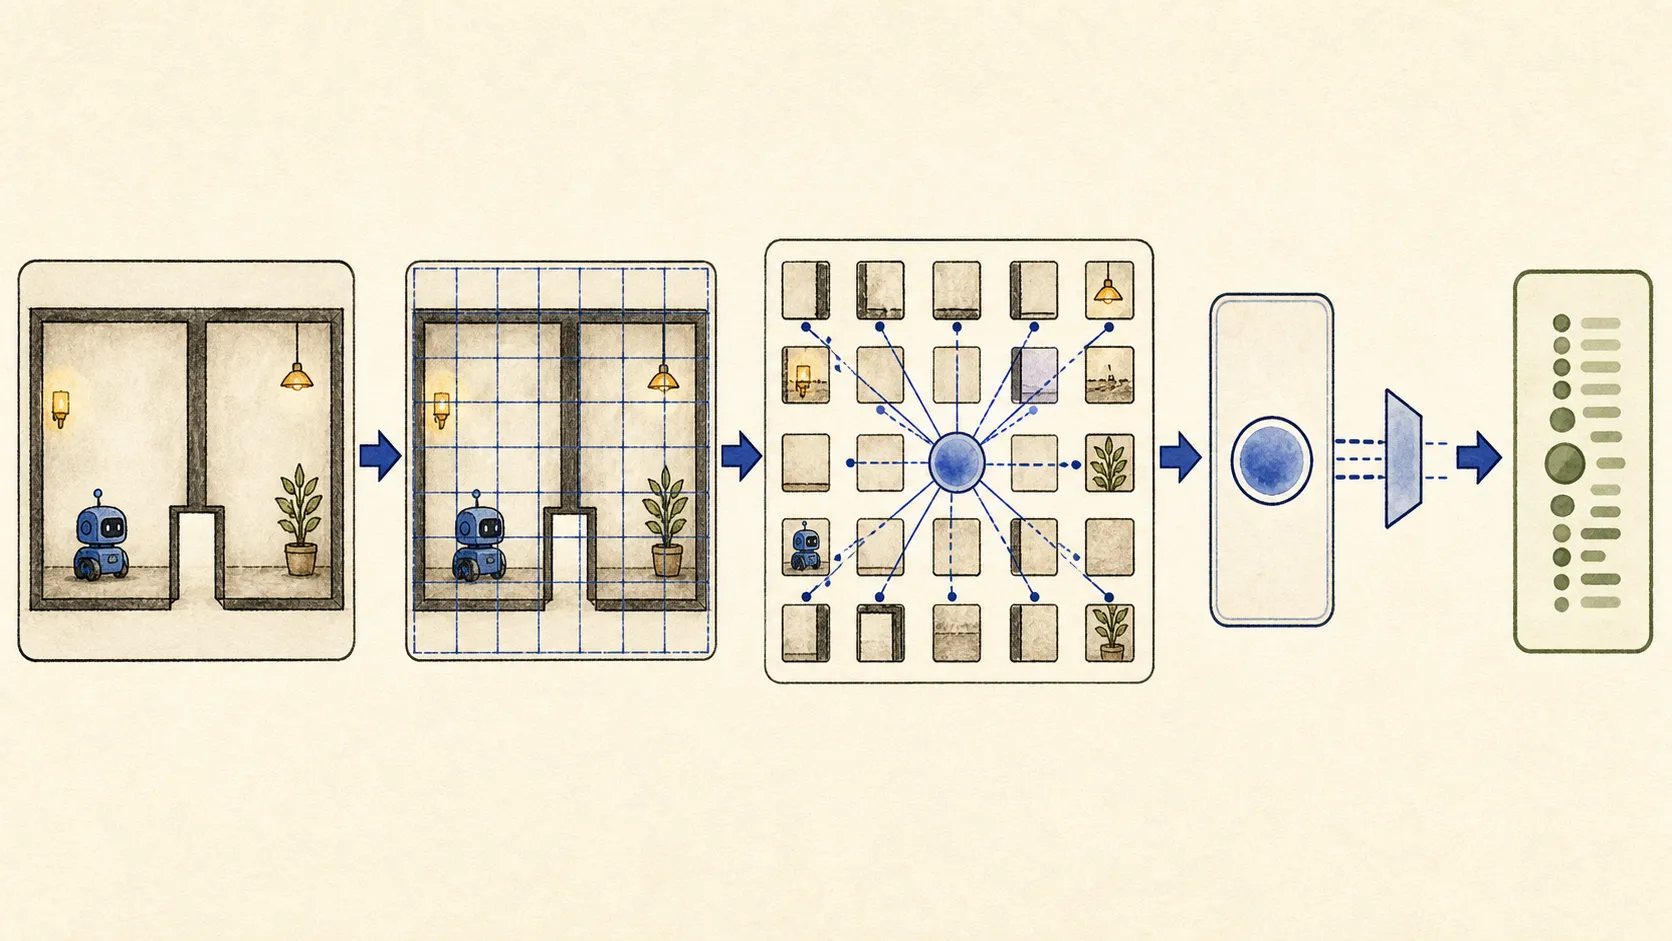
小さなお話
camera frame全体は、多数のimagined action planへ持ち運ぶには大きすぎます。そこでLeWMは各frameに小さな「state passport」を発行します。predictorはscene全体を描き直すより、passportを時間方向へ進める方が軽く済みます。
本物のpassportは、人間が必要なfieldを合意したから働きます。LeWMにはその一覧がありません。何が残るかはtraining pressureが決めます。doorwayを残すことも、doorwayと相関するだけのwall colorを残すこともあります。
技術バックパック
frozen entry pointはまずImageNet statisticsでpreprocessし、224×224へresizeします。default ViT-Tinyは画像を14×14 patchに切ります。224 / 14 = 16なので、16×16 = 256 patch tokensです。learned [CLS] tokenを1つ足してsequence lengthは257です。
default backboneはwidth 192、12 Transformer layers、3 attention headsです。attentionにより空間patch同士が情報交換できます。patchは単独で認識されたobjectではなく、[CLS]も自動的にsemanticではありません。objectiveを通じて役立つcarrierになります。
visual encoderはframeを独立に処理します。batchとtimeをflattenし、shared weightsでB×T画像を処理して、time axisを戻します。temporal reasoningは後のdynamics predictorの仕事です。
[B,T,3,224,224]
  -> [B×T,3,224,224]
  -> [B×T,257,192]
  -> [CLS]: [B×T,192]
  -> projector: [B×T,192]
  -> timeを戻す: [B,T,192]
projectorは単なるdimension reducerではありません。frozen codeはlinear layer間にBatchNormとGELUを入れ、192 → 2048 → 192と写します。paperの「1-layer MLP」とcodeの2 linear mapsは、one-hidden-layer projection MLPと呼ぶのが安全です。出力latentをpredictionとSIGRegが使います。
LayerNormは1 token内のfeatureをnormalizationします。projector BatchNormはflattenしたbatch-time examplesを横切ってfeatureごとのstatisticsを使います。SIGRegは別のpopulation lossです。「normalizationがGaussianにする」とまとめるのは誤りです。
original v3はpretrained: falseです。ViT、projector、action path、dynamicsはoffline trajectoryから一緒に学びます。
だまされる仕掛け
training中、wall colorが開いたdoorを完全に予測するとします。encoderは小さなdoor gapを無視し、colorだけ保存できます。doorを動かさず壁を塗り替えるとpassportが大きく変わり、colorを保ったままdoorを動かすとほとんど変わりません。
3つのcontrolled pairを試します。geometry固定でtextureを変える、textureを揃えてgeometryを変える、frozen planner中にnuisanceだけ替える、です。compact code、nonzero variance、良いreconstructionのどれも、正しい事実が残った証明ではありません。
mechanical assertionも大切です。timeをchannelへ変えない、time axisを戻し忘れない、1 state per frameが必要な場所へpatch-level outputを渡さないようにします。shapeは誤実装を示せますが、良い表現を単独では示せません。
実験レシート
LeWorldModel v3、固定jepa.py、model configuration、固定projection moduleがexact default pathを裏づけます。paperはResNet-18 ablationも報告するため、ViT-Tinyはbaseline choiceでありLeWMの定義ではありません。
許される主張は、[CLS]とprojectorがLeWM objectiveで最適化されるlatent carrierだということです。complete world state、BatchNormがSIGReg Gaussian targetを課す、compactだからphysicsを含む、とは言えません。
3問クイックチェック
- 1辺224 pixelとpatch size 14から、なぜ256 patchesになるのでしょうか。
- frameを独立encodeした後、timeを扱うcomponentは何ですか。
- wall colorに従いdoorway geometryを無視するpassportをどう露呈させますか。