コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- dataepisode と action は正しいか。
- state必要な違いが残っているか。
- future固定 action の rollout は道を外れないか。
- plancost、search、execution が使えるか。
小さなお話
煙探知器を試すなら、家を燃やさず、小さな煙を使います。TwoRoom はその小さな煙です。
連続した2部屋、中央の壁、1つのドア、動く agent、壁の向こうの goal があります。論文は 10,000 episodes、平均92 environment steps を報告します。noisy heuristic は、まずドアへ、その後 goal へ向かいます。data はドアを通る細い support corridor に集まり、すべての位置と action を一様に調べてはいません。
pass して示せるのは、1つの透明な environment で data-to-planning path が動いたことです。contact physics、real-robot safety、広い generalization、exact paper reproduction は示しません。
本当のルール
tuning 前に artifact と episode split を凍結します。時間順、action/image alignment、door crossing、support、frame skip、window が episode boundary をまたがないことを確認します。
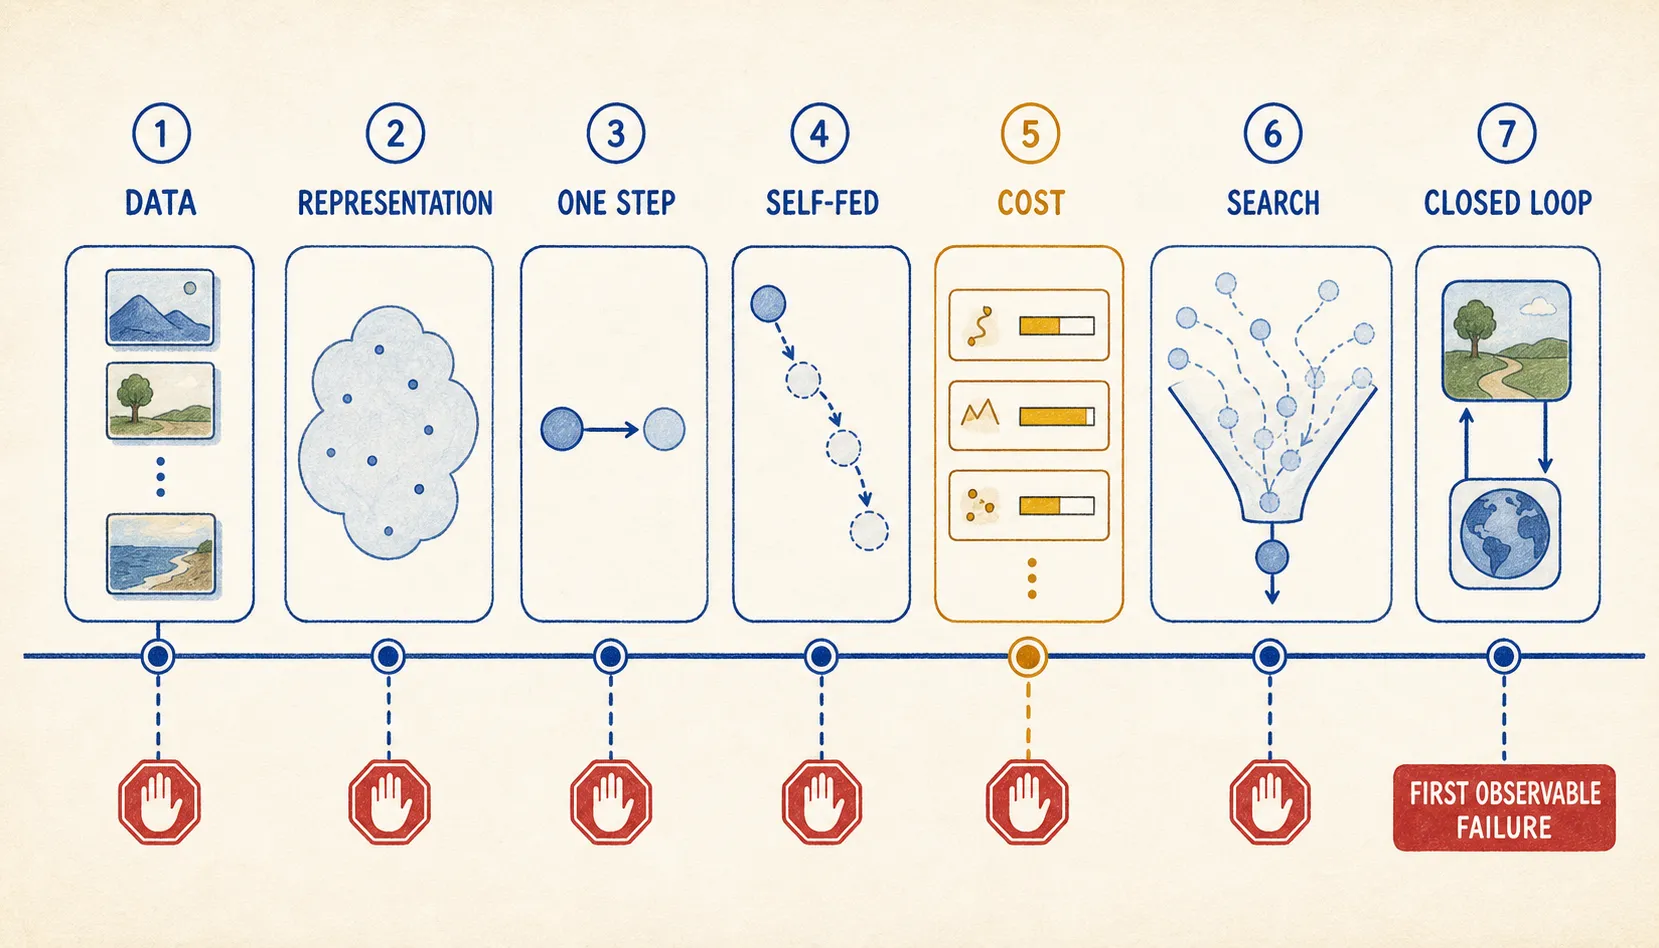
次の7 gate を順番に進みます。
- Data: episode、action、range、support。
- Representation: spread、covariance spectrum、duplicates、neighbors、action sensitivity。
- One step: held-out recorded transitions と action swap。
- Self-fed: fixed recorded actions と horizon 別 rollout error。
- Cost: candidate endpoint が分かれ、wall topology を誤順位しない。
- Search: CEM proposal と elites が本当に変わる。
- Closed loop: denormalized action が environment に届き、新観測で replan する。
最初に失敗した gate で止まり、checkpoint と episode を保存します。深い failure は共存できるので、「最初に観測できた break」は「唯一の真因」より安全です。
paper card は10 epochs、TwoRoom history 1、非 PushT CEM refinements 10。frozen-code card は maximum 100 epochs、global history 3、shared refinements 30。調査した official checkpoint も history 3 です。小さい run はよいですが TEACHING SMOKE TEST と書き、parameters、updates/epochs、batch/history、precision、device、time、data exposure を公開します。
だまされる反例
平均 one-step error が低いとします。多くの transition が open floor にあるからかもしれません。start と goal を壁の両側ですぐ近くに置くと、terminal latent distance は environment が止める直線を好む場合があります。
次の controlled replacements を行います。
- learned dynamics + oracle shortest-path cost。
- oracle dynamics + learned cost。
- 強制 doorway waypoint。
- 新しい search randomness を入れず selected actions を replay。
wall collision だけでは dynamics を診断できません。oracle-cost repair は geometry/ranking、oracle-dynamics repair は rollout を疑わせます。waypoint は topology を与えれば動けることしか示しません。action rescaling、sparse doorway data、finite search も残ります。
SIGReg も同じです。LeWM v3 は named baselines より弱い TwoRoom planning を報告し、low-diversity/low-intrinsic-dimensional data と high-dimensional isotropic Gaussian target の緊張を可能性として挙げます。因果を分離した結果ではありません。
実験のレシート
調査した official data revision は 6903a2d。frozen evaluation card は50 episodes、同じ trajectory の25 environment steps 先を goal、action budget 50、horizon と execution interval は各5 model blocks、1 block は5 raw actions です。shared solver card は300 candidates、30 elites、initial variance 1、30 refinements。(H=K=5) なので、feedback は25-step planned segment 全体の後です。
独立 TwoRoom reproduction は identical episodes 上で自分の checkpoint 94%、released checkpoint 84% を、各 config 1 training seed で報告します。3 checkpoints の one-step error は long-horizon success を順序づけません。100/150 の議論は旧 v1/v2 で、v3 は repository の 25/50 goal/budget card です。
data revision、split、checkpoint、paper/code/run cards、seven-gate traces、全 seed、正確な action unit を保存します。global latent cloud が健康でも、1本の route が成功しても、すべての場所で topology が有用とは限りません。
3つのクイック質問
- doorway heuristic は data support をどう狭めますか。
- planner-selected rollout より fixed-action rollout を先に試すのはなぜですか。
- wall collision から分かること、分からないことは何ですか。