コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 学ぶ現実の過去と次状態
- 身につけるencoder + dynamics
- 凍結するmodelは変えない
- 計画する想像とfeedback
小さなお話
昼のcontrol roomで、LeWMは記録済みの旅を学びます。現実のnext frameを見て、自分の予測と答えを比べ、encoderとpredictorを更新できます。夜は、学習済みモデルが行動選択を助けます。まだ実行していない未来は空白なので、候補未来はすべてモデル自身が作ります。
2つの部屋を混ぜると、もっともらしい誤りが生まれます。goalとCEMが入ったtraining graph、true futureを見られるplanner、あるいは不可能な経路を安く見せるためmodel weightを曲げるplannerです。
本当のルール
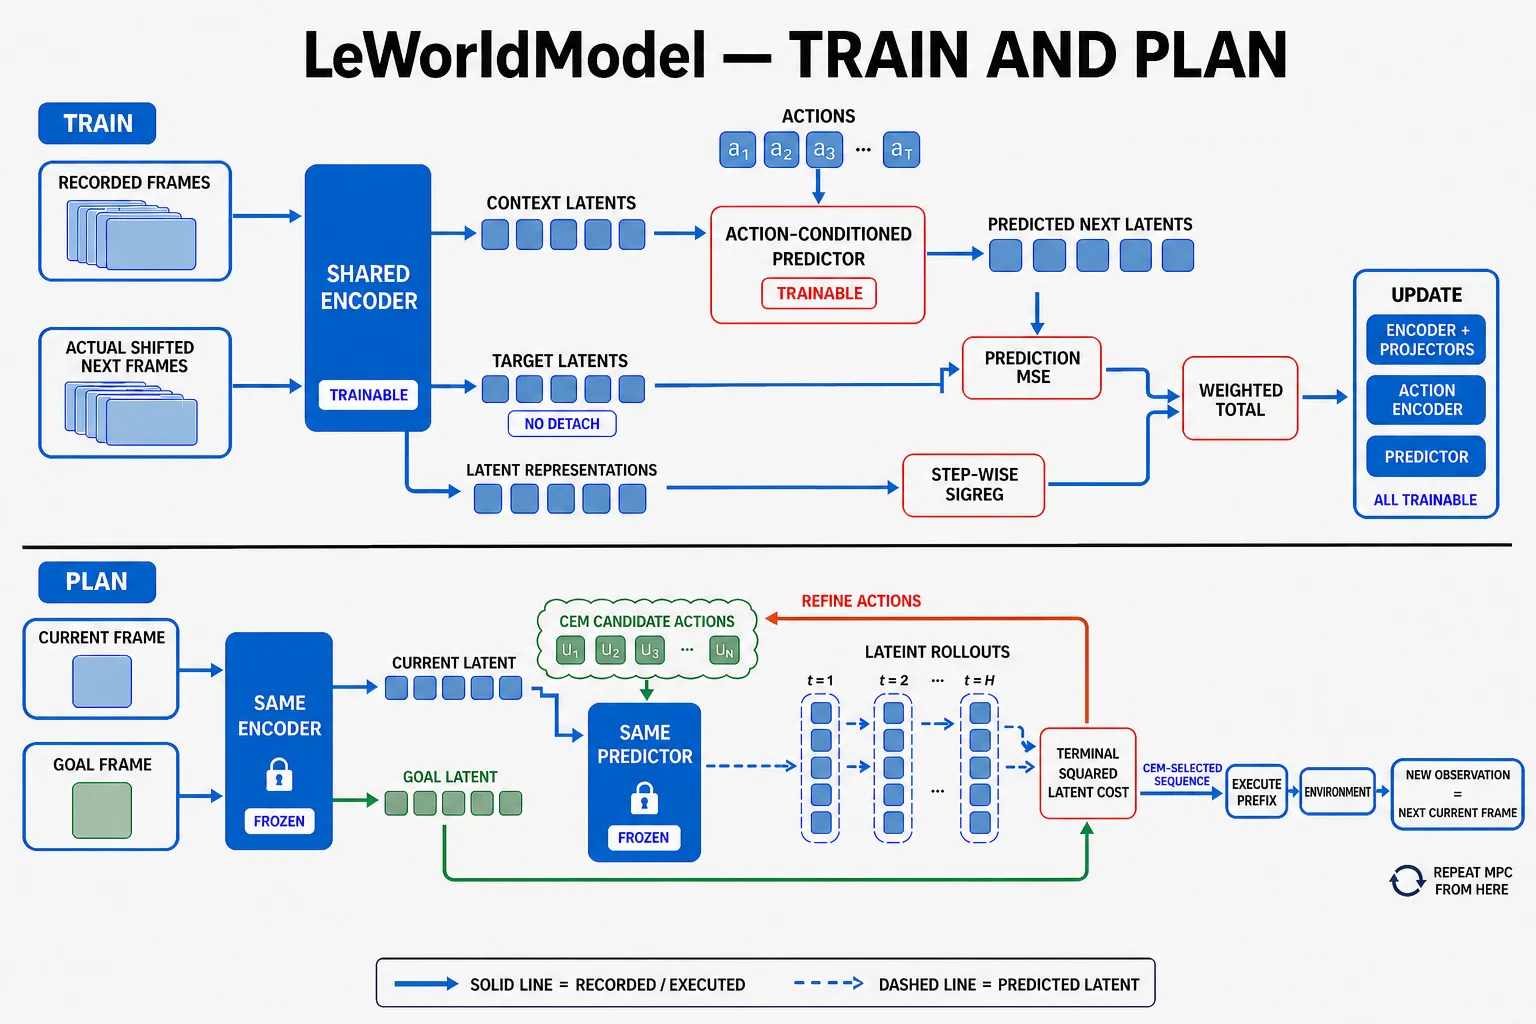
2本のlaneは、そのまま覚えられます。
TRAIN
記録frame + action -> encode -> predict
現実のnext frameのencode -> connected target
prediction loss + weighted SIGReg -> learned componentsを更新

PLAN
current + goal -> frozen encoder
candidate action -> autoregressive latent rollout -> terminal cost
CEMはaction proposalだけ変更 -> Kを実行 -> 観測 -> 繰り返す
最初のlaneには答えがありますがtask goalはありません。2本目にはtask goalがありますが、未実行行動の答えはありません。
記号では、画像は[B,T,C,H,W]から潜在状態[B,T,D]になります。引用実験の画像は224×224、frame skipは5、frozen defaultの部分軌跡は4 observation positionsです。v3 appendixはTwoRoomでhistory 1、PushTとOGBench-Cubeで3を報告し、frozen global configはhistory_size: 3、TwoRoomは上書きしません。両方のlabelを残します。
trainingではreal encoded stateがcausal contextを与えます。ここでのteacher forcingはteacher networkではありません。shifted targetはshared encoderへ接続されたままです。planningではpredictionをappendして再利用します。loggingやinferenceの.detach()はv3 trainingをstop-gradientへ変えません。
SIGRegはtraining embeddingに作用します。exact constant-code shortcutを高くしますが、planning costでもphysics証明でもありません。paper method default weightは0.1、frozen YAMLは0.09です。どちらも普遍的最適値ではありません。
だまされる仕掛け
planningでcandidate actionとworld-model weightの両方を更新したとします。terminal costはすぐ下がります。しかし行動が良くなったとは限りません。optimizerがpredictorを曲げ、endpointをgoalに似せただけかもしれません。
baseline invariantは次です。
model_parameter_change = 0
candidate_action_change = allowed
CEMが更新するのはaction distributionだけです。goal latentはdynamicsを通らず、terminal squared Euclidean costでimagined endpointと会います。paper Appendix B本文はfinal proposal meanを返し、Algorithm 2はbest sampled sequenceまたはそのmeanの最初のactionも許します。repositoryはCEMをpinされていないstable-worldmodelへ委譲するため、解決済みreturn conventionを記録します。
MPCはH model stepsを計画し、Kを実行してから観測します。報告設定はH=5、K=5、1 model stepに5 environment stepsなので、feedbackは25 environment steps後です。再計画は古い想像への依存を減らせますが、消えた壁や悪いgoal geometryは直しません。
実験レシート
LeWorldModel v3、固定train.py、固定jepa.pyは、2-lane method、connected training graph、vectorized latent rollout、terminal criterionを裏づけます。
許される主張は、LeWMがencoderとaction-conditioned predictorをprediction+SIGRegでjoint trainingし、その後modelをfreezeしてCEM/MPCがactionを探索・実行することです。CEMがglobal optimumを見つける、latent distanceがreachabilityと等しい、MPCは常に1行動だけ実行する、とは言えません。
3問クイックチェック
- trainingにはあり、未実行のplanning branchにはない情報は何ですか。
- CEM中に変わるものと、凍結すべきものは何ですか。
- frozen planningのgoal detachがtraining target detachを意味しないのはなぜですか。