コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
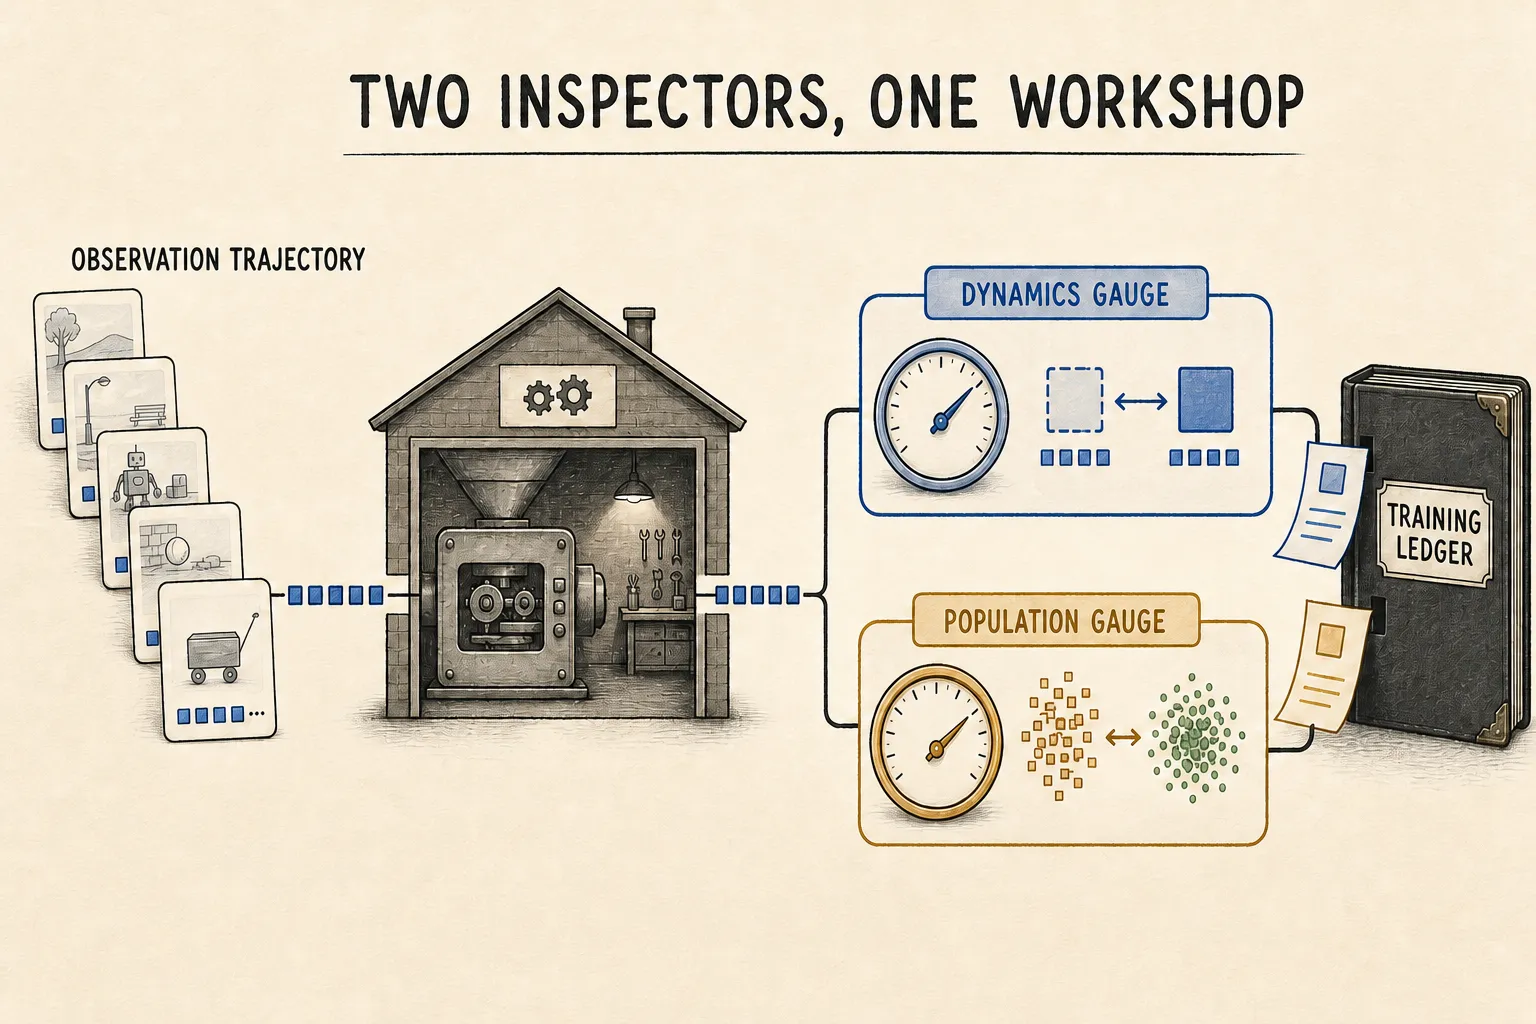
- dynamics gaugenext latentは一致した?
- population gaugecloudはcollapseした?
- lambda2 pressureを調整
小さなお話
workshopの1人目は、action-conditioned guessが、現実に次に起きたことのlatentへ一致するかを見ます。2人目はobservation embeddingのcrowdが、簡単なdegenerate shapeへ縮んでいないかを見ます。
1人目だけ聞くと、全observationを1つのconstant answerにできます。2人目だけ聞くと、cloudはきれいに広がっても、どのactionがdoorwayへ届くか忘れられます。2人は同じものを採点していません。
技術バックパック
prediction termはconnected next-observation embeddingに対するcoordinate-wise mean squared errorです。
z = shared_encoder(observation_window)
z_hat = action_conditioned_predictor(z_context, recorded_actions)
L_pred = mean((z_hat - z_next_connected)^2)
targetはshared trainable encoderが作りdetachしないため、L_predはpredictor、action path、context representation、target representationを更新できます。
SIGRegは各relative time positionのobservation embeddingへ作用します。random unit directionがone-dimensional shadowを作り、finite cosine/sine fingerprintをanalytic standard-Gaussian fingerprintと比べます。直接更新するのはvisual encoderとencoder projectorであり、action encoderやdynamics predictorではありません。
complete objectiveは次です。
L_total = L_pred + lambda * L_SIGReglambdaはpopulation pressureのvolume knobです。SIGRegの測定内容、latent width、projection count、optimizer、planning horizonを変えません。静かすぎるとtrivial shortcutが残り、大きすぎるとtransition relationよりglobal Gaussian shapeを優先し得ます。
version labelも数学の一部です。
| Source | Value | Safe reading |
|---|---|---|
| LeWM v3 method | 0.1 | paper stated default |
| frozen YAML | 0.09 | checked-in executable setting |
| PushT Appendix G sweep | 0.09付近でpeak、tested 0.01–0.2で>80%、0.5で急落 | そのsetupでのauthor report |
paperはprojection countとregularization weightを2つのintroduced settingとし、reported projection ablation後にlambdaを唯一のeffective tuning parameterと呼びます。model、optimizer、data、planner全体にhyperparameterが1つだけという意味ではありません。
frozen SIGRegは1,024 projectionsと0〜3の17 knotsを使います。batch sizeはempirical shadow内のsample数、projection countは同じsampleを見るdirection数を決めます。互いに置換できません。
だまされる仕掛け
3 matched conditionsを学習します。no SIGReg、明確にlabelしたpaper/code weight、意図的にoverwhelmingなweightです。weighted sumだけでなくraw L_predとL_SIGRegを別々に記録し、variance、effective rank、neighbor、action swap、one-step error、horizon別autoregressive errorも残します。
expected mechanismは条件付きです。SIGRegを外すとconstant agreementがobjectiveと両立しますが、1 runが必ずcollapseするわけではありません。overwhelming SIGRegはdynamicsを害し得ますが、universal thresholdはありません。spread cloudでもaction-insensitive predictionなら、global collapseではなくdynamically weakです。training gaugeが良くplanningが悪いなら、rollout、cost、searchなど後段を見ます。
実験レシート
LeWorldModel v3、固定train.py、固定SIGReg、固定lewm.yamlがtwo-term objectiveとsource-specific valueを裏づけます。LeJEPA v3はassumption-bounded Gaussian motivationであり、universal physical-state guaranteeではありません。
許される主張は、ideal Gaussian matchingがexact constant representationを排除し、predictionがtemporal/action relationを与えることです。low total lossはphysicsもplanningも証明しません。
3問クイックチェック
- 各gaugeはどのshortcutまたは性質を扱いますか。
lambdaを上げるとpopulation shapeが改善しながらdynamicsを害し得るのはなぜですか。0.1と0.09が両方正しいのに交換できないのはなぜですか。