コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 世界に名前task・data・revision
- 時計に名前tick・step・horizon
- 予算に名前train・search・evaluate
- 出典のスタンプpaper ≠ code ≠ run
小さな物語
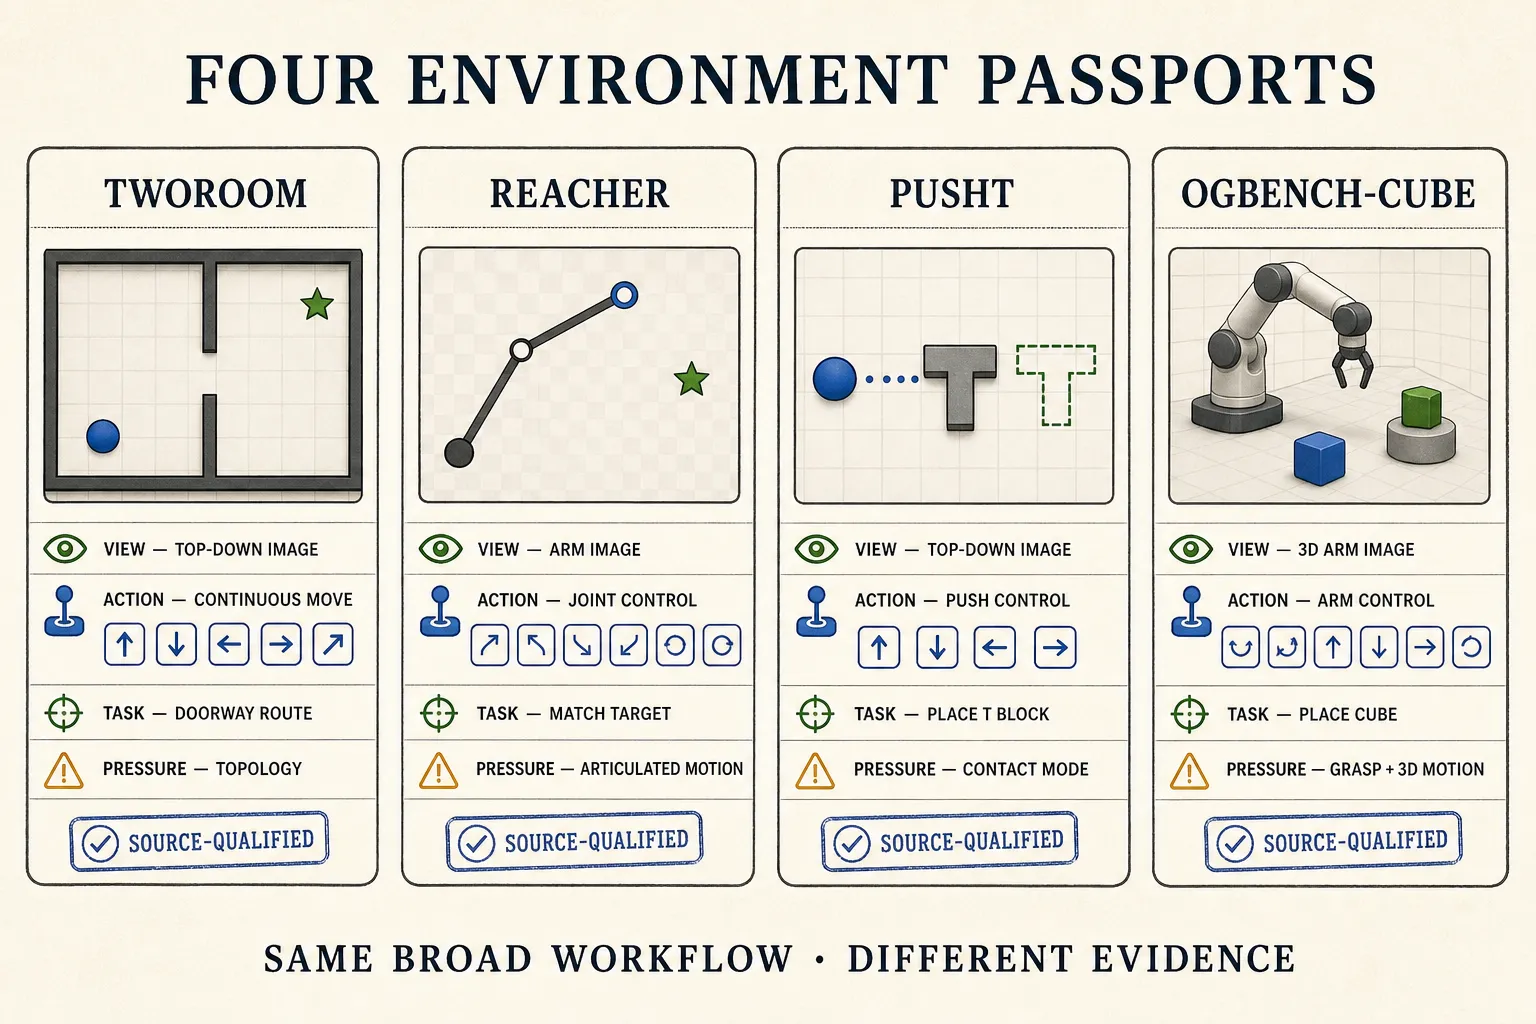
4 つの team が「世界モデルをテストした」と言います。1 つは開口部を通り、1 つは 2 関節アームを動かし、1 つは T 字を押し、1 つは cube を拾いました。文は真実ですが、比較には小さすぎます。
configuration passport には、世界、artifact、observation、action grouping、history、training、planning、execution、goal、metric、seed、compute を記録します。確認できない欄には not verified と書きます。空欄は調査を促しますが、推測値は証拠を捏造します。
configuration バッグ
4 つの benchmark passport
| 世界 | Paper カード | Frozen-code カード | 圧力と境界 |
|---|---|---|---|
| TwoRoom | 10,000 episodes、平均 92 environment steps、noisy door-then-goal heuristic、10 epochs、history 1、non-PushT CEM は最大 10 refinements | tworoom.h5、pixels/actions/proprioception、frame skip 5、global history 3、最大 100 epochs、評価 50 episodes、goal offset 25、action budget 50、horizon 5、executed prefix 5、shared CEM 30 refinements | 開口部の topology は直線潜在近道を露呈させる。簡単な 2-D sandbox は全 world modeling の代表ではない。 |
| Reacher | 10,000 episodes × 200 steps、Soft Actor-Critic で収集、10 epochs、paper history は引用文で明示的に確認できない | reacher.h5、pixels/actions/observation、frame skip 5、global history 3、swm/ReacherDMControl-v0、qpos_match、評価 50、offset 25、budget 50、horizon/prefix 5/5 | シミュレーション関節制御であり、一般的 robotics の証拠ではない。success tolerance と全環境動作には resolved platform revision が必要。 |
| PushT | 20,000 expert episodes、平均 196 steps、10 epochs、history 3、300 candidates、30 elites、initial variance 1、horizon 5、最大 30 CEM refinements | global history 3、最大 100 epochs、SIGReg weight 0.09、YAML は pusht_expert_train.lance、調査した公開 artifact/README は compressed HDF5、評価 offset 25、budget 50、horizon/prefix 5/5、frame skip 5 | contact 位置、姿勢、押せるが引けない履歴が重要。score は実 robot に移せない。 |
| OGBench-Cube | 10,000 episodes × 200 steps、benchmark heuristic、10 epochs、history 3、non-PushT CEM は最大 10 refinements | ogbench/cube_single_expert.h5、pixels/actions/observations、frame skip 5、swm/OGBCube-v0、single cube、224-pixel rendering、評価 50、offset 25、budget 50、horizon/prefix 5/5、shared CEM 30 | 3-D motion と grasping は「PushT in 3-D」ではない。privileged field は環境 goal を設定するが、オリジナル LeWM training が privileged state を受け取る証拠ではない。success tolerance は revision-bound。 |
これらの凍結カードでは、1 model step が 5 environment actions をまとめます。だから horizon 5 は 25 environment actions 分です。同じカードは、5 model steps 全てを実行してから replan します。これは 1 つの MPC timing であり、LeWM の普遍定数ではありません。
TwoRoom には version-history の罠もあります。独立再現は paper 側 offset 100、budget 150 と repository の 25/50 を監査しました。100/150 は LeWM v1/v2 の履歴で、現行 v3 Appendix F.1 は 25/50 です。その再現は TwoRoom 再実装に限定し、各 frame-skip block の全 action を集める、action-encoder input width を programmatically 導く、ImageNet pixel normalization を使う、action を z-score すると報告します。これを全 benchmark のルールにしてはいけません。
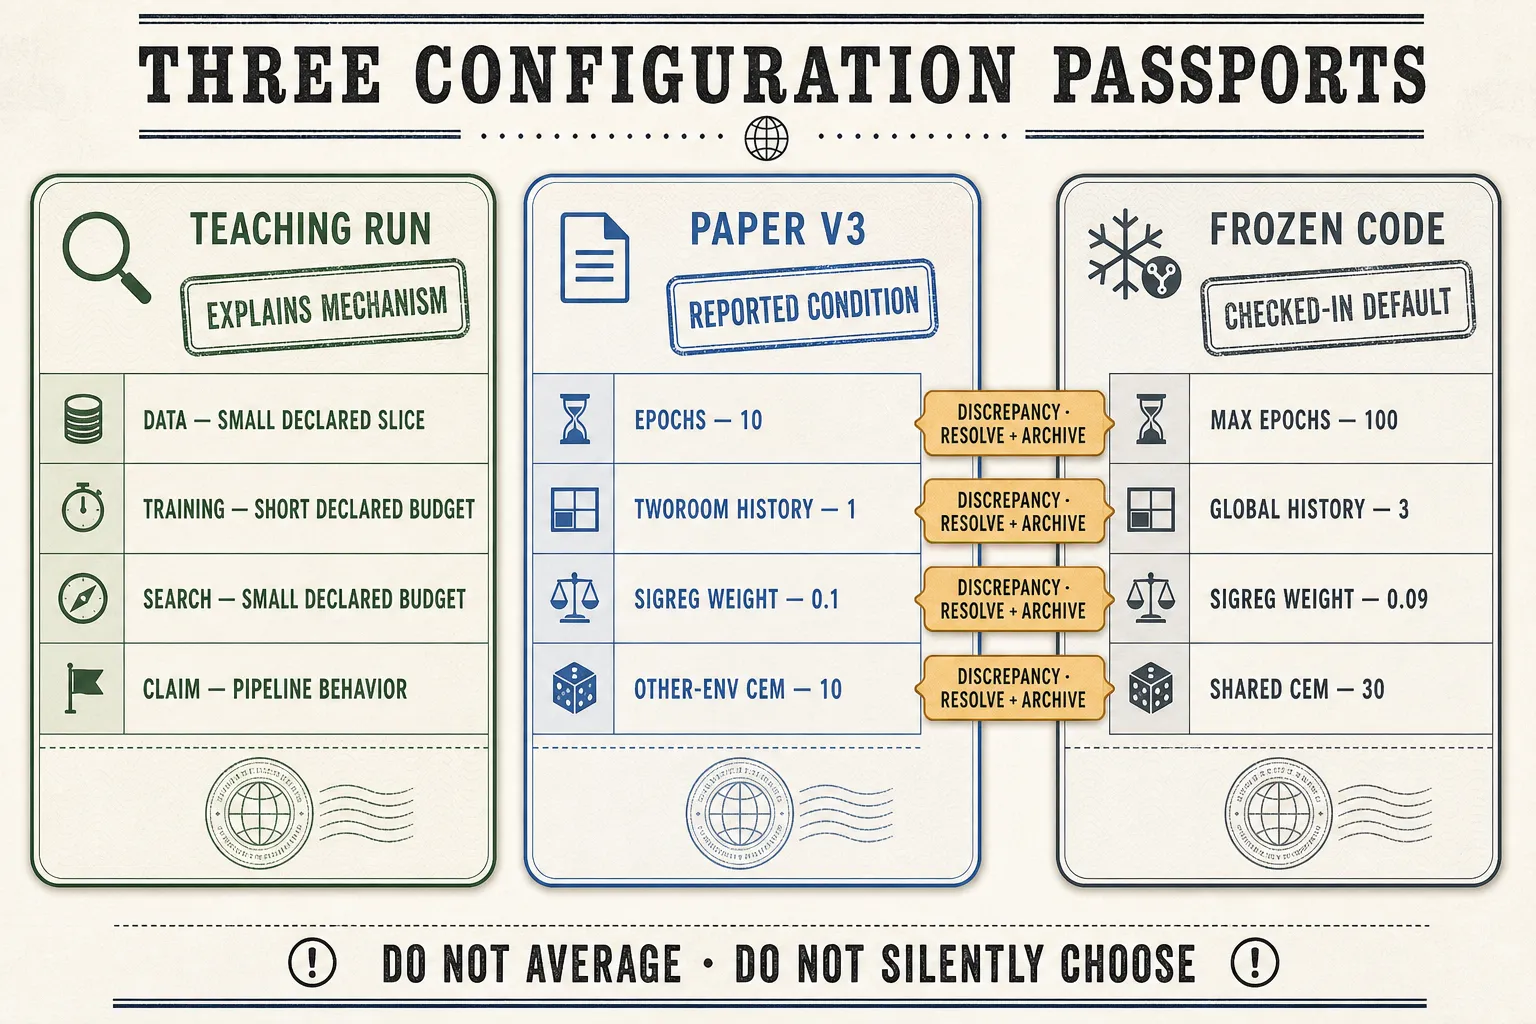
paper と code を平均しない
| フィールド | Paper v3 ラベル | Frozen-code ラベル |
|---|---|---|
| training duration | 4 つの名前付き task で 10 epochs | global maximum 100 |
| TwoRoom history | 1 | global default 3、data override なし |
| SIGReg trade-off | 指定なしの default 0.1 | 0.09 |
| non-PushT CEM refinements | 最大 10 | shared solver 30 |
| PushT data name/format | DINO-WM に従う trajectory 説明 | Lance filename、調査した公開 artifact は compressed HDF5 |
どちらかが自動的に「勝つ」わけではありません。paper は報告された条件、frozen repository はその revision が追加 override なしで解決する値を説明します。実行は 3 番目のラベル resolved run を追加し、全継承値を表示・保管します。オリジナル LeWM v3 の method card は、1 つの共有学習可能 encoder、connected target、stop-gradient なし、EMA teacher なし、pretraining なしとも言っています。変更したら run passport に書きます。
役に立つ 3 種類の run カード
Teaching run は安く透明な mechanism check です。開口部通過や多様な contact を残した episode-disjoint slice を使い、必要なら capacity や budget を短くし、action-swap、latent-spread、one-step、self-fed rollout、CEM trace、execution 診断を残します。変更欄には TEACHING と書き、PAPER とは書きません。
teaching purpose を 1 つ選ぶ
data slice、episode IDs、revisions、seed を凍結する
全 inherited value を解決する
data -> forward -> rollout -> search -> execution gate の順に実行する
resolved card を logs と outputs と一緒に保管する
Paper reproduction は、引用した task、data、history、training、model、planner、baseline、seed、evaluation を lock し、全 discrepancy を記録します。3 段階を分けます。(1) pinned artifact を読み finite output を得る、(2) locked episodes と planner budget で評価する、(3) 申告した seed で再学習し統計を比べる。段階 1 の合格は段階 3 を意味しません。Hydra は今日の config を合成できても、保管されていない過去の override、dependency、GPU stack、conversion は復元できません。
Single-GPU adaptation は最初に GPU/memory、software、precision、wall-clock、storage、latency を記録します。training budget、model-evaluation budget、planning budget を分けます。小さい batch は SIGReg の batch 統計、少ない projection は近似、短い history は情報、少ない CEM candidate/refinement は探索、短い horizon は制御問題を変えます。これらは同値な節約ではなく、変更したカードは paper score を継承できません。
だまされる仕掛け
Run A は pretrained encoder、300 candidates、30 refinements、5 seeds、same-trajectory goals を使います。Run B は end-to-end 学習、64 candidates、5 refinements、1 seed、broader-split goals です。両方とも 80% と報告します。これらは意図的な仮想カードで、オリジナル LeWM v3 の説明ではありません。
artifact、episode IDs、preprocessing、goal rule、success definition、time abstraction、model、training compute、action/search budget、seeds、statistic を lock し、名前を付けた 1 因子だけを変えます。score が同じでも mechanism の一致は証明できません。rollout、cost ranking、failure distribution を見ます。
実験のレシート
LeWorldModel v3 の Appendices D–F と、凍結した 公式コード 8edfeb336732b5f3ce7b8b210d0ba370a09e2cac が paper/code カードを支えます。TwoRoom independent reproduction v1 とその tinylab artifact が支えるのは、そこで明記された TwoRoom audit だけです。証拠カットオフは 2026-08-20、Asia/Tokyo です。
許される主張は、4 task が広い pipeline を共有しながら、異なる圧力、provenance、出典限定の設定を持ち、記録済み paper/code discrepancy があることです。complete-suite の独立再現、普遍 hyperparameter、score transfer は確立していません。
3 問だけ確認
- paper、frozen-code、resolved-run の history を、なぜ別々の箱に保つべきでしょう?
- 引用した frozen timing で、5 environment ticks、horizon 5、executed prefix 5 はどう関連しますか?
- 2 つの同じ success rate を比較可能にする前に、何を lock すべきでしょう?