コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 現実から開始本物の history を符号化。
- 予測次の latent を作る。
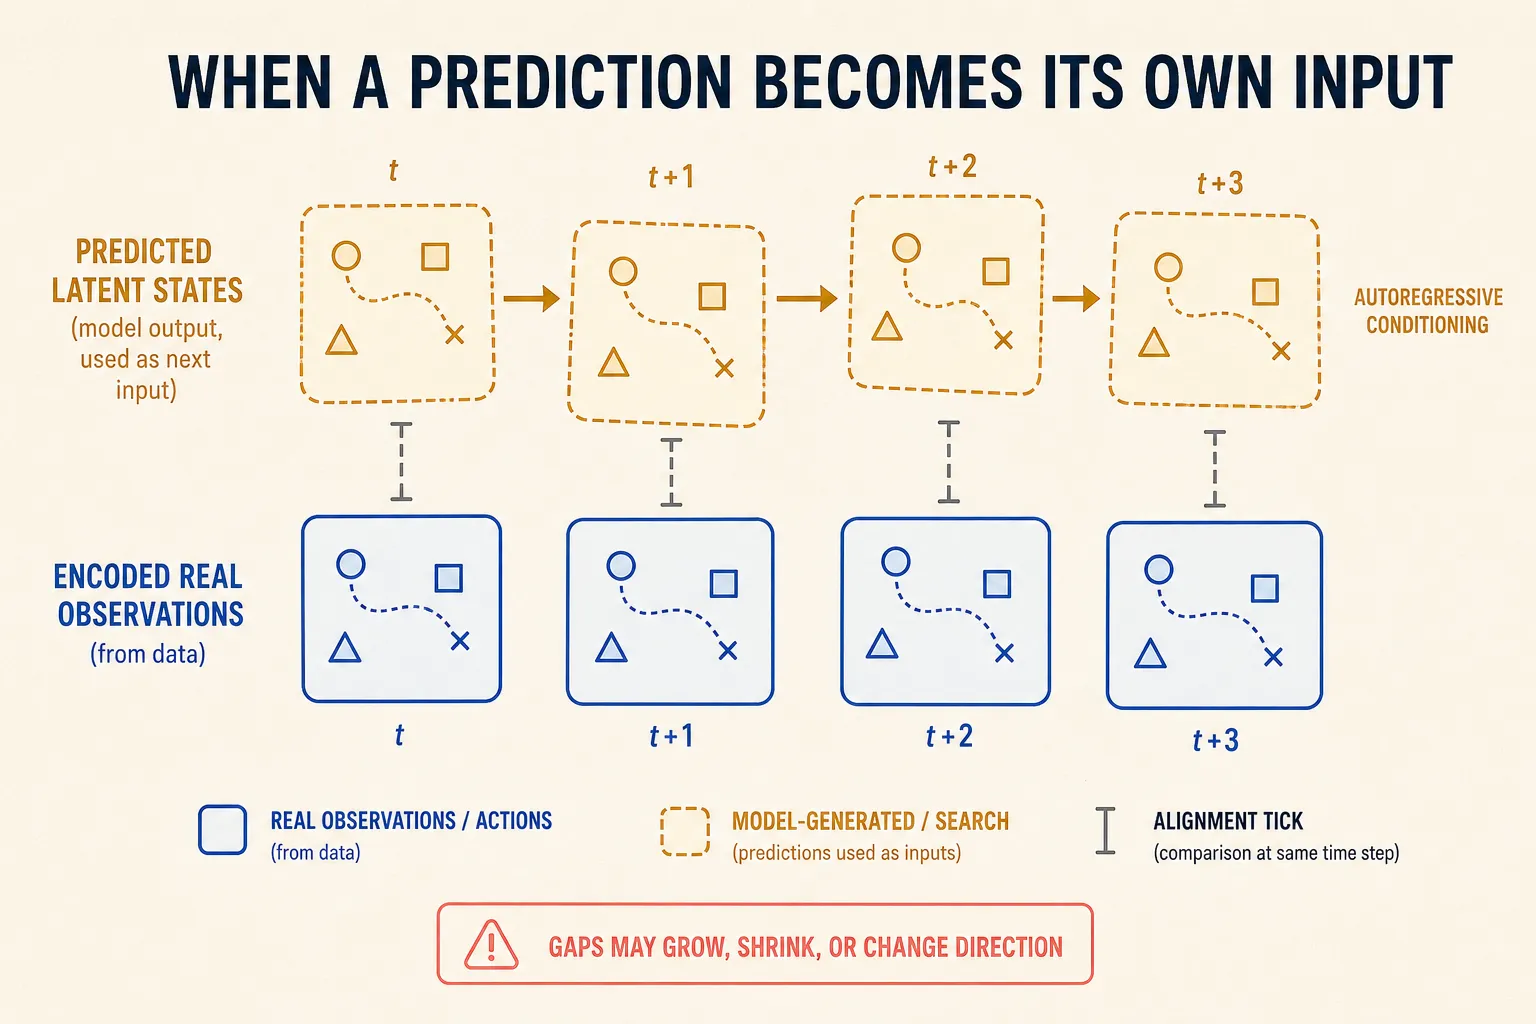
- 戻す予測を次の context にする。
- 測るhorizon ごとの drift を追う。
小さなお話
絵を1回コピーしただけなら、ほとんど同じに見えます。そのコピーを何度もコピーすると、小さなゆがみが大きな違いになります。
LeWM の rollout は autoregressive です。最初は現実の観測を符号化した状態から始まりますが、後の予測は前に予測した latent を context に使います。training や one-step test は、長い planning rollout より多くの real context を見ます。これが train–rollout context gap です。
ただし、誤差がいつも滑らかに増えるとは限りません。dynamics はずれを増幅、回転、相殺、減衰できます。指数的・単調と決めず、実際の曲線を測ります。
本当のルール
同じ held-out episode と同じ recorded action sequence で、2本の lane を作ります。
- Recorded-context lane: 毎 step、本物の observation を符号化し直す。
- Self-fed lane: 最初の history 後は、prediction を次の prediction に戻す。
各 predicted latent を、そのとき本当に来た observation の frozen encoder latent と比べます。endpoint だけでなく model horizon ごとに plot し、door crossing、contact onset、contact loss、action magnitude、empirical support に分けます。
元の LeWM v3 が出すのは1つの latent estimate です。calibrated confidence も possible futures の distribution も出しません。deterministic output は、世界が確実だという意味ではありません。
one-step accuracy は大切ですが、答える範囲が小さいだけです。recorded-context prediction がよくても、self-fed rollout、terminal cost、execution adapter が悪いことはあります。
だまされる反例
CEM の仕事は predicted cost が低い候補を見つけることです。data support の外で model が楽観的になる行動列が1つあれば、候補や refinement を増やすほど、その穴を上手に見つける場合があります。
すべての失敗を model exploitation と呼ばず、次を試します。
- action sequence bank を固定する。
- imagined cost と実行した real outcome を比べる。
- action support と horizon をラベルする。
- model、task、real-action budget を固定して search budget だけ増やす。
predicted best cost は改善するのに、選ぶ列が support から離れ、real outcome が対になって悪化するなら exploitation が有力です。最後の crash だけでは dynamics、cost、search、support、execution を分けられません。
oracle cost で順位は直るのに endpoint がずれるなら dynamics を調べます。oracle dynamics でも learned cost が悪い道を選ぶなら、cost または representation geometry を調べます。短い horizon は rollout depth を減らしますが、壁越しを好む定規は直しません。
実験のレシート
checkpoint、前処理、最初の real history、aligned recorded actions、action-block semantics、teacher-forced/self-fed latents、horizon 別 error、support labels、全 seed を保存します。最後の醜い frame ではなく、最初の qualitative divergence を印します。
根拠は著者 commit 8edfeb3 の rollout と LeWorldModel v3 の limitation です。model exploitation には隣接研究 Model-Based Planning with Energy-Based Models もあります。
独立 TwoRoom 再実装 は、1環境・各 config 1 training seed の3 checkpoints で、one-step error は short-horizon success の順を作るが long-horizon success の順は作らないと報告しました。原因は未検証で、普遍的 drift や exploitation の証明ではありません。
3つのクイック質問
- recorded-context と self-fed prediction では何が変わりますか。
- 1つの deterministic latent が calibrated certainty でないのはなぜですか。
- model exploitation を有力にする、対になった変化は何ですか。