コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- エピソードを守る有効な窓が先
- 全軸に名前意味を保つ reshape
- 経路ごとに試験mask・行動・勾配
- 航海を保存状態とレシート
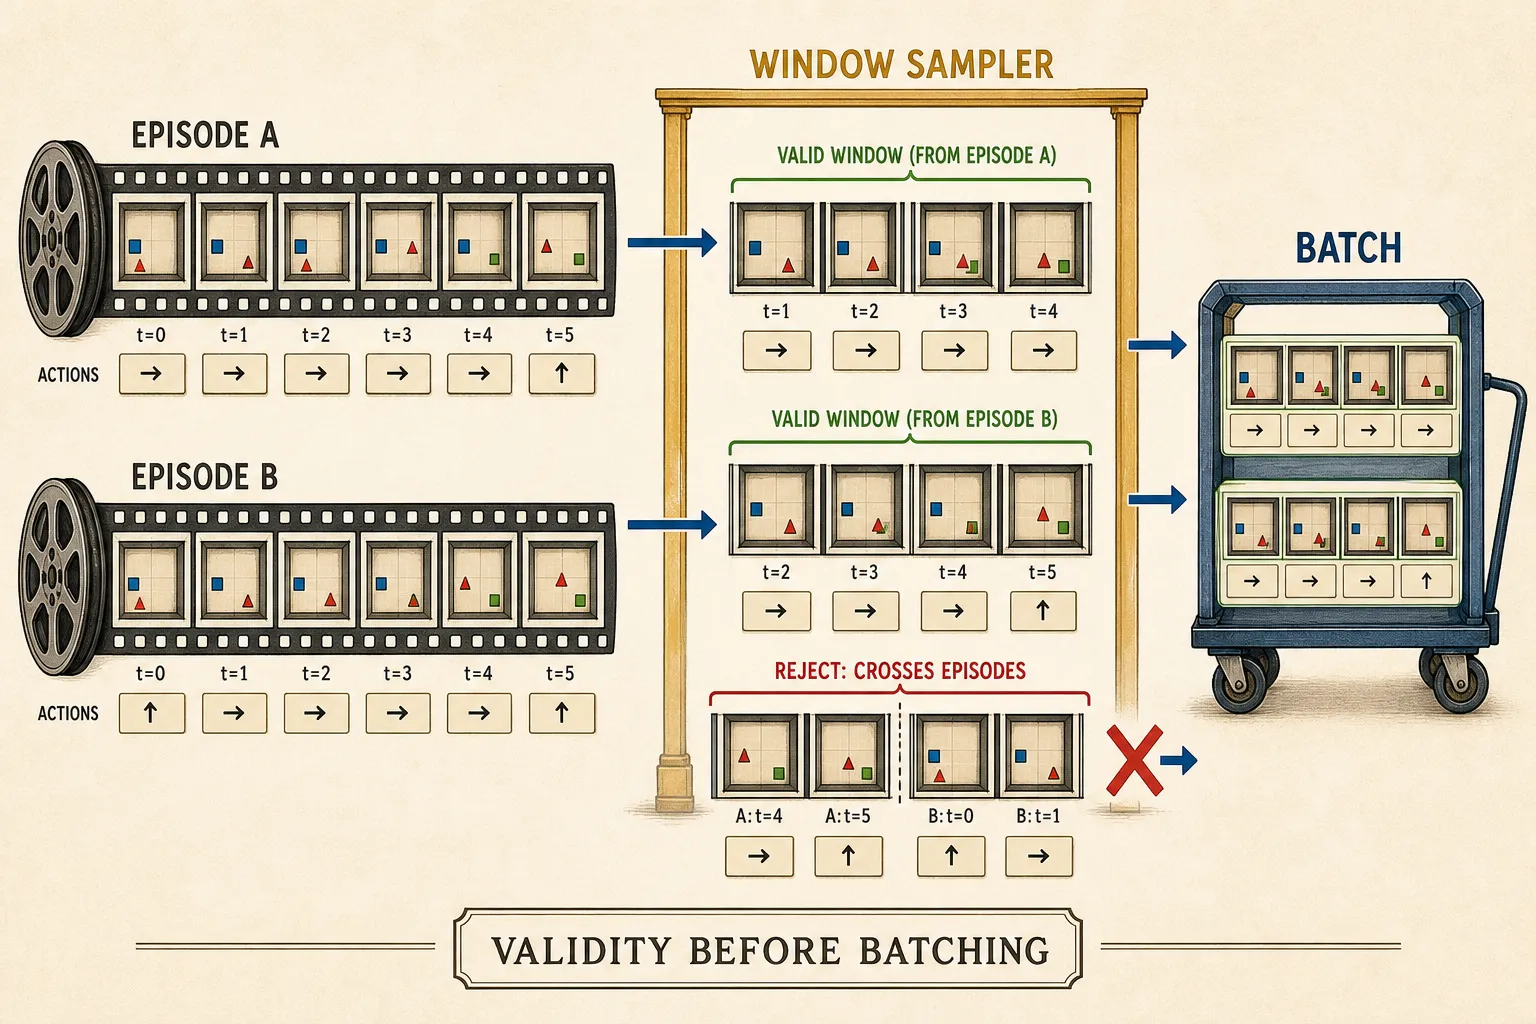
小さな物語
PyTorch を、とても速い手荷物システムだと考えてみましょう。渡したものなら、バッチ化も reshape も broadcast も行列積も高速に実行します。でも、隣の 2 フレームが別のエピソードに属することや、一方の H が画像高さで、もう一方が計画ホライズンだとは知りません。
この付録は公式実装の行ごとの代用ではなく、コックピット用カードです。問いは一つだけです。高速なテンソル操作の後にも、どの不変条件が真であるべきか?
技術バッグ
データと shape の契約
Dataset は「417 番目のサンプルは何か」に答え、DataLoader はそれらをスケジュールしてバッチ化します。データセットまたはサンプラが、エピソード所属、時間順序、行動の対応、窓長を守らねばなりません。ローダーは窓全体を shuffle できますが、窓内のフレームを混ぜて遷移を捏造してはいけません。
保存形式は科学的な同一性ではありません。HDF5、Lance、フォルダ、動画が同じ軌跡契約を運ぶこともあれば、同じ HDF5 同士でも前処理、split、frame skip、行動対応が異なることもあります。コンテナと契約の両方を記録します。
Transformer を呼ぶ前に、言葉の搭乗券を作ります。
batch = 独立した例
time = 順序のある潜在位置
feature = 学習した座標
visibility = この位置は自分と過去だけを読める
サイズが等しいことは役割が等しい証明ではありません。候補数と時刻長がどちらも 4 なら、入れ替えても表示 shape は同じです。捨ててよい小さなテストで、エピソード・時刻・候補の識別子を reshape の前後に追います。
mask と行動条件付け
causal mask は未来 token への直接の覗き見を遮ります。後の context token を変えて、前の出力が変わらないか確かめます。合格が証明するのは計算上の可視性ルールであり、因果物理の発見ではありません。
AdaLN は shift、scale、gate の変調を通して、行動が Transformer block に入る経路を作ります。凍結実装では最終変調生成器が zero initialization で中立から始まります。これは学習後のモデルが行動を使う保証ではありません。潜在 history を固定し、重要な行動を入れ替えて予測を調べます。
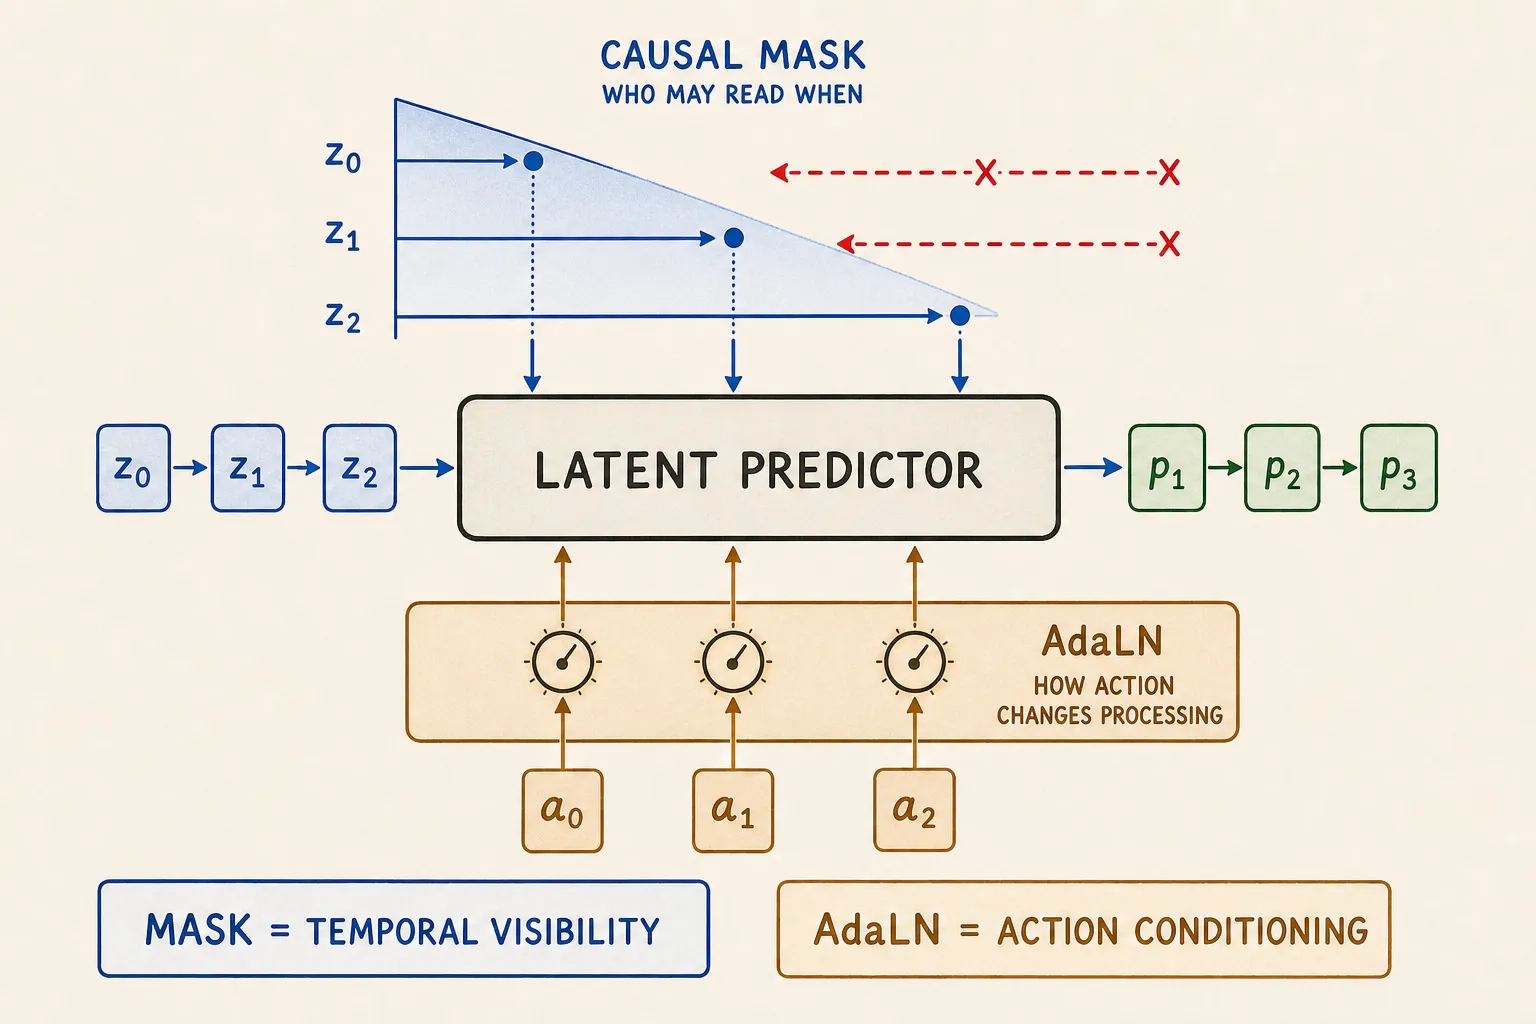
オリジナル LeWM v3 は 1 つの共有された学習可能な視覚エンコーダを使います。シフトした次観測ターゲットは接続されたままで、stop-gradient、EMA teacher、事前学習済み凍結エンコーダはありません。ターゲットを detach した再実装は、forward shape が同じでも別の学習システムです。
SIGReg の参照経路
凍結 SIGReg 実装を 5 部屋として読みます。
投影された観測埋め込みを集める
時刻位置は分け、各位置をバッチ越しに見る
ランダムな 1 次元方向をサンプルする
経験的 fingerprint と解析的な標準ガウス fingerprint を比べる
差を学習可能な penalty に平均する
バッチと時間の flatten は、集団への問いを変えます。device 越しの gather は経験集団を変え、凍結 LeWM class は明示的に single-GPU です。埋め込みの detach は勾配を変えます。結果を p 値と呼ぶと役割が変わります。有限の方向、ミニバッチ、積分点による近似であり、ガウス性証明ではありません。
rollout と CEM の経路
候補計画は GPU 上で横並びに評価できます。ただし、各候補内の時間は自己回帰です。2 ステップ目は 1 ステップ目の予測状態を受け取ります。環境バッチ、候補、モデルホライズン、潜在幅を分けます。
現在の行動提案から行動列をサンプルする
凍結した世界モデルで候補を rollout する
終端潜在を符号化した goal と比較する
設定された elite 行動列を選ぶ
行動提案だけを再適合し、繰り返す
elite index は、その score を得た行動列を指し続ける必要があります。CEM が変えるのは提案で、エンコーダや予測器の重みではありません。ベクトル化は実行を速めますが、時間依存やモデル drift は消しません。
精度、checkpoint、再現性
mixed precision は演算の実行方法を変えますが、予測損失や SIGReg の科学的定義は変えません。非有限値を監視し、短い full-precision smoke run と比較します。bit 単位の一致ではなく、不自然な scale や不安定な累積経路を探す対照実験です。
重みファイルは inference に使えます。学習再開用 checkpoint なら、optimizer、学習位置、合成後 configuration、変化中の scheduler や gradient scaler も特定します。必要なら RNG 状態を保存し、なければ欠落を明記します。データ同一性、code revision、hardware/software、precision、窓、予算、checkpoint 選択、planner、goal、seed、評価 episode も記録対象です。
同じ data と preprocessing
同じ model、optimizer、training budget
同じ planner と evaluation budget
同じ episode と goal rule
score を読む前に、意図した全ての差を申告する
だまされる仕掛け
2 つの研究室が、同じ commit、configuration、seed、checkpoint、GPU を使い、loss が完全に一致しました。その後、両方の sampler が、ある episode の最後の観測と次の episode の最初の行動を組にしていたと分かります。bug は完全に再現可能でした。
繰り返しが確認するのは手順であり、その意味の正しさではありません。episode 境界、1 ステップ shift、causal 可視性、行動感度、勾配の受け手、候補の同一性、世界モデル学習と計画の分離を挑発的に試します。
実験のレシート
PyTorch documentation と Hydra documentation が framework の抽象を定義します。LeWorldModel v3 と凍結した 公式コード 8edfeb336732b5f3ce7b8b210d0ba370a09e2cac が調査した graph と interface を定義します。stable-worldmodel は、その後の現行 platform についての証拠だけで、オリジナル v3 に遡って適用できません。
許される主張は、記録した configuration の下で、データ、shape、条件付け、rollout、最適化、精度、回復の名前付き不変条件を守ることです。loader が episode を理解する、causal mask が物理を発見する、AdaLN が行動使用を保証する、mixed precision は常に無害、1 seed で再現性が証明される、とは言えません。ここで独立再現は確立していません。
3 問だけ確認
- episode 境界を越える窓は、どの層が拒否すべきでしょう?
- 後の token を変えるテストは何を証明し、何を未解決に残しますか?
- CEM のラウンド間で変わるのは何で、どの model 部品は凍結しますか?