コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 予測するnext latent
- encodeする現実のnext
- 測るcoordinate gapをsquare
- 忘れないlocal rulerだけ
小さなお話
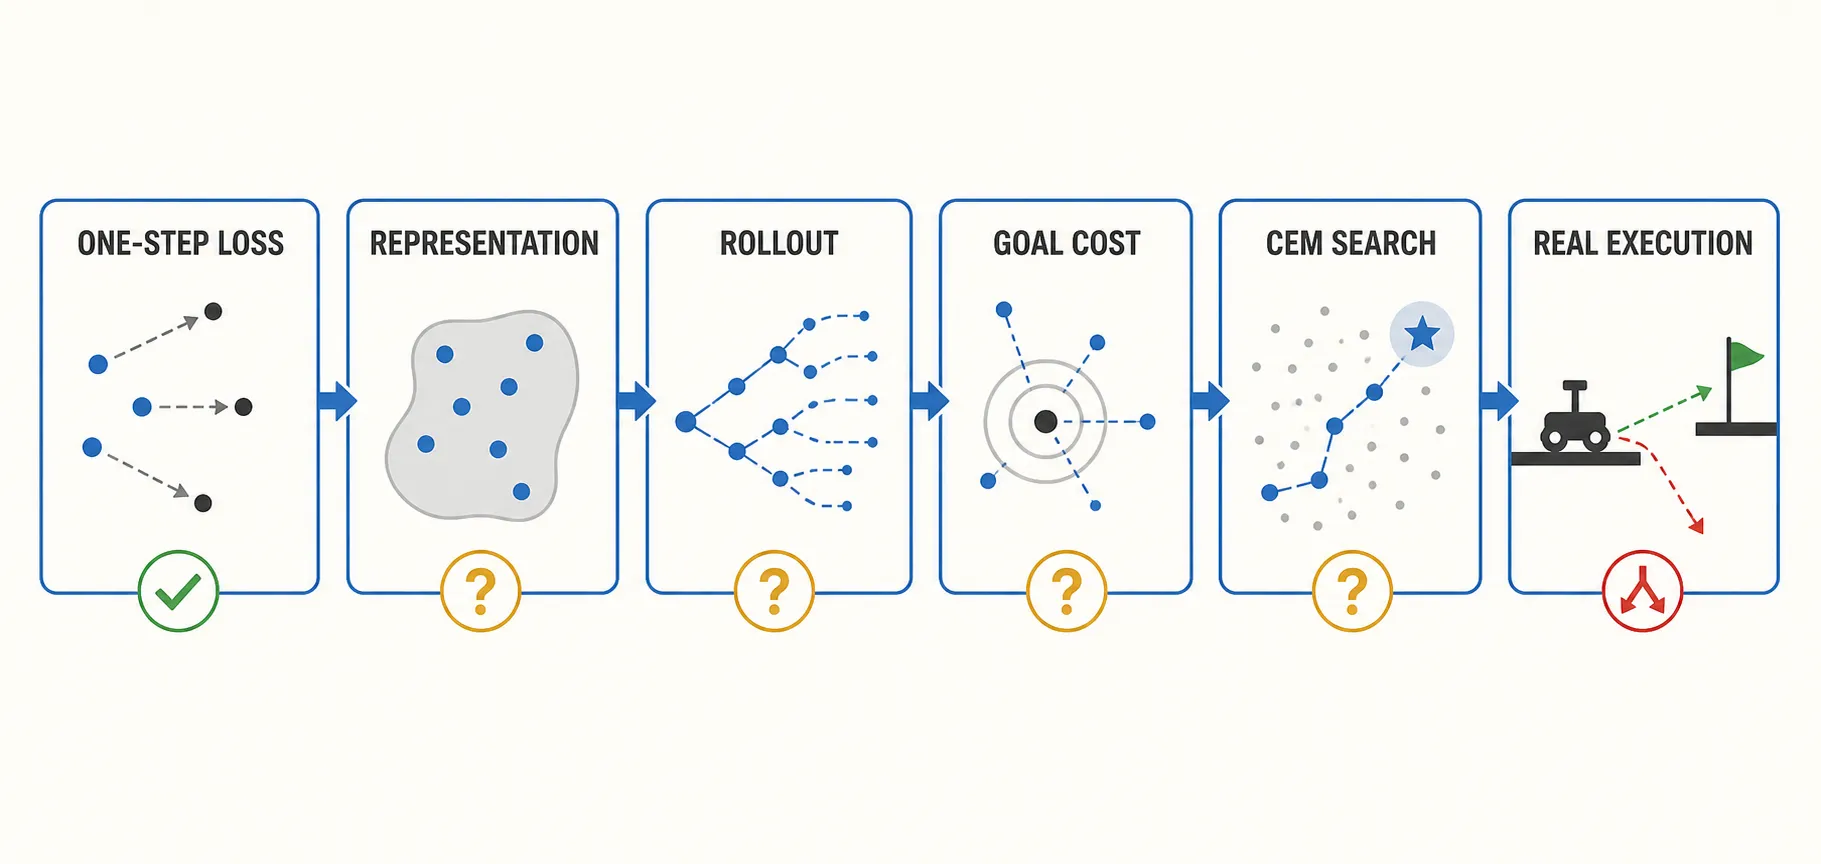
運転練習で個々の曲がり角を正確に曲がれても、街全体では誤ったrouteを選ぶことがあります。LeWMのprediction lossは1つのlocal turnを測る定規です。next latent guessが、shared encoderによる次のrecorded observation表現へ近いかを見ます。
この定規は不可欠です。なければpredictorがrecorded transitionへ従う直接理由がありません。ただしcoordinateは学習されたもので、meter、degree、velocityではありません。
技術バックパック
frozen implementationはmean squared errorを使います。
observed_states = encode(recorded_frames)
guesses = predict(observed_states_without_last, recorded_actions_without_last)
targets = observed_states_without_first       # connectedのまま
L_pred = mean((guesses - targets)^2)
squareにより正負のgapが打ち消し合わず、averageはbatch、time position、latent coordinateをまとめます。重要なphysical variableがrepresentationにないなら、MSEには苦情を言うcoordinateもありません。
targetはlearnedです。oracle state、EMA teacher、stopped answerではありません。prediction gradientはcontext useとtarget useからshared encoderへ届きます。このflexibilityがconstant-code collapse shortcutも許すため、SIGRegには別の仕事があります。
frozen four-observation defaultでは全shifted pairを数えます。
context/actions:  z0+a0   z1+a1   z2+a2
predictions:      p1      p2      p3
targets:          z1      z2      z3
これは異なるcontext positionにある3つのone-step targetで、1 startからのdirect one-/two-/three-step rolloutではありません。num_preds=1はoffsetです。frameskip=5なので「one model step」は5 environment actionsをまたぎます。paperのTwoRoom historyは1、frozen global defaultは3です。
teacher forcingでは全context stateがrecorded observationから来ます。planningではpredicted stateをappendし、次のinputにします。最初の小さなずれが次のpredictionを変えられます。errorは増幅、縮小、回転、相殺、飽和し得るため、monotonicに増えるとは限りません。
だまされる仕掛け
95 straight transitionsと5 rare doorway turnsのdatasetを作ります。predictorが多数派を扱い、turn actionを無視しても、averageはよく見えます。
MSEは捨てず、分解します。
- regionとprediction slot別にheld-out teacher-forced one-step errorを報告する。
- recorded actionをautoregressive replayし、horizon別errorを描く。
- 同じtargetでteacher-forced/autoregressive contextを比較する。
- history固定でsupported actionをswapする。
- privileged-state probeは限界を明記して使う。
- cost rankingとclosed-loop successを別に報告する。
training MSEとterminal planning costは両方squared latent gapを含んでも、tensorとreductionが違います。前者はshifted transitionのmean、後者はcandidateごとのsummed terminal scoreです。raw valueは交換できません。
実験レシート
LeWorldModel v3、固定train.py、固定JEPA.rolloutはteacher-forced one-step trainingとautoregressive planningを裏づけます。
single-seed TwoRoom reproductionでは、3 checkpoints間でone-step accuracyがshort-horizon behaviorを順位付けしましたが、long-horizon planning successを順位付けしませんでした。これはそのprotocolで後段linkを別々に測る必要を支えますが、universal lawや原因を示しません。
許される主張は、low connected one-step MSEがevaluated transition上のlocal latent agreementを示すことです。meaningful state、reachability、stable rollout、effective CEM、successful controlへ格上げしてはいけません。
3問クイックチェック
- encoded next observationがfixed ground truthでなくても役立つのはなぜですか。
- teacher-forced contextとautoregressive contextでは何が変わりますか。
- averageに隠れたrare action-dependent failureを見せるmetricは何ですか。