コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- encodecontext codeを作る
- 条件を加えるmask、時間、行動
- 予測するtarget codeを狙う
- graphを確かめるfamily≠recipe
小さなお話
画家はレンガや反射をすべて写します。地図作りは道路と交差点を残します。旅人の次の場所を予測するなら、通り全体を描き直す代わりに地図上の点を進められます。
これが「複製ではなく意味を予測する」という便利な直感です。ただし学習された地図には、人間の地図作りが付けた記号がありません。17番目の座標に「出入口」というlabelはありません。塗装色を残し、一方通行を忘れるかもしれません。ここでの「意味」は学習表現であり、有用性には実験が必要です。
本当のルール
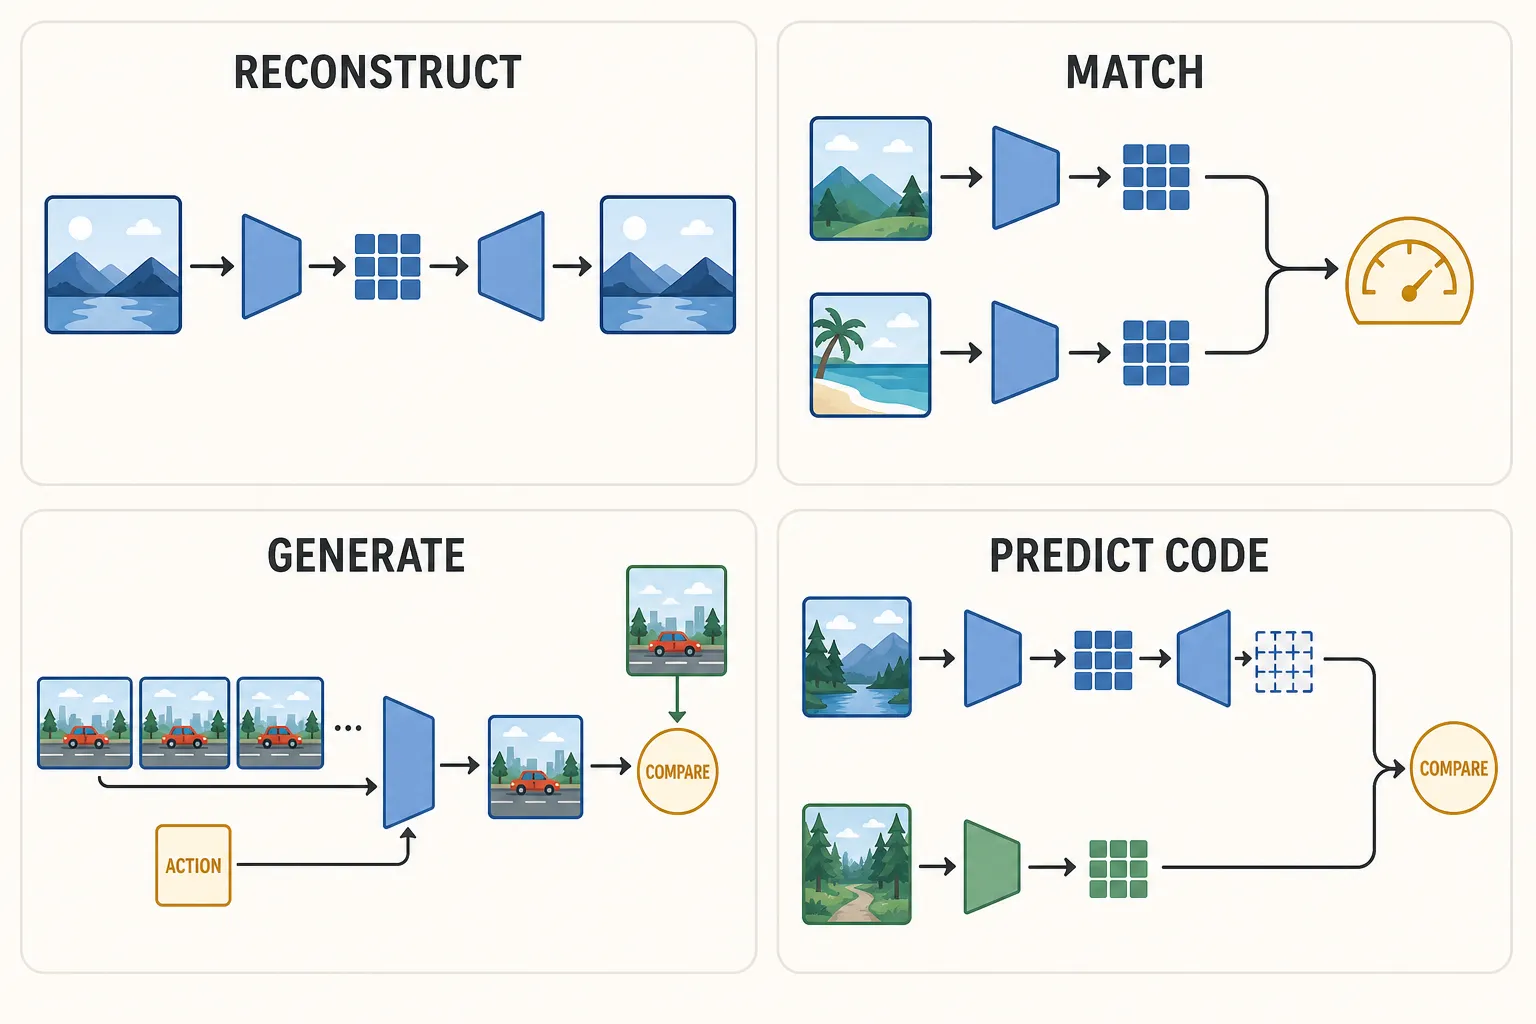
family-levelのJEPA骨格は、意図的に中立です。
context_code = encode_context(context)
target_code = encode_target(target)
predicted_code = predict(context_code, optional_condition)
loss = compare(predicted_code, target_code)
この図だけでは、encoderが1つか2つか、weightが共有か別か、stop-gradient、EMA、negative、stochastic latentの有無は決まりません。それらは名前付き手法ごとの選択です。
LeWM v3では次の形になります。
画像履歴のcode + 記録行動 -> 次画像のcodeを予測現在frameと次frameは、1つの共有trainable visual encoderを使います。action-conditioned predictorが次表現を推定します。prediction lossは同じencoderのcontext側とtarget側の両方へ接続され、SIGRegは別のpopulation-shape pressureを加えます。original v3にはEMA target teacher、target stop-gradient、pretrained visual encoderがありません。
autoencoderはinput-space targetを再構成します。generative video modelはframeやvisual tokenを出します。contrastive objectiveは選ばれたmatchとmismatchを比べます。LeJEPAとLeWMはnegative pairなしでprediction+SIGRegを使います。これは別々の契約であり、普遍的な性能順位ではありません。JEPA family全体が定義上non-contrastiveだとも限りません。
だまされる仕掛け
同じ観測で、行動だけを変えます。
up = predict(current, action="up")
right = predict(current, action="right")
check distance(up, right)
現実の結果が違う場所でも2出力がほぼ同じなら、モデルは制御を無視して普通の続きだけを予測しているかもしれません。するとCEMは多数の行動系列を、ほぼ同じ枝で評価します。予測器が消した選択肢を探索量では作れません。
分離が0でないだけでは正しいdynamicsとは言えません。support内の記録されたsuccessorと向き・大きさを比べ、2つの小行動が本当に同じ効果を持つcontrol stateも含めます。
実験レシート
広いarchitectureはA Path Towards Autonomous Machine Intelligence v0.9.2に基づきます。I-JEPA v3はEMA target encoderを持つ画像向けrecipeです。LeJEPA v3はprediction+SIGRegを動機づけます。LeWorldModel v3と固定train.pyがLeWMのconnected action-conditioned graphの典拠です。
I-JEPAのteacherをLeWMへ移植したり、すべてのJEPAを定義上non-contrastiveと呼んだり、architectureだけでsemanticsを推定してはいけません。controlled probeが支えられるのは、ある違いがdecodable、predictive、planning-usefulだったという狭い主張です。
3問クイックチェック
- 「target representation」だけではteacher networkを証明できないのはなぜですか。
- LeWM v3とI-JEPA recipeを分けるgraph上の違いは何ですか。
- 平均predictionが良くてもCEM searchが役に立たないのはなぜですか。