コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
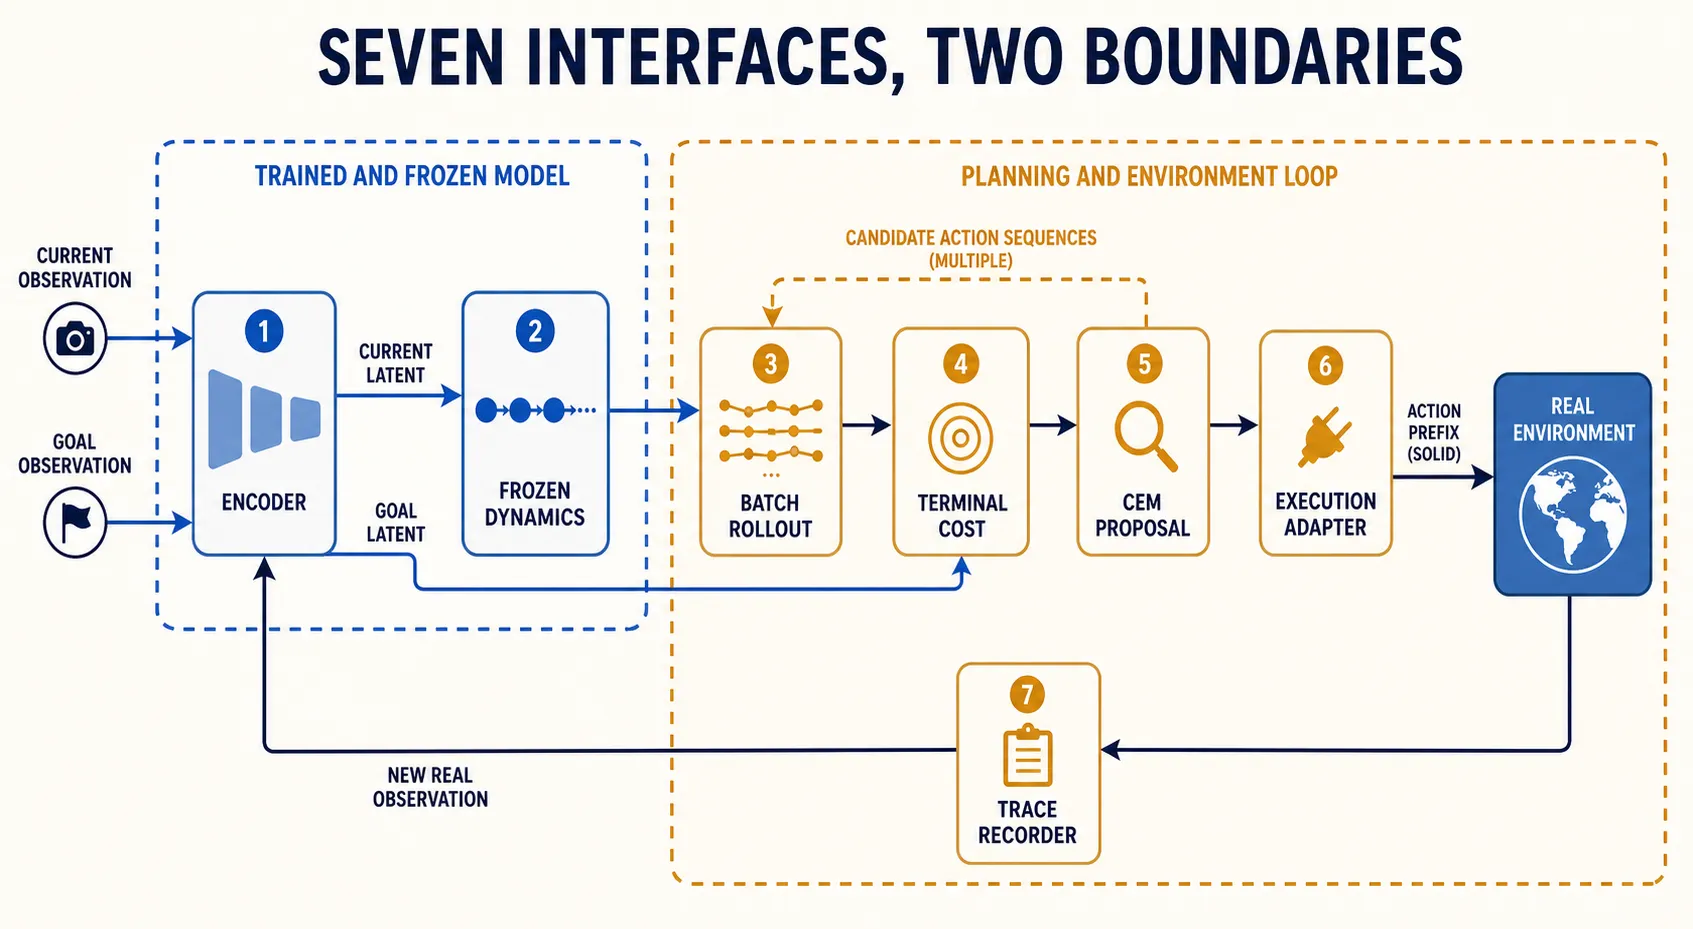
まず大きな絵
- 凍結encoder と dynamics は今は学習しない。
- 探索CEM が行動列全体を提案する。
- 順位づけ想像した終点を goal と比べる。
- 実行K block 動き、観測して繰り返す。
小さなお話
おもちゃの鉄道を作る前に、すべての端子に名前を付けます。どの線が real observation で、どの線が imagined latent で、どの action が motor に届くのでしょう。
最小 LeWM planner も同じです。ここでの “from scratch” は、学習済みで凍結した checkpoint の周りに明確な interface を作ることです。新しい LeWM を発明したり、教材の pseudocode を著者の正確な runtime と呼んだりする意味ではありません。
本当のルール
次の object を混ぜません。
current images    [B, T_context, C, H_image, W_image]
current latents   [B, T_context, D]
goal latent       [B, D]
candidate actions [B, N, H_plan, A_block]
imagined latents  [B, N, T_rollout, D]
candidate costs   [B, N]
execution prefix  [B, K, A_block]
別に符号化した goal は terminal cost に入り、dynamics predictor には入りません。正しい vectorization は throughput のため (B\times N) を平らにできますが、environment、candidate、goal の identity を保つ必要があります。小さな loop 実装と vectorized path を比べ、candidate の並べ替えが対応する output だけを並べ替えるか確認します。
baseline LeWM は、宣言した最終 predicted latent と goal の squared Euclidean distance を採点します。CEM は action proposal を fit し直しますが、model は凍結です。best sampled sequence と final proposal mean を両方保存します。Appendix B と調査した stable-worldmodel snapshots は final mean を返します。best_seen 実行は明記した variant です。
reported setup は (H=5) model blocks、(K=5)、1 block が5 environment actions です。現実に入るのは selected prefix だけです。predicted latent を real observation buffer の偽測定値にしてはいけません。
だまされる反例
TwoRoom で壁越しに近い goal を選びます。同じ frozen task、candidate budget、real-action budget で、4つの名前付き条件を走らせます。
- learned dynamics + learned latent cost。
- oracle dynamics + learned cost。
- learned dynamics + oracle cost。ただし imagined state を採点する正当な bridge がある場合だけ。
- 両 oracle。同じ finite search を保つ。
equal-budget random policy と support-constrained proposal は別に足します。oracle dynamics は rollout replacement、oracle cost は ranking replacement を試します。両 oracle でも CEM は optimal になりません。support constraint は search する場所を変えます。
oracle dynamics で直れば rollout、oracle cost で直れば ranking が疑われます。両方でも失敗するなら candidate coverage、action representation、reachability、execution を調べます。最後の1 frame だけでは原因を決められません。
実験のレシート
各 MPC cycle で current/goal identity、前処理、checkpoint、(H)、(K)、action-block semantics、全 seed、sample/elite cost、proposal spread、support warning、selected normalized action、raw environment action、dashed imagined latent、solid returned observation、termination、timing を保存します。固定 projection で2つの path を見せても、測定は native latent space で行い、simulator 座標は別の privileged panel に置きます。
根拠は LeWorldModel v3、凍結 jepa.py と eval.py、commit 8edfeb3 です。core は歴史的 solver dependency を pin していません。oracle と failure dossier は tutorial diagnostics で、baseline feature や deployable pixels-only result ではありません。
3つのクイック質問
- goal latent を baseline dynamics rollout の外に置くのはなぜですか。
- vectorization の identity 混同を見つける assertion は何ですか。
- oracle dynamics と oracle cost は、どの違う bottleneck を試しますか。