コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- history を見る近づいているか、離れているか。
- contact を保つどこへ、どう触れたか。
- 想像する滑るか、回るか、離れるか。
- 計画するsupport のある push を選ぶ。
小さなお話
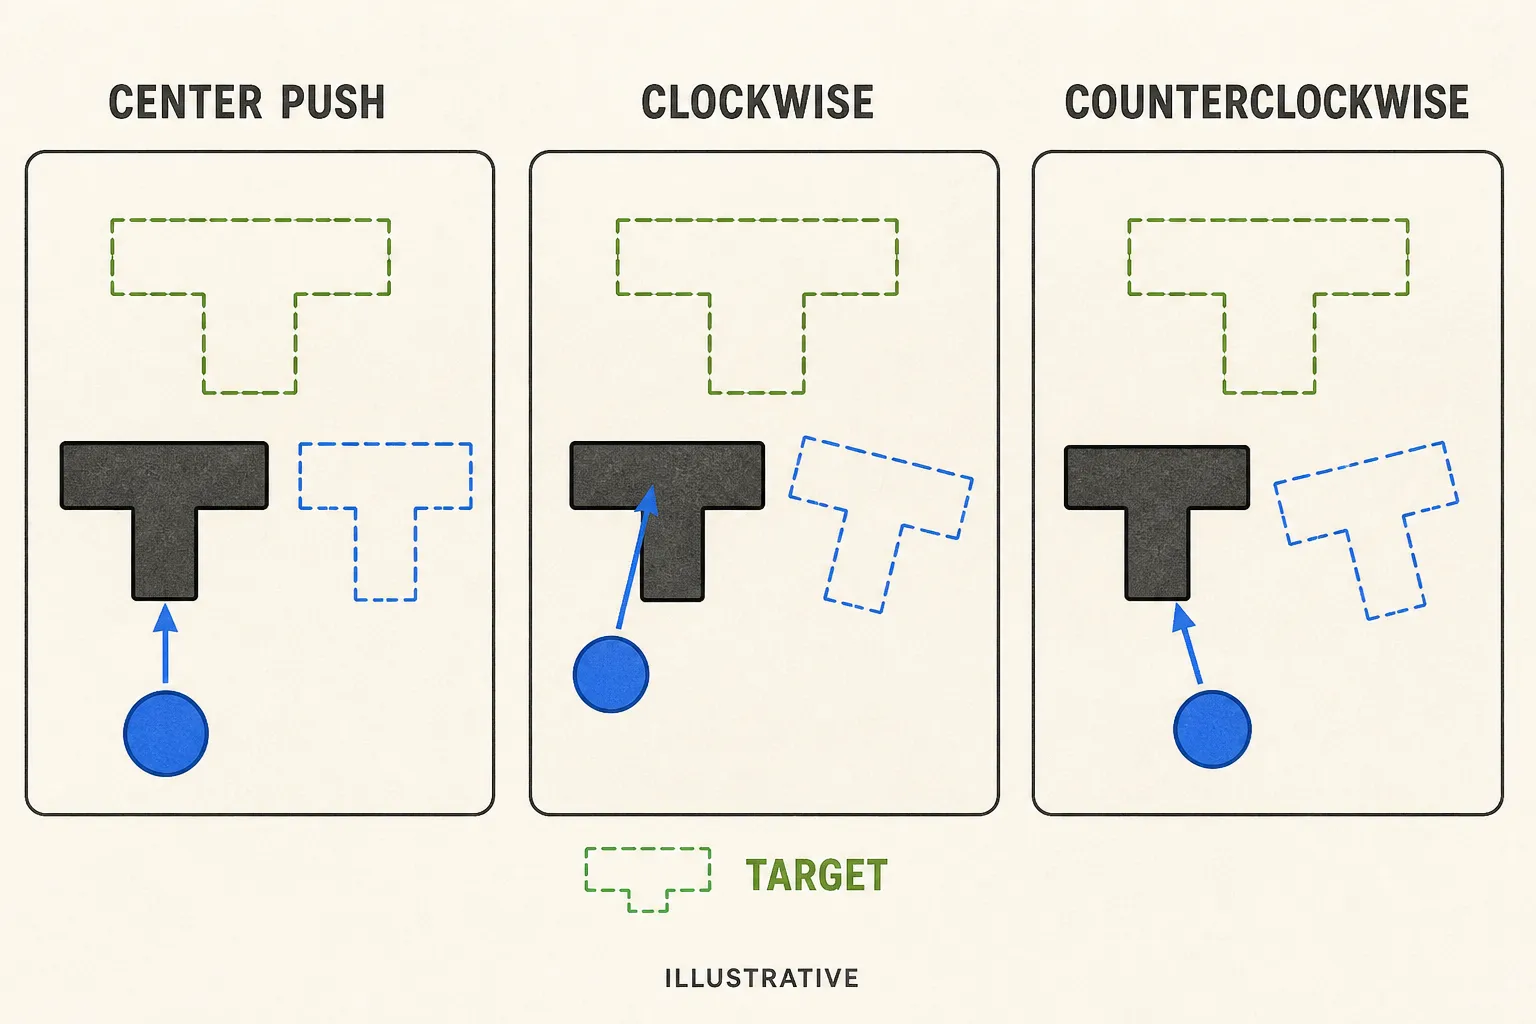
ピアノの中央を押すと滑り、角を押すと回るかもしれません。1枚の写真だけでは、押す人が近づいているのか、contact を保っているのか、離れているのか分かりません。
PushT はこの話を simulated task にします。blue agent は T-shaped block を target pose へ押せますが、引けません。position だけでなく orientation、contact side、approach direction、次のよい push に行ける場所が大切です。simulator での成功は、この予算内制御の証拠です。一般 rigid-body physics や安全な robot skill の証明ではありません。
本当のルール
論文は20,000 expert episodes、平均196 environment steps、10 training epochs を報告します。expert でも全 contact mode を一様に覆いません。凍結 artifact から support atlas を作ります。contact location、approach direction、block position/angle、action magnitude/direction、contact duration/loss、episode boundary を数えます。sparse は「記録証拠が少ない」であり「物理的に不可能」ではありません。
split は episode-disjoint にします。artifact revision/hash、展開・変換、loader、image preprocessing、action/state normalization、history、frame skip、action width を記録します。frozen training YAML は pusht_expert_train.lance を指しますが、公式 public revision 655cd44 は compressed HDF5 を含み、README と evaluation path も HDF5 を説明します。
4つの reproduction target を分けます。
- checkpoint が load され finite output を出す。
- checkpoint が locked evaluation を走る。
- fresh model を train して同じ evaluation に入れる。
- 複数 training seeds で定義済み statistic を出す。
paper card は history 3、10 epochs、特記なければ SIGReg weight 0.1。frozen code も history 3 ですが、maximum 100 epochs、weight 0.09 です。調査した official checkpoint revision は 22b330c です。
だまされる反例
最後の frame がほぼ同じ2本の short history を作ります。片方は inward contact して回転を始め、もう片方は横を滑って離れ始めています。同じ next action を与えます。
full history で適切に違う prediction が出れば、recent visual context が役立っています。prediction が違っても real outcome と合わなければ dynamics が悪いです。rollout がよいのに CEM が悪い contact を選ぶなら cost/search を調べます。両 history を last frame だけにする操作は、observability の欠落を試します。
最後の frame ではなく最初の divergenceを分類します。no contact、wrong side、translation/rotation confusion、contact loss、false progress、support exploitation、cost failure。decoder がきれいでも angle error を隠せます。probe で angle が読めても、predictor/cost が使う証拠ではありません。
learned dynamics + oracle cost は ranking、oracle dynamics + learned cost は rollout、両 oracle + same finite CEM は search/action parameterization を試します。privileged tutorial diagnostics で、deployable LeWM baseline ではありません。
実験のレシート
goal は任意ではありません。recorded trajectory の start と25 environment steps 後の state を使い、action budget は50です。planning は5 model blocks、1 block 5 environment actions、5 blocks 実行して replan。CEM は300 candidates、30 elites、30 refinements、initial variance 1。1 plan は25 environment steps を覆い、frozen interval はその全部を実行します。
LeWM v3 は同じ50 trajectories 上の3 training seeds を報告します。
| Method | 著者報告 PushT success |
|---|---|
| LeWM | 96.0 ± 2.83 |
| DINO-WM | 92.0 ± 1.63 |
| PLDM | 78.0 ± 5.0 |
差はこの protocol 内で4、18 percentage points です。万能な percent improvement ではありません。caption は accompanying quantity を “variance” と呼びます。± だけから SD、SE、CI へ改名できません。success と position/orientation error、overlap/task measure、closest approach/reversal、actions/replans、hardware 付き timing、first failure を併記します。
DINO-WM は pretrained DINOv2 encoder、元の LeWM は task trajectories で visual encoder を end-to-end training します。pretraining と modality provenance を残します。
3つのクイック質問
- 似た2枚の PushT frame が違う next prediction を必要とするのはなぜですか。
- support atlas の sparse cell は何を意味しますか。
96.0 ± 2.83を exact protocol から離せないのはなぜですか。