コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
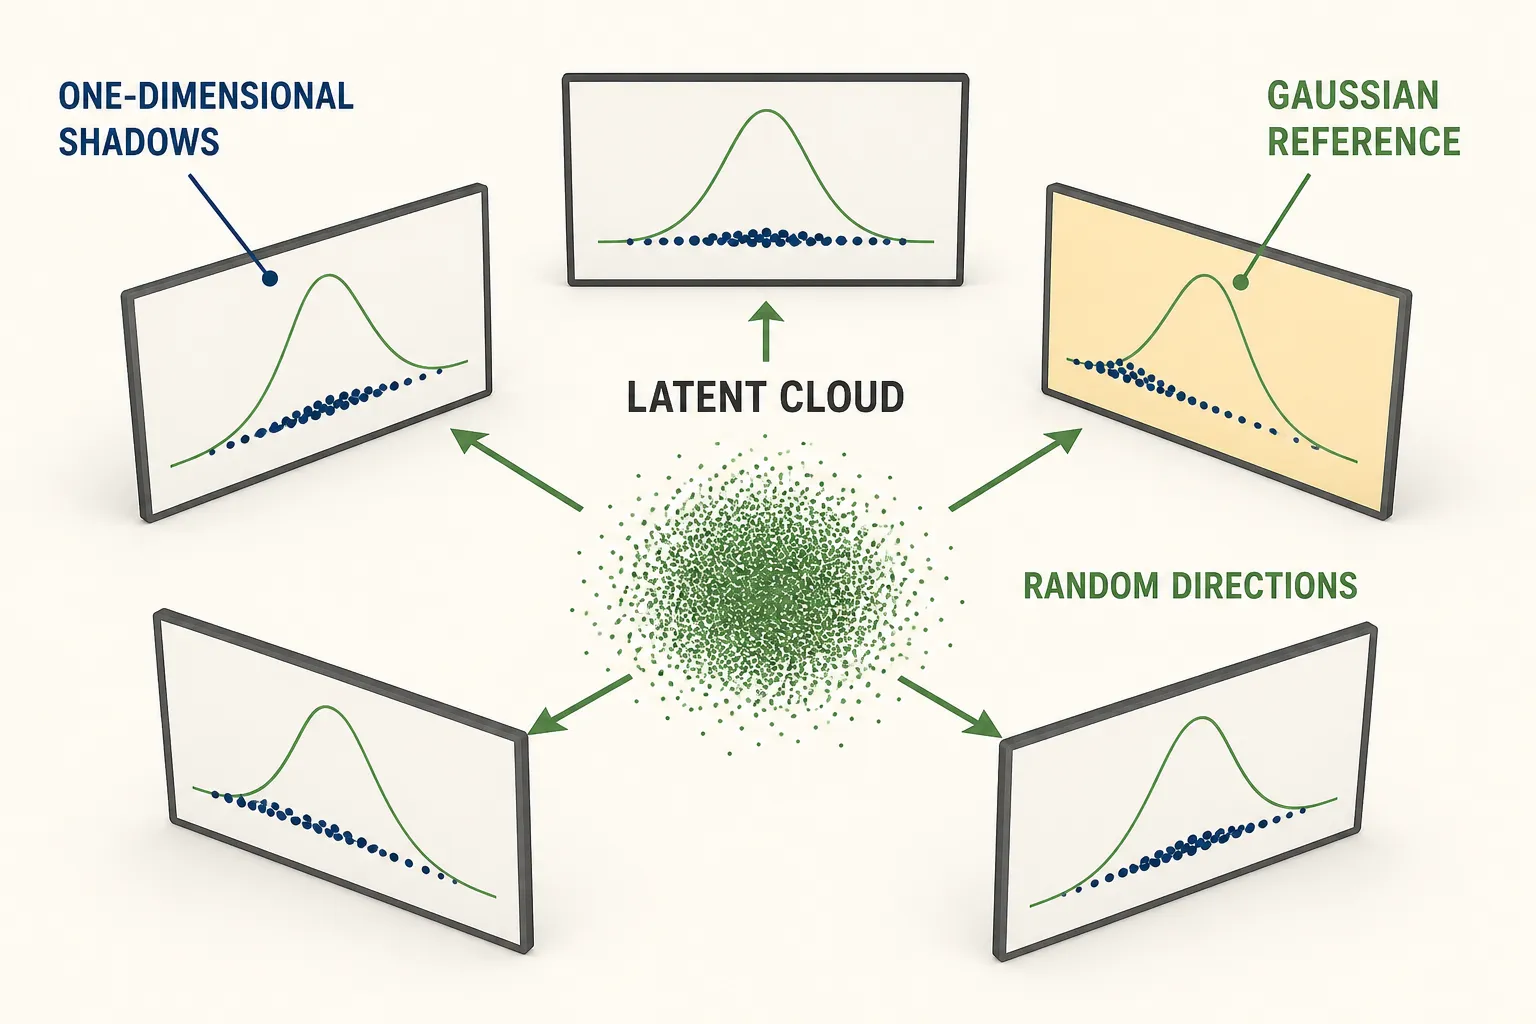
- latent crowd1時刻、多examples
- 影を作るrandom 1D direction
- fingerprintcosine + sine probe
- 比べるstandard Gaussian
小さなお話
「全員を同じ住所に置かないで」だけでは曖昧です。1点を避けても、全住民を1本のroadへ押し込む、1方向へ伸ばす、simple statisticsが健全に見えるX shapeにする、といったcityが作れます。
SIGReg、つまりSketched Isotropic Gaussian Regularizationは、crowdにreference shapeを与えます。embedding populationの多数のone-dimensional shadowを、isotropic standard Gaussianのshadowへ似せます。
技術バックパック
各relative time positionで、frozen LeWMはB embeddingsを1 populationとして扱います。timeをcrowdへ混ぜません。random unit vectorは各D=192 embeddingを1つのsigned scalar shadowへ変えます。directionを繰り返し、各one-dimensional sampleをanalytic Gaussian fingerprintと比べます。
Gaussianの言葉には意味があります。
- standard:unit-direction shadowはzero-centered、unit-scale。
- isotropic:referenceにpreferred directionがない。
- Gaussian:uniform ballではない。densityはoriginで最大だが、high-dimensional radial probability massはおよそradius
sqrt(D)shellへ集まる。
Epps–Pulley constructionはempirical characteristic functionを使います。有限のfrequency probeでcosine/sine responseをaverageし、既知のstandard-Gaussian responseと比べます。LeWMはsmooth discrepancyをminimizeし、p-valueや「normality pass」を出しません。
[T,B,D]
  -> 各timeでB-point cloud
  -> random 1D projection
  -> finite knotsでcosine/sine response
  -> analytic N(0,1) fingerprintとの差
  -> directionとtimeでaverage
frozen codeはcallごとに1,024 directionsをsampleし、0〜3の17 knotsとGaussian weighting windowを使います。directionsはresampleされるためtraining valueはstochasticです。classはsingle-GPUで、device間のglobal population gatherをしません。paper appendixはillustrative integrationを別表現にするため、paper/executable factを分けます。
Cramér–Wold principleはall one-dimensional projectionsが一致するとmultivariate distributionを識別します。frozen trainingが見るのはfinite batch、finite direction、finite knotです。approximationでありGaussianity certificateではありません。
だまされる仕掛け
X-shaped cloudのhorizontal/vertical axisだけ見ます。両shadowが無害でもdiagonal shadowがdependenceを示せます。random viewは固定blind spotを減らしますが、finite 1,024 viewsでもnarrow defectを見逃し得ます。
次に本物のcorridor trajectoryを見ます。thin cloudはbroken encoderではなく、本当にlow-dimensional worldを反映する場合があります。192-dimensional isotropic targetへ無理に合わせるとtensionが生まれます。LeWM paperはこのmismatchをTwoRoomのpossible contributorとして提案しますが、established causeではありません。
projectionを増やしてもobservationは増えません。small crowdを千方向から見てもlarge crowdにはなりません。batch sizeとprojection countは別のuncertaintyを扱います。
実験レシート
mechanismはLeWorldModel v3、固定SIGReg、LeJEPA v3、Epps–Pulley paper、Cramér–Woldに基づきます。
referenceがanalyticなので、SIGRegはbatch examplesを必要としてもlabelled negativeやlearned teacherを必要としません。ideal targetではexact constant representationを排除します。しかしphysics、action sensitivity、reachability、finite-run successは証明しません。
3問クイックチェック
- nonzero varianceやidentity covarianceだけでは不十分なのはなぜですか。
- finite random projectionsでCramér–Woldがproofにならないのはなぜですか。
- SIGRegはnegative pairやEMA teacherの代わりに何を使いますか。