コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
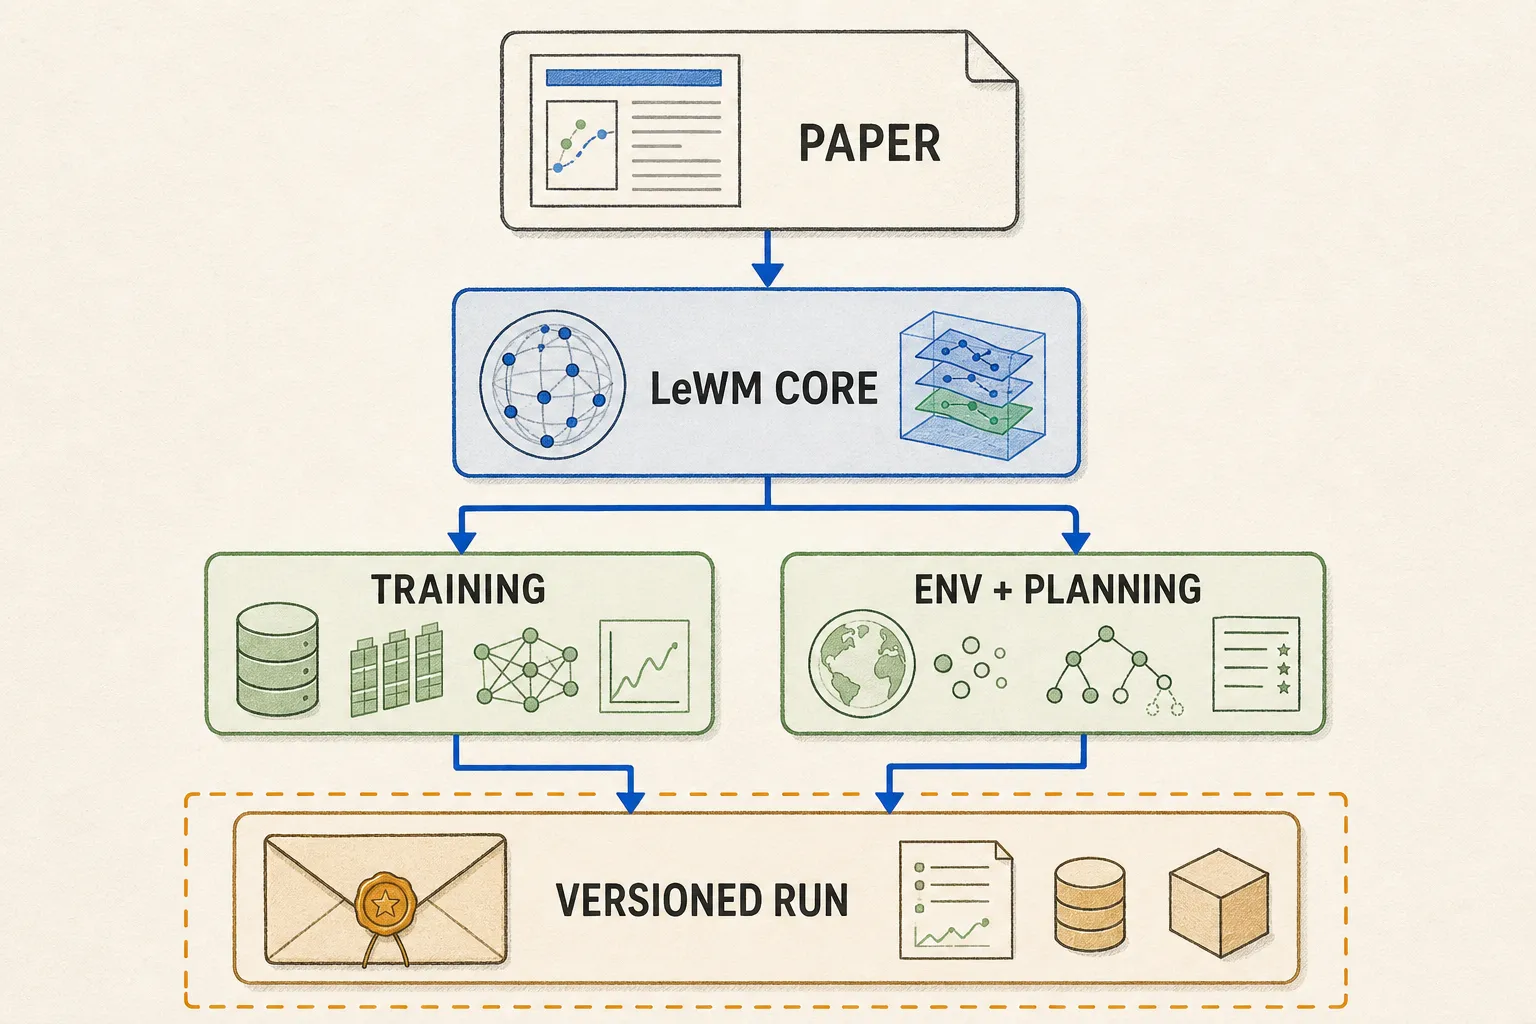
まず大きな絵
- 論文どんな実験を説明したか。
- coreどの凍結 LeWM code か。
- 作業場依存 project のどの revision か。
- レシート実際に何を走らせたか。
小さなお話
公式のエンジン、公式の工具箱、公式の鍵を受け取っても、鍵がエンジンに合うとは限りません。鍵を作った後で工具箱が変わったかもしれないからです。
LeWorldModel も層になっています。論文は設計の説明、小さな凍結 repository は core engine、stable-pretraining と stable-worldmodel は training、environment、planning、evaluation の作業場です。data と checkpoint も別の artifact です。「公式 + 公式」が著者の歴史的環境になるとは限りません。
本当のルール
凍結 LeWM core は commit 8edfeb3 です。jepa.py/module.py は model と SIGReg、train.py は data と losses、eval.py は frozen model、CEM/random action、environment、metrics をつなぎます。
core には dependency lockfile がありません。本講座は stable-worldmodel@addbab4 と stable-pretraining@9aa93f8 を調査しました。現在の挙動を確認する revision であり、LeWM が指定した歴史的 pin ではありません。
次の5項目を通れば mechanically ready と呼べます。
- Python、PyTorch、accelerator stack、OS を記録。
- 全 source revision を記録。
- data/checkpoint の hash と展開後 file 名を記録。
- episode-safe batch、finite forward、短い environment interaction を確認。
- resolved config、hardware、logs、outputs を保存。
README は Python 3.10 を指定します。missing field を直す前に Hydra を完全 compose します。launcher fragments が wandb と cache_dir を供給します。散らばった YAML ではなく、resolved run sheet が実行した実験の記録です。
元の v3 は1つの shared、fully trainable visual encoder、action-conditioned predictor、SIGReg です。target は connected です。stop-gradient target、EMA teacher、pretrained visual backbone、reward、goal、CEM supervision は training にありません。
だまされる反例
paper、code、run は別のカードです。
| 設定 | paper card | frozen-code card |
|---|---|---|
| named-task training | 10 epochs | maximum 100 |
| TwoRoom history | 1 | global default 3 |
| SIGReg weight | 特記なければ 0.1 | 0.09 |
| 非 PushT CEM refinements | 10 | shared config 30 |
| PushT training data | trajectory として説明 | YAML は Lance、公開 artifact は compressed HDF5 |
カードを平均したり、都合のよい値を黙って選んだりしません。
checkpoint identity にも罠があります。調査した公式 repository の weights.pt/config.json は stable_worldmodel.wm.lewm の class を指し、凍結 core は jepa.JEPA を構築して conversion を説明します。class path、architecture、preprocessing、source/dependency revision、hash、conversion を一緒に保存します。
training script は non-image normalizer を full loaded dataset に fit してから delegated random split を行うため、この path は train-only normalization ではありません。episode grouping も解決した stable-pretraining revision に依存します。load 成功だけでは、この科学的差は消えません。
実験のレシート
本講座が調査した artifact revision は TwoRoom data 6903a2d、PushT data 655cd44、TwoRoom model 77adaae、PushT model 22b330c です。dataset receipt には episode/time fields、前処理、normalization split、temporal window、frame skip、loader、format conversion、episode boundary をまたがない test を入れます。
論文は約15M parameters、single GPU、数時間の training と、条件内で最大48×の planning speedup を述べます。凍結 trainer は GPU、automatic device、bfloat16 を選びますが、歴史的 GPU と timing stack は不明です。著者報告かつ configuration-dependent として残します。
独立 TwoRoom study の公開 commit efa9e5d は、YAML 外の4約束を報告します。frame-skip block ごとに raw actions 5個、action-encoder width 10、ImageNet normalization、action coordinate ごとの z-score です。自分の matched 50-episode protocol で、自分の checkpoint 94%、公開 author checkpoint 84%、position probe Pearson 0.9988 を報告しました。1環境・各 config 1 training seed であり、4-task table や歴史的環境の再現ではありません。
3つのクイック質問
- mechanically ready が示すことと、示さないことは何ですか。
- resolved Hydra config を保存するのはなぜですか。
- 公式 artifact 同士でも paper environment を再現できないのはなぜですか。