コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- たくさんのpixel模様、光、noise
- 小さな手掛かり扉は開いている?
- codeにする大事な違いを残す
- 試す小さい≠正しい
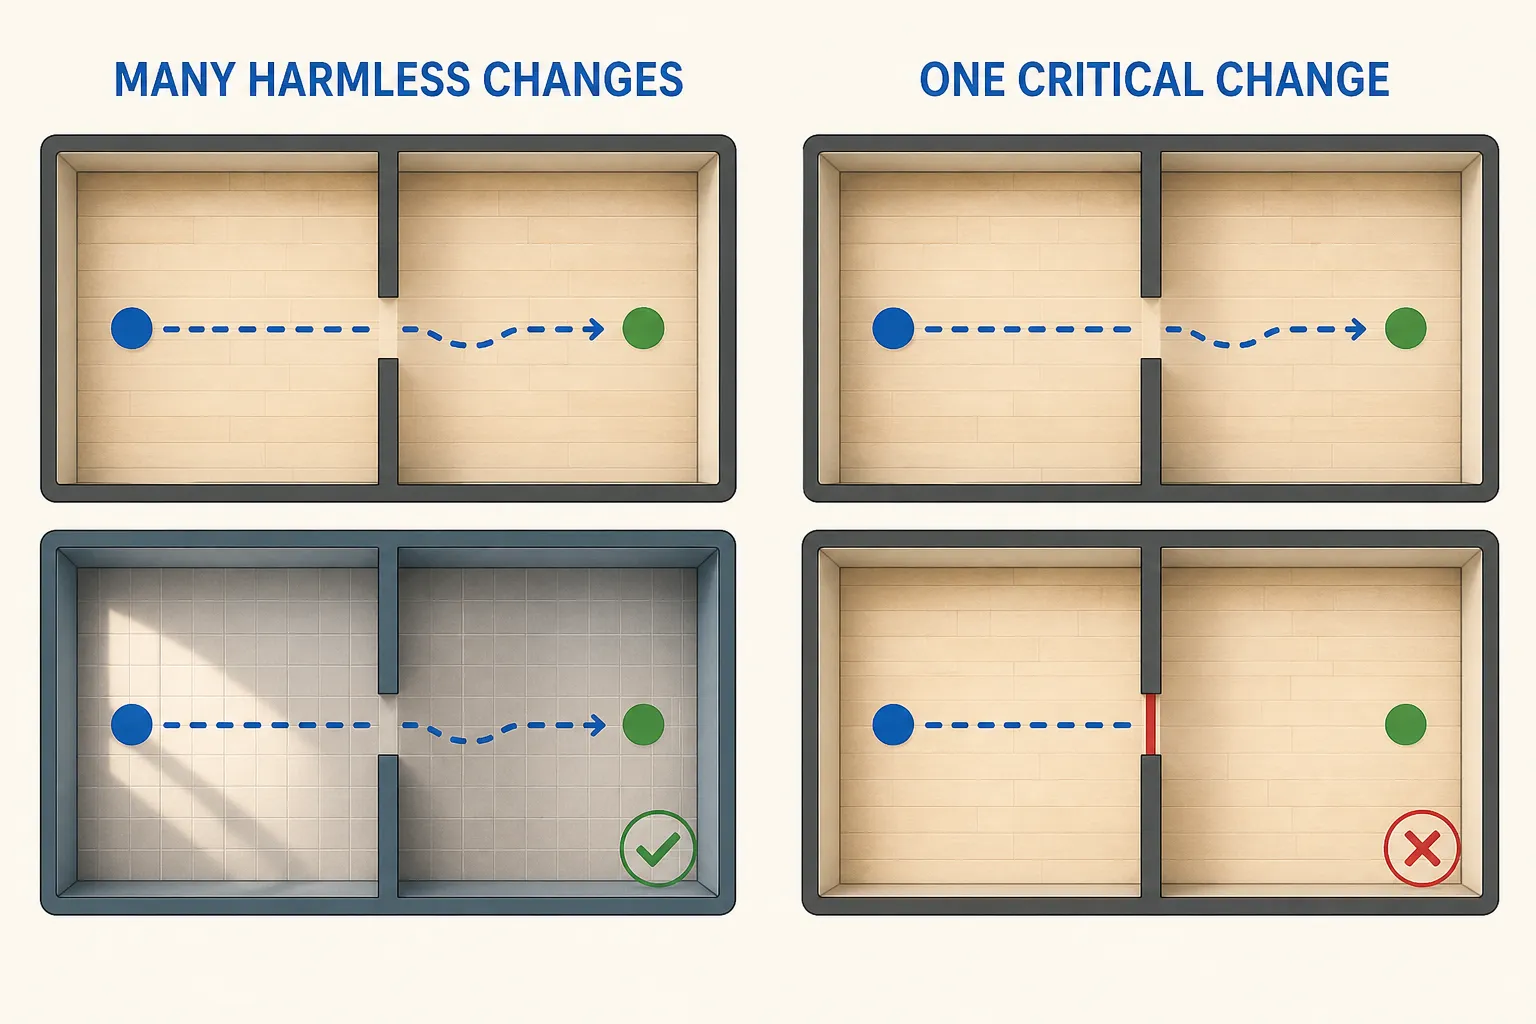
小さなお話
予測Aは床の模様や影を間違えますが、agent、壁、出入口は正しい場所にあります。予測Bはほぼ完璧ですが、細い1本の誤差で出入口を閉じてしまいます。pixel scoreはBを好むかもしれません。controllerはそうすべきではありません。
pixelが無用なのではありません。小さな赤信号、ケーブル、水たまり、接触境界が決定的な場合もあります。教訓はもっと狭いものです。どこで誤差を測るかが、学習時にどの違いを残す圧力をかけるかを決めます。
本当のルール
LeWMの中核目的は次画像の生成ではありません。記録された次観測をencodeし、以前のcodeと行動からそのcodeを予測し、2つを比較します。
観測: [B,T,C,H,W] -> code: [B,T,D]
使う行動: [B,T-1,A]
予測と対象: [B,T-1,D] <-> [B,T-1,D]これにより選択的抽象化の余地ができます。結果を変えない照明なら、同じようなcodeにしてもよいかもしれません。しかし「latent」という言葉は何も保証しません。壁紙を残して出入口を捨てるcodeもあり得ます。中核rolloutはvector列で、隠れた動画ではありません。画像化には別の診断decoderが必要です。
制御に役立つ表現には、状況の違い、行動効果、時間的手掛かり、plannerに役立つ比較が残っていてほしいものです。またoffline dataのstate–action support外では慎重に扱う必要があります。これは検査すべき設計目標であり、圧縮が約束する性質ではありません。
固定コードでは1つの共有trainable encoderを使い、次観測のencoded targetも接続されたままです。EMA教師もstop-gradientもありません。SIGRegは後で最も簡単なconstant-code shortcutへ圧力をかけますが、physicsやreachabilityのlabelではありません。
だまされる仕掛け
「圧縮dial」を回します。一方の端には全pixelと全nuisance、もう一方には全画像で同じconstant vectorがあります。constantは小さく、予測器がいつも返せるので完全に予測可能です。しかし制御には使えません。
よい診断では要因を1つずつ変えます。geometryを固定してtextureとlightingを変え、次にappearanceを似せたままdoorwayを開閉します。期待するのは、指定したnuisanceには不変で、経路を変えるcueには敏感なことです。さらにfloor textureをfrictionの印にするなどtaskを反転し、「nuisance」が条件付きだったことも確かめます。
きれいなcluster plotだけでは足りません。held-out prediction、action swap、planning outcomeと組み合わせます。
実験レシート
LeWorldModel v3と固定train.pyは、compact next-embedding prediction、connected target、SIGReg、中核目的の外にあるauxiliary decoderを裏づけます。
I-JEPA v3の限定された比較では、ImageNet-1KのViT-L/16、1% label linear evaluationで、representation targetはtop-1 66.9、pixel targetは40.7でした。pretraining scheduleは500 epochs対800 epochsで異なります。これは名前付きの静止画像条件の結果であり、controlでlatent predictionが常に勝つ証明ではありません。
許される主張は、latent predictionが選択的抽象化を可能にすることです。pixel predictionが本質的に劣る、最小codeが最良、latent errorがtask errorと同じ、とは言えません。
3問クイックチェック
- 多数の誤pixelより、1本の誤ったdoor edgeが重要になるのはなぜですか。
- constant codeはなぜ予測しやすく、制御には使えないのでしょうか。
- doorway geometryが残ったかを確かめるには、どの2条件を比べますか。