コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
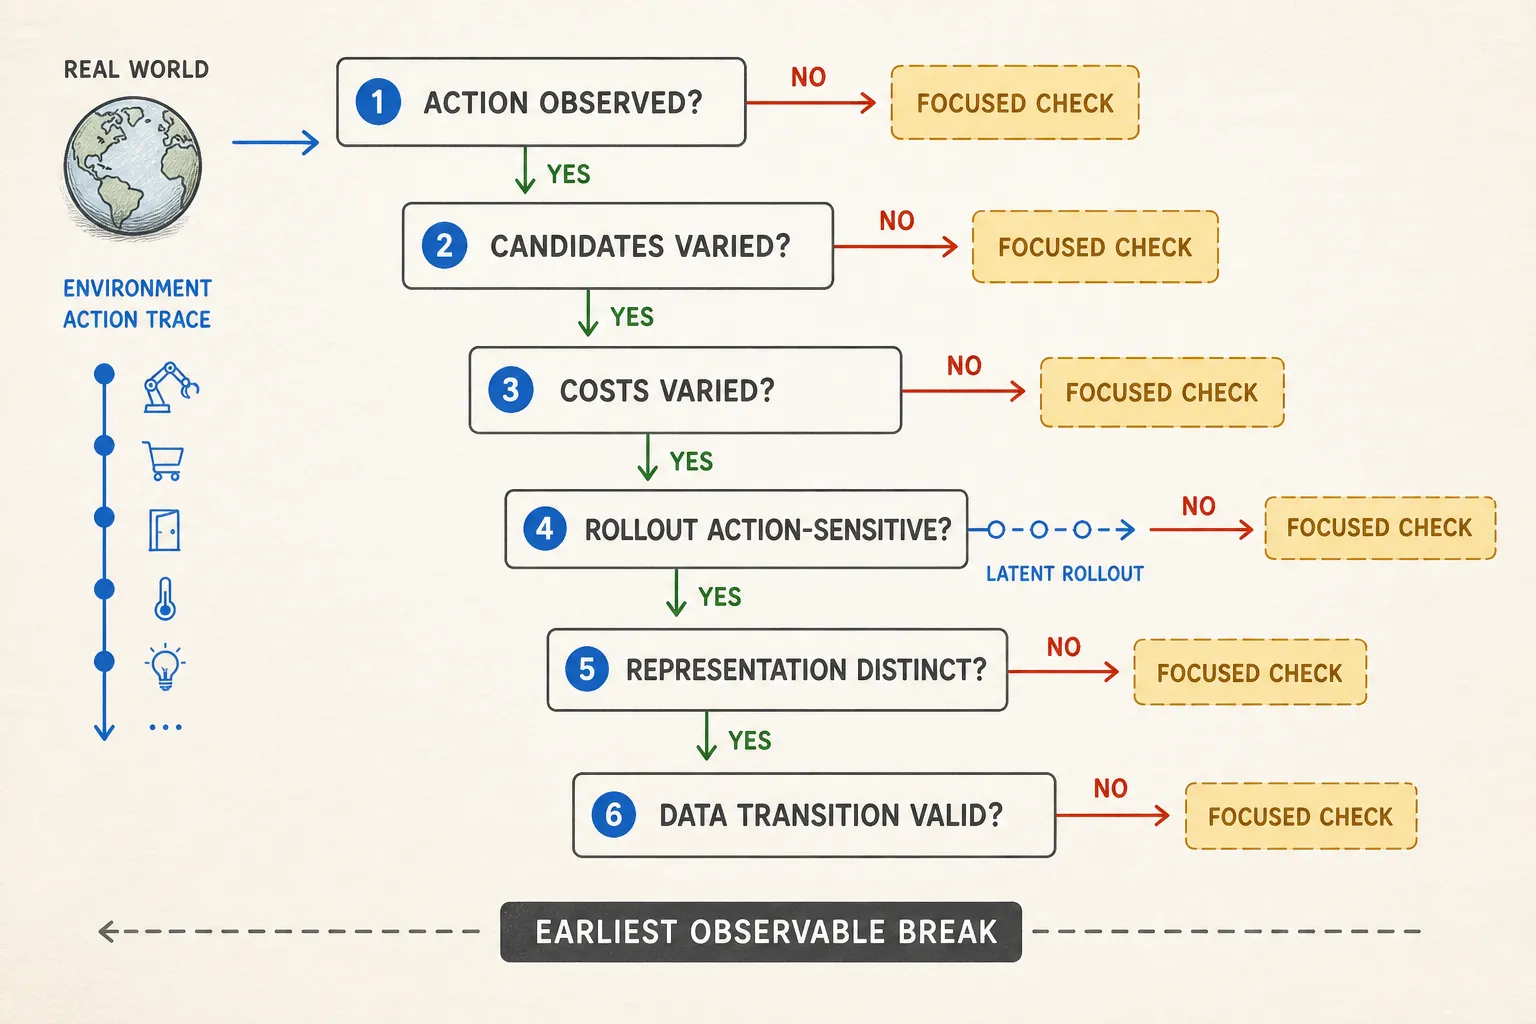
まず大きな絵
- 1失敗を凍結同じ episode、seeds、candidates。
- 後ろへ歩くexecution から data へ。
- 1層だけ交換measured または oracle counterpart。
- 最小の結論別の説明を残す。
小さなお話
医師が「患者は動けない」と聞きました。muscle、nerve、medicine、pain、または外れた monitor が原因かもしれません。全部を交換すると症状は消えても、診断は壊れます。
動かない LeWM agent も、collapsed representation、action-deaf dynamics、flat cost、poor CEM sample、denormalization で zero、valid action を止める wall などがありえます。好きな理論ではなく、1つの frozen failing specimen から始めます。
本当のルール
最後の物理的事実から後ろへ歩きます。
- environment は意図した raw action を受け取ったか。
- denormalized actions は変化し clipping 後も残ったか。
- CEM proposal と elites は変わったか。
- candidate costs は変わったか。
- rollout は action に正しく反応したか。
- representation は必要な違いを残したか。
- data window、timing、action は valid か。
全 interface の両側を log します。“selected action” だけでは normalized、clipped、repeated、block-level、environment unit のどれか不明です。planner randomness と candidate batch を凍結します。
action use は1つの history を固定し、recorded、swapped、zeroed、permuted actions を matching environment transition と比べます。output change は nonzero gradient より強い証拠ですが、間違う方向への反応は正しい dynamics ではありません。
self-fed failure は、同じ recorded actions を recorded-context/self-fed lanes で replay します。最初の divergence を door、contact、support ごとに見ます。この単純比較を理解する前に CEM を入れません。
だまされる反例
最後の video では、2 agent とも動きません。
Agent One: candidates と rollouts は変わり、CEM も正しく update。しかし current embedding が goal slot に複製され、cost が flat。oracle cost は frozen candidates を分けます。
Agent Two: cost は分かれ、CEM は強い action を選択。しかし wrong normalization column が environment 前に zero へ変換します。
症状は同じでも、earliest observable break は違います。
ほかの discriminating tests:
- flat cost:goal identity、broadcasting、terminal spread、shuffled goals、oracle task progress。
- coverage vs bug:support atlas × known-transition replay × tiny repeated-transition fit。
- tiny overfit:1 transition → same context 2 actions → short sequence → doorway/contact。
- SIGReg dominance:branch loss、module gradient、spread、prediction、controlled weight sweep。
- small batch:batch/projection 間の statistic、relative time ごとの distinct examples、composition。
projection direction を増やしても、欠けた observation は生まれません。gradient accumulation は batch-wise SIGReg が見た population を大きくしません。
実験のレシート
repair 前に source revisions、checkpoint hash、composed config、dataset indices、raw observations、normalized/raw actions、candidate batch、costs、random states を保存します。
frozen SIGReg weight は0.09、method text は特記なければ0.1。PushT high-weight ablation は task-specific で、万能な安全範囲ではありません。大きな loss/gradient が有害かは、controlled weights で held-out dynamics と behavior が変わるまで分かりません。
tree は LeWorldModel v3 と凍結 jepa.py、train.py、eval.py、commit 8edfeb3 を囲む tutorial construction です。oracle repair は交換層をその test 内で疑わせるだけで、他層全部の正しさを証明しません。
3つのクイック質問
- planner tuning より fixed-action replay を先にするのはなぜですか。
- 動かない agent で “CEM is broken” を反証できる evidence は何ですか。
- earliest observable break と unique root cause はどう違いますか。