コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 名前を付けるversion、data、seed、episode。
- 別々に量るtraining と planning は別 budget。
- まとめて渡すlog、failure、command、checkpoint。
小さなお話:数字一枚の suitcase
researcher が 82% success とだけ書いた card を持って国境へ来ます。係員は、どの code、どの bytes、どの seed、どの planner budget、どの episode、failed run はどこ、と尋ねます。card は答えられません。
数字は正直かもしれません。ただし完全な experiment receipt ではありません。下の十 compartment を run 前、実行中、publication 前に使います。“not verified” と書いた blank は、記憶で埋めた guess より優れます。
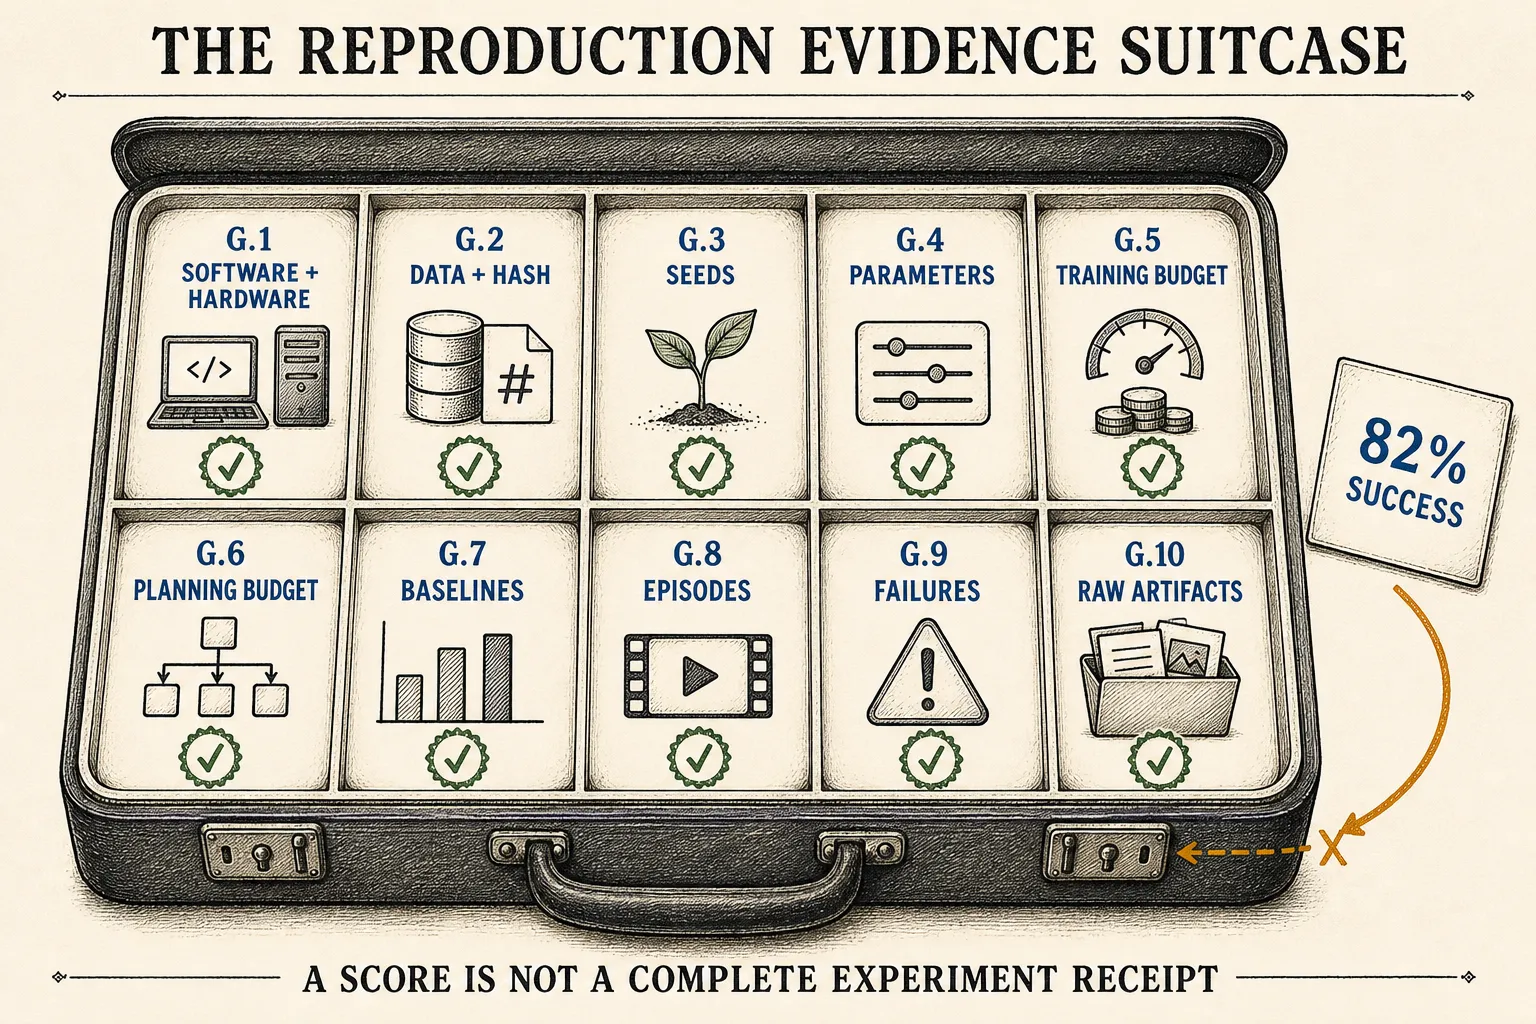
完全性は inspection を助けます。hardware や nondeterministic kernel を越えた bitwise identity を約束しません。
コピーできる十 compartment の run receipt
G.1 Software と hardware
- Paper/version、repository URL、exact SHA、local diff、launch command、behavior を変える environment variable。
- OS、Python、framework、CUDA/cuDNN、GPU model/count/memory、precision、compilation/fused kernel、deterministic setting。
- first-party dependency を含む lockfile / resolved environment export。LeWM core
8edfeb3だけでは movingstable-pretraining/stable-worldmodelを凍結しません。 - Protocol history。current v3 TwoRoom は goal offset/budget
25/50。independent audit の paper-side100/150は older v1/v2 history です。
G.2 Data identity と hash
- Artifact URI/revision、download filename、cryptographic hash、license/access rule、decompression/conversion、loader が実際に読んだ exact bytes。
- Format、field、crop/resize、normalization、fitted preprocessing split、frame skip/action grouping、history、window length/stride、invalid-window rule。
- windowing 前の episode ID と episode-disjoint train/validation/test split。各 sampled window を一 source episode へ追跡可能にする。
- format discrepancy を明記。frozen PushT YAML は Lance を指す一方、inspected public artifact/README path は compressed HDF5/HDF5-oriented です。
audited TwoRoom 再実装では、各 frame-skip block の dense action、programmatic action-encoder width、ImageNet pixel normalization、action z-scoring を記録します。これは TwoRoom audit fact で、universal LeWM requirement ではありません。
G.3 Seed と stochastic policy
- split/window sampling、initialization、augmentation、dropout、loader worker、environment reset、collection policy、CEM sampling、goal selection の seed 一覧、または master seed からの exact derivation。
- 残る nondeterminism と failed/excluded run の rule。“five seeds” だけでなく identity を保存。
- paired noise が必要な比較では evaluation/planner seed を variant 間で pair。
G.4 Parameter と training graph
- visual backbone、projector、action encoder、predictor、optional head ごとの total/trainable parameter count。frozen/pretrained を明記。
- baseline v3 identity を確認。trainable visual encoder、connected shifted target、EMA teacher なし、pretrained visual encoder なし。
- どの loss がどの parameter に届くか記録。似た total は同じ architecture/prior compute を意味しません。
G.5 Training budget
- optimizer update、batch/context size、data window/exposure、epoch、optimizer/schedule、validation cadence、early stopping、precision、wall time/device-hours、checkpoint-selection rule。
- pretraining data/compute、または
unreported。黙って zero にしない。 - paper/code 差を解決。named LeWM experiment は 10 epochs、frozen global maximum は 100。実際に run した composed value を archive。
G.6 Planning budget
- candidate population、elite、refinement round、proposal initialization、action bound、model horizon、environment actions/model step、executed prefix、replanning interval、total action allowance、vectorization、per-decision latency。
- training meter と分離。equal parameter は equal search ではなく、equal wall time は equal sampled action ではありません。
- clock を翻訳。cited frozen card では 5 environment actions が 1 model step、horizon/executed prefix はともに 5 model steps。replan 前に full five-block sequence を実行します。
G.7 Baseline と oracle condition
- 各 baseline の implementation/SHA、checkpoint、data/preprocessing、pretraining、capacity、training/planning budget、tuning space、同じ episode ledger。
- random policy、behavior cloning、oracle dynamics、oracle cost の役割を明記。oracle は headroom を局所化しますが、deployable method でも learned replacement が達成可能な証明でもありません。
- schedule/hyperparameter を evaluation 前に選んだか post hoc か。favored method だけ retune するのは matched comparison ではありません。
G.8 Evaluation episode
- Environment/task revision、episode/start/goal ID、goal rule、count、action budget、success definition、termination/timeout/reset rule、planner seed、failure handling。
- 必要に応じて paired start/goal/randomness を再利用。mean だけでなく per-seed/per-episode outcome、uncertainty、timeout、goal-type strata を報告。
- headline result を読む前に episode ledger を freeze。
G.9 Failure、null、negative
- declared selection rule で raw success/failure を保存。fixed suite の全 failure、各 seed 最初、uniform sample、preregistered strata など。
- 最初に観測できる break を分類。data support、collapse/missing variable、action insensitivity、one-step mismatch、self-fed drift、cost misranking、CEM miss、execution/interface error、timeout。
- frame、observation、action、predicted diagnostic、candidate cost、selected sequence、executed prefix、termination reason を時間 alignment 付きで保存。
- null/negative ablation も archive。“ここで gain なし” はこの setup の evidence で、impossibility ではありません。
G.10 Raw archive と command record
- Source/diff、dependency lock、command、environment variable、composed configuration、data manifest/hash、stdout/stderr、structured metric/event、checkpoint、resumption に必要な optimizer/scheduler/scaler/RNG state、episode ledger、raw prediction/action、analysis/figure script revision。
- directory map、missing-item inventory、access restriction、
not collected、lost、private、too large、available on requestの意味を持つ README。 - raw evidence(frame/action/ID/cost)、derived evidence(table/statistic)、presentation(cropped figure/video)を分離し、間を追跡可能にする。
- clean handoff を smoke-test。checkpoint 一つを load、window 一つを episode へ trace、summary 一つを再生成。training resumption と inference を別々に test。
receipt を壊してみる
二 laboratory が同じ commit、seed、GPU、checkpoint を使い、loss も完全一致します。後で、sampler が一 episode の last frame と次 episode の first action を deterministic に pair していたと分かりました。
reproducibility は procedure を繰り返しましたが、procedure を正しくしません。episode boundary、target shift、causal visibility、action sensitivity、gradient recipient、training target と planning goal の分離を mechanical test に加えます。逆に、正しい stochastic run 二つは数値が違っても同じ distributional conclusion を支えられます。
次に二つの 80% score を考えます。一方は pretrained vision、300 candidates、30 refinements、5 seeds、same-trajectory goal。もう一方は end-to-end training、64 candidates、5 refinements、1 seed、broader goal split。equal number は equal experiment ではありません。比較前に receipt を lock します。
証拠レシート
method identity は LeWorldModel v3、frozen LeWM code、first-party dependency/artifact、TwoRoom reproduction v1 と tinylab efa9e5d に基づきます。LeWM v3 は 2026-06-03 改訂、core commit は 2026-05-22、reproduction v1 は 2026-08-10、checklist cutoff は 2026-08-20。independent reproduction は TwoRoom-only です。complete checklist は identity/gap を保存しますが、bitwise equality、unsupported data の修復、incomparable run の事後的 fairness を保証しません。
3つのクイック質問
- training budget と planning budget を別 meter にするのはなぜですか?
- data hash は何を証明し、何を未解決にしますか?
- stranger が guess せず一 result を再生成するには、どの artifact が要りますか?