コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- currentrolloutのstart
- actioncandidate futureを作る
- goalfinish lineで待つ
- 順位付けCEMがplanをrefine
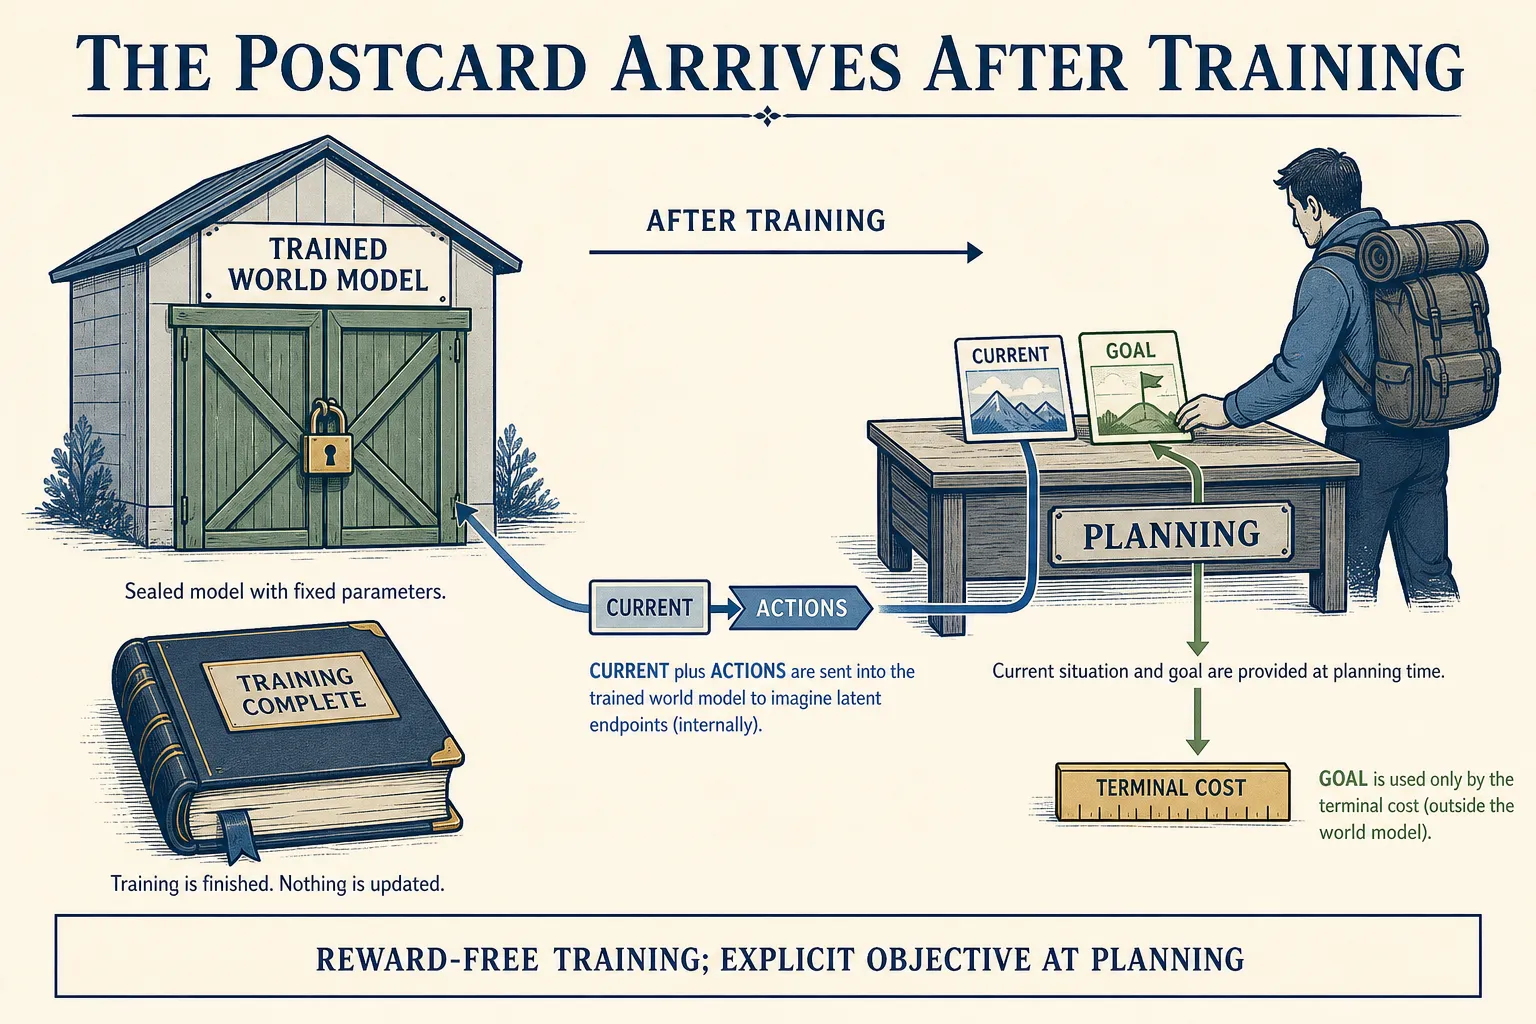
小さなお話
world modelはreward-free observation–action journeyからatlasを学び終えました。今、travelerがcurrent photographとdestination postcardを持ってきます。atlasはconsequenceを予測できますが、predictionだけでは好みがありません。postcardが好みを与えます。
latent atlasはwall、direction、time、data supportを歪めているかもしれません。goal imageはsuccess detector、route、trainingに使ったreward、destinationがreachableというproofではありません。
技術バックパック
current/goal observationは同じfrozen visual encoderを使うため、coordinateを比較できます。ただしroleは別です。
current history -> dynamicsのinitial condition
candidate actions -> dynamicsのcontrol
goal image -> terminal comparisonだけ
current historyとcandidate actionを固定してgoalだけswapしても、baseline rolloutは変わりません。rankingだけ変わるはずです。goalのpreprocessing、camera、environment、supportはcheckpointのinput contractと合う必要があります。shared encoderでもmismatched crop/normalizationは修復できません。
CEMはhorizon Hのcomplete action sequenceをsampleします。各candidateは同じcurrent latent historyから始まり、独自actionを受け取ります。frozen predictorが各sequenceをautoregressive rolloutします。baselineはlatent tokenを出し、videoではありません。またcalibrated confidenceなしのdeterministic pathを1本出します。
各candidateについて、frozen criterionはfinal predicted latentを取り、次を計算します。
J(a0:H-1) = sum_d (z_hat_H[d] - z_goal[d])^2scoreするのはterminal tokenだけです。wall、collision、intermediate safety、control effort、route length、support penaltyを明示的に見ません。squared Euclidean distanceはrepresentation learning後にcheap/parameter-freeですが、定義上reachabilityではありません。
CEMはlow-cost sampleをeliteにしaction proposalをrefitします。「best」は常に、このfrozen model、terminal cost、finite sample、recorded solver conventionの下での意味です。Appendix B本文はfinal proposal meanをreturnし、Algorithm 2はbest sampleまたはそのmeanのfirst actionも許します。LeWM repositoryはexternal solver revisionをpinしないため、exact reproductionでは記録が必要です。
したがってreward-free trainingとgoal-directed actionは両立します。task rewardなしでdynamicsを学び、inference-time objectiveがimagined futureの好みをsearchへ教えます。
だまされる仕掛け
fixed candidate populationを1回rolloutし、3つのsupported goal imagesだけをswapします。terminal latentは同じでcost orderだけ変わるはずです。rolloutが変わるなら、goalがdynamicsへleakしたかrandomnessが固定されていません。
次にimpossible/support-poor goalを使います。explicit abstention ruleを加えない限り、全candidateは数字を受け取り、CEMはplanを返します。numerical rankingはfeasibilityではありません。
protocol detailはresultを支配し得ます。LeWM v1/v2のTwoRoom goal offset/budgetは100/150、current v3は25/50へ改訂され、2 fieldsでrepositoryと一致します。独立auditは同じreleased weightsで2 protocol readingの14%対84%を報告しました。paired comparisonでは各episodeのrecorded targetと150-step budgetへ変えると84%から8%へ動きましたが、goal constructionとbudgetの両方が変わるためone-variable causal resultではありません。
実験レシート
LeWorldModel v3、固定jepa.py、eval.pyはfrozen goal-image planningとterminal latent costを裏づけます。
same-system Research Frontier follow-up arXiv:2608.12959v1は、1つのTwoRoom evidence chainでterminal latent L2がlong rangeで飽和後に低下し、alternative objectiveがbehaviorを変えたと報告しました。original LeWMにreachability headを加えるものでも、universal repairを確立するものでもありません。
3問クイックチェック
- dynamicsへ入る2 inputと、costだけへ入るinputは何ですか。
- unreachable goalでもCEM planが出るのはなぜですか。
- goal postcardだけswapしたとき、何が変わらないはずですか。