コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
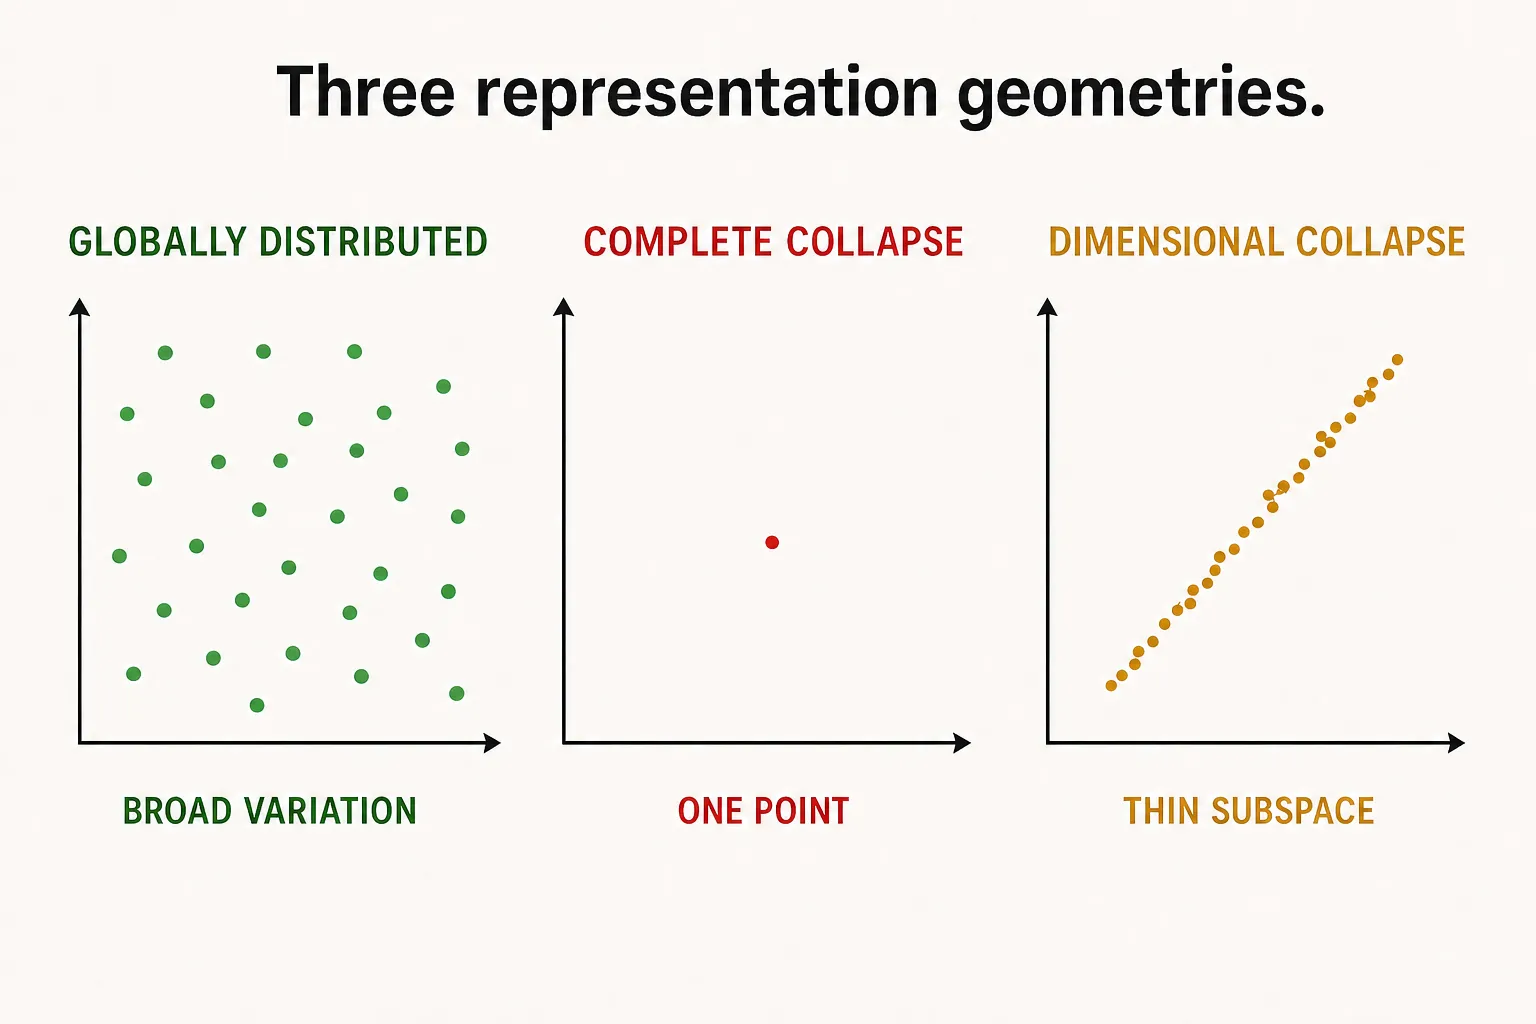
- 多くのscene部屋、door、motion
- 1つのcode全部同じになる
- 完全なcheatprediction gapはzero
小さなお話
全travelerへ同じcardを押すpassport officeを想像します。記録はすばらしく一貫します。どの「next passport」もpredictionと一致します。しかし誰も見分けられません。
これがcomplete representation collapseです。dimensional collapseはもっと微妙です。passportは変わりますが、ほとんどの情報が大きなlatent space内の1本のthin roadにあります。本当にlow intrinsic dimensionな世界もあるため、薄さはdata/taskに対するwarningであり、自動判定ではありません。
本当のルール
loopholeは4行です。
encode(any_image) -> the_same_vector
predict(any_vector, any_action) -> the_same_vector
prediction_gap -> zero
state distinctions -> gone
next targetも同じtrainable encoderが作るため成立します。fixed physical answer keyではありません。したがってprediction-only trainingはconstant solutionを許しますが、全low-loss runがそこへ行くとは限りません。
SIGRegはpopulation-shape targetを足します。1点の繰り返しはnon-degenerate isotropic standard Gaussianに一致できないので、exact constant shortcutはideal joint objectiveと衝突します。これは狭い主張です。broad cloudでもbackground colorをencodeし、actionを無視し、planningを惑わすgeometryを作れます。
collapseはoverfittingとも違います。train/validation両方でcollapseする場合も、training distinctionを豊かに残しながらgeneralizeしない場合もあります。representation structureとheld-out behaviorを別々に測ります。
役立つscreenは組み合わせます。
- 明らかなcontractionを見るper-coordinate variance
- rotated thin subspaceを見るcovariance spectrum
- matched runを比べるeffective rank
- pairwise-distance distributionとduplicate rate
- observationへ戻るnearest-neighbor panel
- control useを見るaction-swap sensitivity
どれもproofではありません。identity-like covarianceはsecond-order structureだけを見ます。full rankはdynamicsを証明しません。きれいなneighborがreachabilityではなくcolorに従うこともあります。
だまされる仕掛け
SIGRegあり/なしのmatched tiny TwoRoom runを学習します。各checkpointで同じprobe batchを使い、prediction loss、raw SIGReg、variance、covariance spectrum、effective rank、pairwise distance、neighbor、action swapを記録します。
hypothesisは「no-SIGReg runが必ずcollapseする」ではありません。「population termを除くと、predictionだけでは拒否できないtrivial optimumが戻る」です。cloudがbroadでもcomplete collapseを避けただけで、action/rollout testは必要です。narrow room cornerのrank numberより、diverse input batchがthin latent cloudへなる方が強い証拠です。
実験レシート
LeWorldModel v3はconstant shortcutを指摘しSIGRegを使います。LeJEPA v3はcomplete/dimensional collapseと、simple axis checkがdependenceを見逃すhidden-X exampleを動機づけます。固定train.pyはprediction、SIGReg、totalを別々にlogします。
single-seed独立TwoRoom reportのposition-probe Pearson correlationは0.9988で、paperの0.996に近い値でした。これはそのrepresentationからpositionがlinearly accessibleだったことを示します。SIGRegが原因、predictorがpositionを使う、physicsを学んだ、とは証明しません。
3問クイックチェック
- constant codeがperfect next-latent agreementを作れるのはなぜですか。
- dimensional collapseとoverfittingはどう違いますか。
- collapse診断に複数のlatent diagnosticsが必要なのはなぜですか。