コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 遅い鎖次の想像は前の一歩を待ちます。
- 大きな一歩prefix や階層が助けるかもしれません。
- 間違った行き先長い horizon でも悪い cost は直りません。
小さなお話:四つの旅行会社
宅配人が国を横断します。A 社は道を一つずつ描きます。B 社は「最初の 1、2、3、4 個の指示ならどこへ着く?」を並列に尋ねます。C 社は再利用できる列車区間で計画します。D 社は、goal に近く見えるのに線路が一本もない魔法の駅を発明します。
どれも「長距離計画」を名乗れますが、直す場所は違います。baseline LeWorldModel v3 は latent state を autoregressive に進めます。candidate plan は横に並べられても、各 plan の時間は逐次的です。後の prediction は前の predicted state を入力にするため、計算と model error が積み重なりえます。
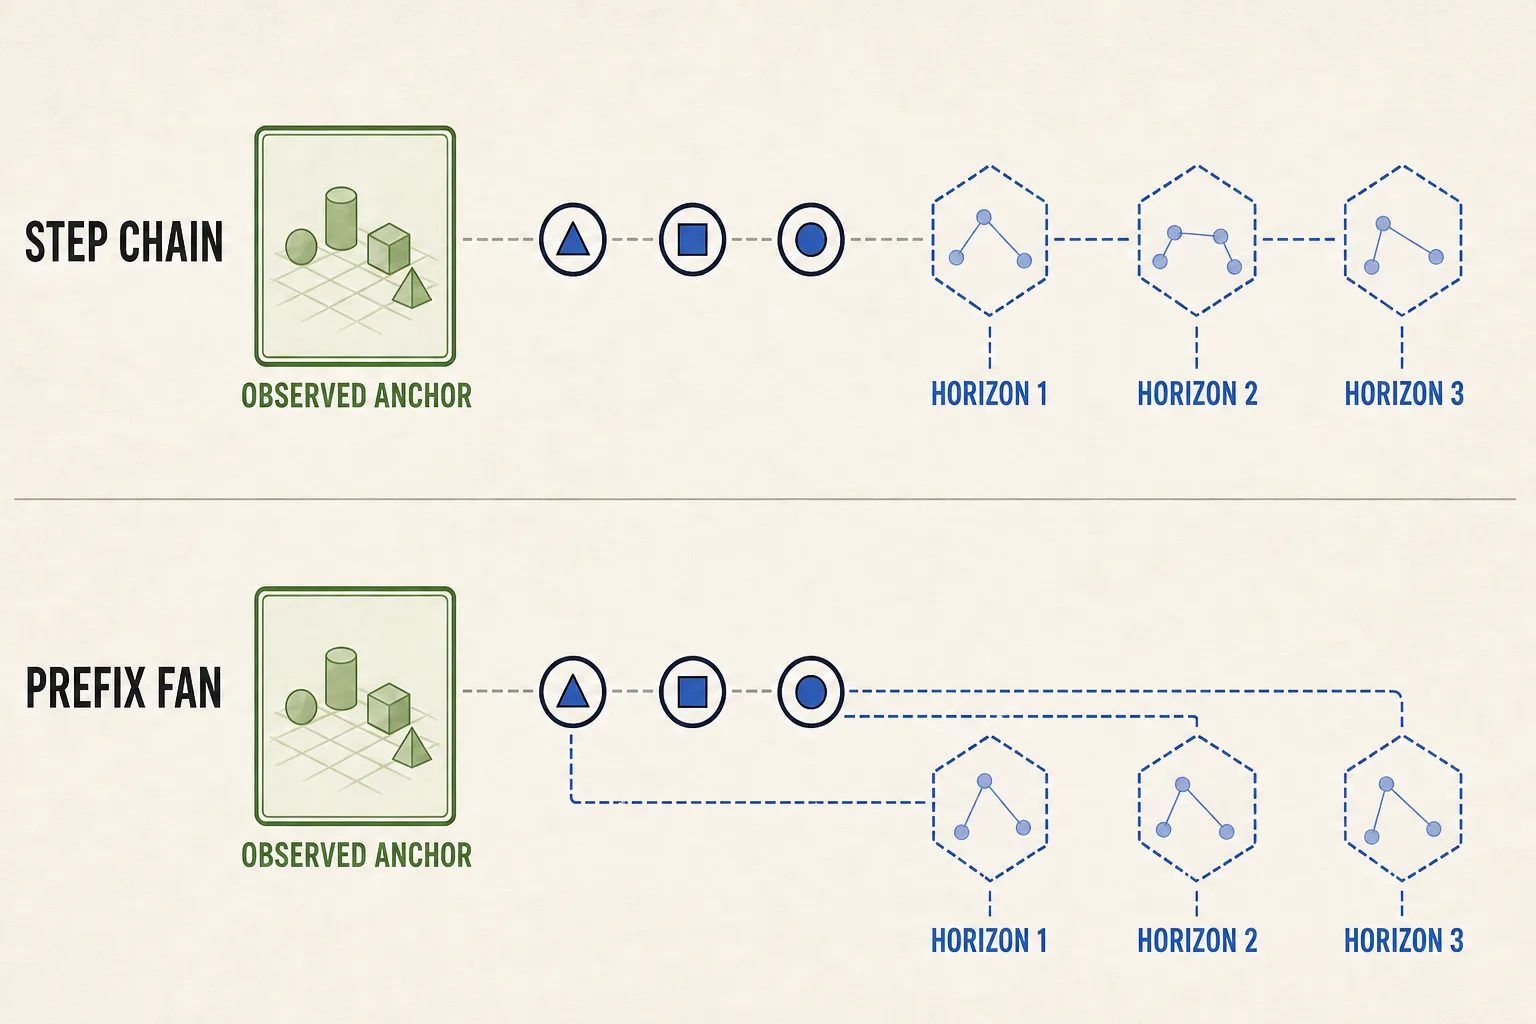
扇型は prediction interface を変えます。複数の確率的未来を作ること、calibration、action search の不要化を意味しません。
技術のリュック
| ルート | 正確な介入 | 必ず残す境界 |
|---|---|---|
| Baseline v3 | CEM/MPC 内の one-step self-fed latent rollout | candidate 並列化は時間依存を消しません |
| Fast-LeWM | 観測 anchor から複数の prefix horizon を並列予測 | “multiple futures” は複数時点で、multimodal outcome ではありません。encoding、sampling、scoring、model error は残ります |
| VLWM, Beyond the Next Step | chunk schedule を用いる variable-length direct prediction | Fast-LeWM ではありません。報告 13% 平均は training seed 3072 と各 (dataset, Δ) での事後的 best P1/P2/P3 選択です |
| 2024 hierarchical RSSM study | 粗い時間階層と abstract action を学習 | “HWM” は本教材の略称で、論文の正式 method 名でも LeWM variant でもありません |
| Hi-LeWM | 凍結した low-level LeWM の上で high-level CEM が latent subgoal を提案 | 制約なし macro-action と subgoal は training support 外へ出られます。階層は自動的に優れません |
役立つ階層には、再利用できる chunk、高レベル化で節約する量より誤差が遅く増える high-level model、low-level controller が本当に到達できる subgoal、両層の十分な search budget が要ります。empirical-macro search は観測 anchor の近くに提案を置けますが、data に近いことは reachability や safety の証明ではありません。
horizon を増やす前に terminal metric を検査してください。独立 TwoRoom follow-up は、監査した checkpoint と protocol で cost だけを変えると遠い goal の結果が大きく改善したと報告します。これはその条件で planner interface の bottleneck を示しますが、すべての long-horizon failure が cost 原因だとは証明しません。
壊してみる
完璧な low-level driver に、不可能な high-level station を与えます。その駅は latent Euclidean distance では goal に近いのに、encoded macro-action 集合の外で壁の向こうです。high-level horizon と CEM population を増やします。不可能な駅をもっと自信満々に選べば、強い探索が support mismatch を増幅しました。
次の四条件を固定比較します。baseline rollout、prefix prediction、自由な latent subgoal を持つ階層、empirical macro-action に制約した階層です。data、encoder、low-level model、action budget、candidate accounting、goal、seed を同じにします。wall-clock、model call、rollout error、support distance、subgoal feasibility、closed-loop success を記録します。hardware と budget を合わせない speedup は持ち運べる倍率ではなく、到達可能 subgoal を確認しない成功差は階層の証拠ではありません。
実験レシートと証拠の境界
- Baseline: LeWorldModel v3、凍結 code
8edfeb3、2026-06-03 改訂。 - 後続 method: Fast-LeWM v1、code
492752d、2026-06-24 公開。VLWM v1、2026-06-19 公開、author-linked code は未確認。Hi-LeWM v2、code4bb21a2と Zenodo artifact、2026-07-15 改訂。 - 隣接研究と監査: 2024 hierarchical RSSM study、TwoRoom reproduction、Objective Is the Bottleneck、tinylab
efa9e5d。 - 証拠 cutoff は 2026-08-20、Asia/Tokyo。後続の性能・効率主張は著者報告です。独立 reproduction は明記した TwoRoom 再実装と protocol だけです。hardware、horizon、candidate budget、baseline implementation を speed claim から外せません。
3つのクイック質問
- candidate を vectorize しても、baseline rollout のどこが逐次のままですか?
- 到達できそうな latent subgoal が、なぜ low-level controller には使えないことがありますか?
- 長い horizon に計算費を払う前に、何を診断しますか?