コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 本物の frame[B,T,C,H,W]
- 潜在の旅[B,T,D]
- 1 つ shiftcontext → next target
- たくさんの未来[B,N,H,D]
小さな物語
2 個のスーツケースが同じ大きさでも、別の飛行機の荷物かもしれません。テンソルも同じです。reshape は値を全て保ちながら、時間を候補 ID に変えられます。broadcast は期待通りの shape を作りながら、goal を間違った軸にコピーできます。プログラムは動きますが、物語は壊れています。
毎回この名前を使います。B は batch、T は記録観測位置、C は channel、画像 H/W は空間サイズ、D は潜在幅、N は候補列、計画 H は model horizon、U は control block 幅、F は model step あたりの環境 tick、A は action 幅、P は画像 patch 数、Dv は内部 vision 幅です。H の二重使用は危険なので、必ず画像高さまたは計画ホライズンと言います。
shape のバッグ
レーン 1:観測が状態カードになる
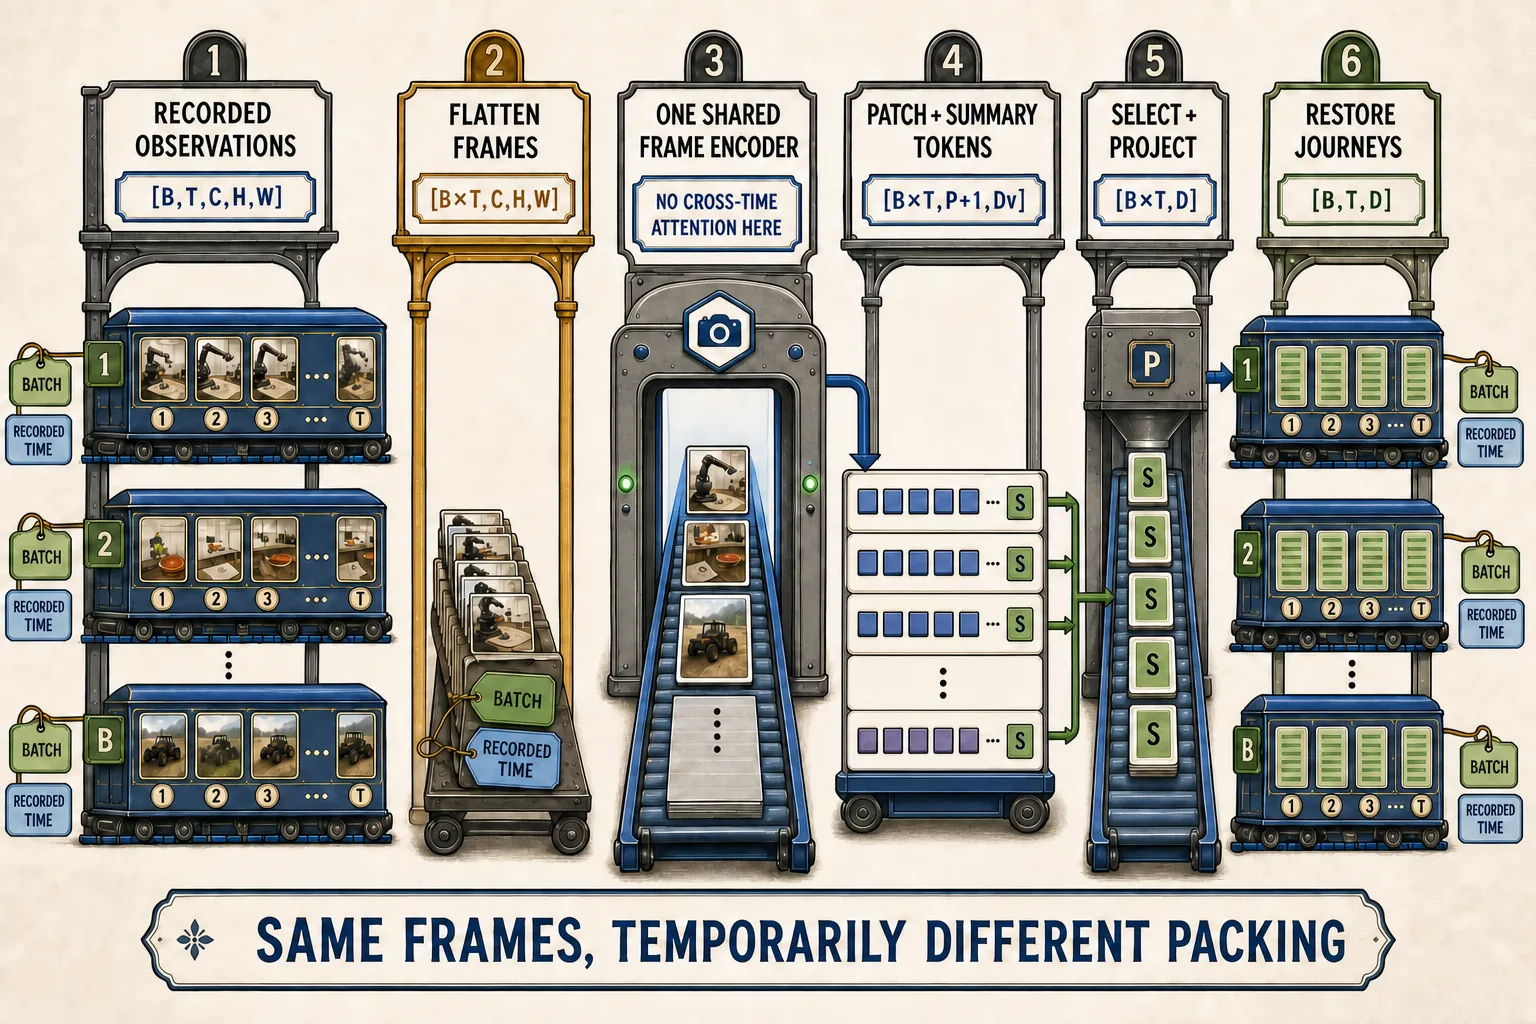
視覚エンコーダは frame を独立に処理します。batch と記録時間を一時的に frame batch へ畳み、各画像を符号化し、summary token を選び、投影して、旅を復元します。
| 停留所 | Shape | 意味 | 気付きにくい危険 |
|---|---|---|---|
| 読み込み観測 | [B,T,C,H,W] | 例、記録時刻、channel、画像高さ、幅 | 旅の中で frame を shuffle |
| frame batch | [B×T,C,H,W] | 独立 frame、channel、高さ、幅 | B と T を逆順に戻す |
| ViT token | [B×T,P+1,Dv] | frame、patch と summary、vision 幅 | patch 順を episode 時間と誤解 |
| 投影 frame | [B×T,D] | frame、潜在特徴 | 間違った token または layer を選ぶ |
| 潜在の旅 | [B,T,D] | 例、記録時刻、潜在特徴 | batch と時間を静かに入れ替える |
[B,T] の flatten は視覚エンコーダに時間 attention を与えません。独立 frame のバッチを大きくするだけです。P、Dv、D は、数値が偶然等しくても別の役割です。
レーン 2:行動は遷移と対応する
行動は画像 channel として入りません。凍結 baseline では、F=5 個の連続した環境行動が 1 個の model-step control block になり、action encoder がそれを幅 D へ写像します。
| 停留所 | Shape | 意味 | 気付きにくい危険 |
|---|---|---|---|
| raw action block | [B,T,F×A] | 例、model 位置、まとめた control | episode 境界を越える |
| encoded action | [B,T,D] | 例、model 位置、条件付け特徴 | action を 1 遷移後ろにずらす |
| training action context | [B,T-1,D] | 遷移元の位置 | 最終 slot を余分な target にする |
読み込み観測と行動はどちらも長さ T でかまいませんが、1 ステップ目的は最初の T-1 個の遷移元行動だけを使います。shift しても変わらない全 0 action ではなく、見分けられる action で対応を試します。
レーン 3:1 つずらした zipper
4 個の encoded observation があるとき、契約はこうなります。
z0 と a0 -> p1 を connected z1 と比較
z1 と a1 -> p2 を connected z2 と比較
z2 と a2 -> p3 を connected z3 と比較| オブジェクト | Shape | 役割 |
|---|---|---|
| state context | [B,T-1,D] | 実観測を符号化した遷移元 |
| action context | [B,T-1,D] | 遷移元に対応する action |
| predictor output | [B,T-1,D] | 予測した後継状態 |
| shifted target | [B,T-1,D] | 実観測を符号化した後継位置 |
| SIGReg view | [T,B,D] | 各記録時刻を batch 集団越しに見る |
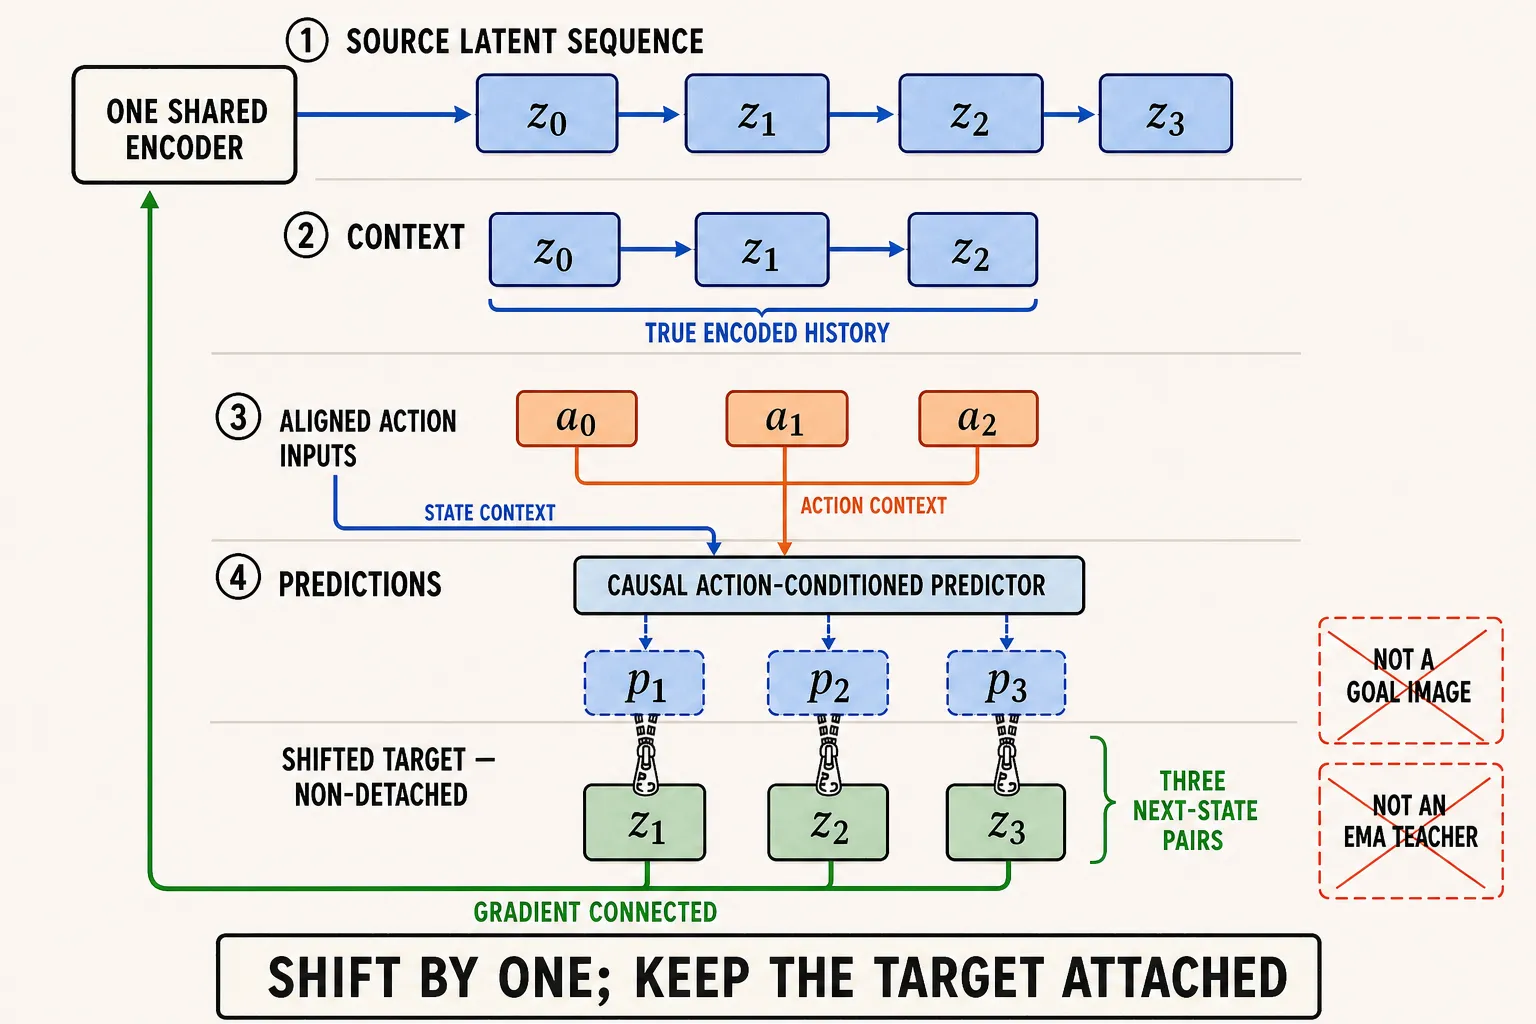
予測と target の shape 一致は必要ですが、十分ではありません。p1,p2,p3 を z0,z1,z2 と比べても scalar は返り、別の関係を学びます。オリジナル LeWM v3 では、z1,z2,z3 は同じ共有学習可能エンコーダから作られ、接続されたままです。stop-gradient、EMA teacher、事前学習済み凍結エンコーダはありません。detach は shape を変えず graph を変えます。
レーン 4:計画が候補レーンを開く
仮定行動ごとの実未来 frame はありません。計画は 1 個の観測された現在状態を候補レーンに複製し、凍結 predictor を自己回帰的に前進させます。
| オブジェクト | Shape | 役割と許可されるコピー |
|---|---|---|
| current state | [B,D] または history-aware な同等物 | candidate 軸にだけ繰り返す |
| candidate actions | [B,N,H,U] | 問題、candidate、model horizon、control block |
| predicted rollout | [B,N,H,D] | 各 candidate 内の時間は連続的 |
| encoded goal | [B,D] | candidate 終点にだけ繰り返す |
| terminal endpoints | [B,N,D] | candidate ごとの予測終点 |
| candidate cost | [B,N] | action sequence への対応を保つ |
GPU 実行で [B,N] を flatten できますが、candidate 所有関係を復元します。goal は同じ目的地に向かうので candidate 軸にコピーされますが、predictor time への training supervision ではありません。
凍結された数値カード—普遍定数ではない
調査対象 code の checked-in default は batch 128、history size 3、そのため読み込み観測 4、潜在幅 192、1 ステップ shifted target、model 位置あたり環境行動 5 を使います。具体的な prediction/target shape の 1 つは [128,3,192] です。
paper は TwoRoom に history 1、PushT と OGBench-Cube に 3 を報告します。凍結 global default は 3 で、data config は override しません。[B,T,D] は記号契約、[128,4,192] は 1 つの凍結 code 実例です。paper、frozen code、resolved run を常に分けます。
だまされる仕掛け
dashboard は、画像が 5-D、予測と target が [128,3,192]、candidate cost が [1,1024]、total loss が scalar と表示します。全ランプが緑です。しかし target は unshifted、candidate と horizon は両方が長さ 5 のときに入れ替わり、goal は candidate でなく time にコピーされていました。
2 つの episode ID、異なる time mark、異なる candidate ID、繰り返さない action を入れた小さな marked batch で修理します。その後、後の token、1 candidate action、1 goal をそれぞれ変えます。これは配管の不変条件を確かめますが、model accuracy の証明ではありません。
実験のレシート
LeWorldModel v3 と凍結した公式 train.py、jepa.py、module.py、configuration files が、ここで示した経路と凍結 default を裏付けます。
許される主張は、忠実な実装は storage を並べ替えても、名前付きの observation、time、action、candidate、horizon、target、latent の役割を守ることです。shape assertion の合格は alignment、broadcasting、gradient flow、planning semantics、paper reproduction を証明しません。ここで独立再現は確立していません。
3 問だけ確認
[B×T,C,H,W]は、なぜそれだけで時間 attention を作らないのでしょう?p1,p2,p3に対応する target は何で、間違った target が shape check を通るのはなぜでしょう?[B,N,H,D]で並列実行できる軸はどれで、どの依存関係が逐次的に残りますか?