コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 見る壁と出入口
- 分岐する複数の行動を試す
- 比べるどの未来がよい?
- 計画し直すもう一度見る
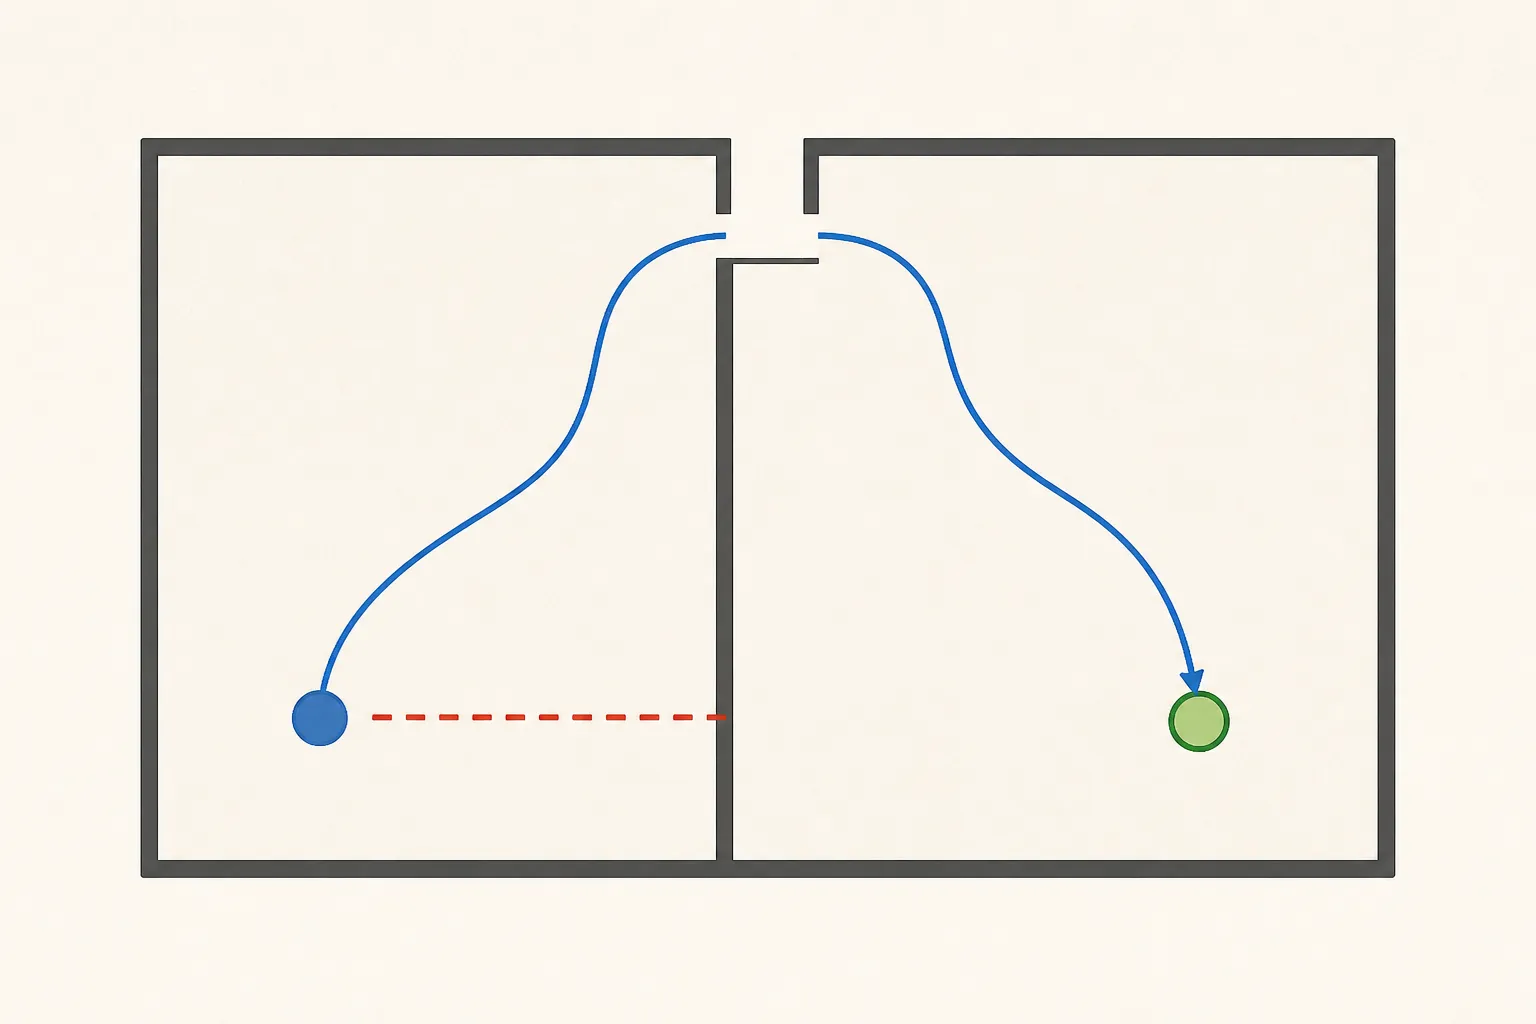
小さなお話
ロボットが壁、出入口、目標を完璧に見分けても、壁へ突進することがあります。「今すぐ目標に近づく行動」だけを選ぶからです。本当に役立つ経路は、いったん目標から離れ、出入口を通り、向こう側で戻ります。
名詞が見えるだけでは足りません。行動には目的、結果のモデル、そして時間が必要です。直接方策も履歴を使う強力な仕組みになれます。違いは、世界モデル付きプランナーが意思決定時に候補未来を明示的にロールアウトして探索することです。
本当のルール
このコースでの「想像」は人間の心の映画ではなく、条件付き計算です。
現在の潜在履歴 + 提案行動 -> 次の潜在状態の予測LeWMのエンコーダーは現在の状況を潜在空間で表し、予測器は「この行動なら次に何が起きるか」を問います。意思決定用シミュレーターには3つが必要です。
- 行動感度:現実の結果が違う行動なら予測も変わること。
- ロールアウト:予測状態をもう一度先へ進められること。
- 意思決定口:想像した結果を目標やコストと比べられること。
中核モデルが予測するのは潜在状態であり、未来動画ではありません。論文の補助decoderは観察用で、学習対象でもプランナーでもありません。1本の決定論的予測は複数の可能な未来を隠し得ます。baseline interfaceには較正済み不確実性分布がありません。
MPCは計画を仮のものにします。行動系列を提案し、終端を想像し、評価し、設定された先頭部分だけ実行して、もう一度観測します。LeWM v3の報告設定ではhorizonは5 model stepsで、5つすべてを実行してから再計画します。1 model stepに5 environment actionsが入るため、feedbackは25 environment steps後です。1行動ごとのループもMPCですが、この報告設定の再現ではありません。
baselineの終端scoreはencoded goalへのsquared Euclidean distanceです。便利な潜在定規ですが、到達可能性、経路長、移動時間そのものではありません。
だまされる仕掛け
先読みを外すと、greedy agentは目標へ近づこうとして壁に沿い続けます。feedbackを外すと、最初は妥当だった経路が、観測可能な障害の出現後も古いまま残ります。MPCを加えれば迂回できる場合がありますが、それは観測、表現、モデル、コスト、探索が役立つ場合だけです。
同じ衝突でも、始まりは別々です。
- 知覚:潜在表現が壁や動きを落とした。
- 想像:予測器が壁を通る、または長期でdriftした。
- 選択:コストが誤った終端を好む、またはCEMが出入口を見つけない。
同じ偽の近道を毎回描くモデルは、再計画しても直りません。最終的な失敗だけでは原因を特定できません。
実験レシート
LeWorldModel v3と固定公式リポジトリは、pixel encoder、action-conditioned latent predictor、autoregressive rollout、terminal latent cost、CEM探索、設定可能なMPC prefixを裏づけます。repositoryはplanning/evaluationの一部をstable-worldmodelへ委ねるため、solver conventionは推測せず記録する必要があります。
TwoRoomの迂回、閉じた出入口、3段階の診断は教材用です。先読みとfeedbackが重要になり得る理由を示しますが、すべての直接方策が失敗することや、すべてのmodel-based controllerが成功することは証明しません。
3問クイックチェック
- なぜ目標から離れる動きが正しい最初の行動になり得るのでしょうか。
- どのようなaction-swap結果なら、予測器が行動を無視している疑いがありますか。
- MPCが新しい観測を得ても繰り返し得る誤りは何でしょうか。