コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 分かった海岸working pipeline は名指せます。
- 点線の海岸複数の説明がまだ残ります。
- 次の航海説明を分ける test を選びます。
小さなお話:未完成の地図帳
地図帳では、船が測った海岸は実線、複数の形がありうる場所は点線です。慎重な地図職人は、最新の旅行者が好きな絵で点線を埋めません。
この course の実線の spine は控えめです。pixel を observe し、useful latent state に compress し、action-conditioned future を imagine し、CEM/MPC で search/act し、imagination が unreliable な場所を diagnose します。frontier は、どの geometry、target、uncertainty、hierarchy、support rule、successor paradigm がこの loop に合うかを問います。新しい paper は candidate と author-reported evidence を出しますが、点線を consensus にしません。
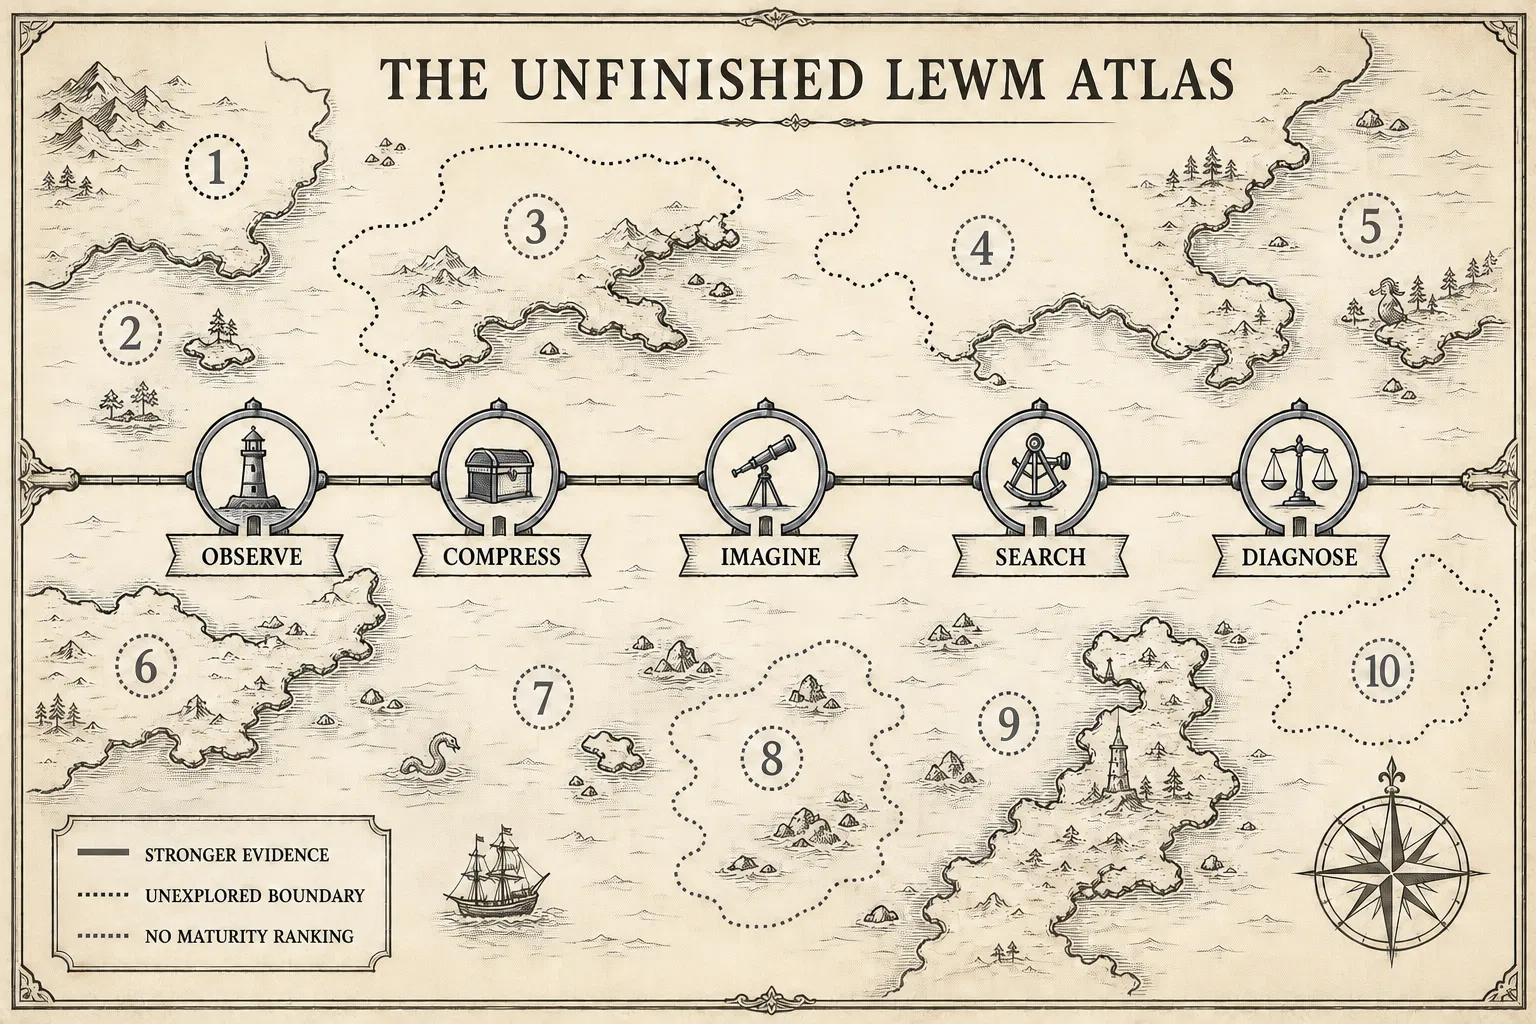
この map は question を整理します。paper を順位付けせず、どの route が勝つかも予言しません。
技術のリュック:十の open question
| # | Open question | Competing hypothesis | 役立つ discriminator |
|---|---|---|---|
| 1 | planning に適した geometry は? | Euclidean proximity、directed reachability、task progress、trajectory cost、uncertainty-aware decision ranking が task ごとに優位かも | matched open-room、wall、contact、budget sweep と oracle ranking |
| 2 | non-collapse に global distribution matching は必要? | full Gaussian pressure、subspace/local matching、temporal centering、transition-derived action objective のどれでも足りるかも | equal-data anti-collapse test と topology、slow-variable、tail、planning check |
| 3 | 複数の可能な future をどう表す? | conditional mean で control に十分か、explicit branch/distribution が必要か | mean が物理的に存在しない calibrated multimodal environment |
| 4 | imagination が support 外だとどう知る? | ensemble disagreement、predictive spread、nearest-data distance、action-conditional consistency、realized error のどれがよいか | controlled support removal と後の ground-truth rollout error |
| 5 | offline behavior から controllability を学べる? | inverse action / action-sensitive branch で十分か、state-conditioned intervention 欠如が ambiguity を残すか | state を固定し、action direction を見せる/隠す |
| 6 | long goal に explicit hierarchy は必要? | prefix prediction、良い cost の flat MPC、learned chunk、latent subgoal のどれでも足りるかも | horizon 間で model-call、action、latency、support budget を match |
| 7 | latent state はどれほど大きくすべき? | wide latent が rare distinction を守るか、capacity を浪費して low intrinsic dimension と衝突するか | compute-fixed width/rank sweep と collapse、rollout、planning diagnostic |
| 8 | task-agnostic と task-effective representation は衝突する? | invariance が transfer を助けるか、task context / privileged grounding が必須か | factor-isolated nuisance/task intervention と held-out task composition |
| 9 | predicting から explaining へどう進む? | probe/counterfactual prediction で mechanism が見えるか、causal assumption を持つ intervention だけが説明を支えるか | correlation、use、causal effect を分ける preregistered intervention |
| 10 | 何が LeWM line を置換・吸収する? | branching prediction、unified JEPA objective、amortized/search-free control、value-shaped geometry、別 world-model paradigm | prediction、counterfactual、support、planning、transfer、compute、safety の共通 load test |
question は相互作用しますが、一つの scoreboard に潰せません。model はよく predict して plan ranking を誤れます。一 planner で useful でも identifiable とは限りません。public code があっても independently reproduced とは限りません。一 GPU budget で速くても support-shifted goal に弱いかもしれません。
壊してみる
Cedar と Comet という二 system を作ります。average one-step loss と average success は同じです。Cedar は近い goal に成功して across-wall goal に全敗します。Comet は across-wall goal に成功しますが visual change 後に失敗します。一平均では同じでも、二つの world は違います。
goal type、horizon、support、visual intervention、planner budget、failure trajectory を開示します。次 experiment は別です。Cedar には geometry/cost test、Comet には nuisance/representation test が要ります。だから open question には aggregate leaderboard の追加ではなく discriminator が要ります。
proposed successor ごとに、名前を褒める前に load-test ledger を凍結します。training information、target graph、future representation、action interface、model call、search budget、hardware、data support、transfer split、safety mechanism です。新 paradigm は一列に勝ち別列に負けられます。“LeWM を置き換える” は宣言した evidence が出るまで speculation です。
実験レシートと証拠の境界
- Baseline coordinate: LeWorldModel v3 と LeJEPA v3。direct update は TRM、SMWM、VLWM、PSG-JEPA、TwoRoom reproduction、VIScore、ACPC、Objective Bottleneck、Traj-LeWM、SCALE、AC-MTM、DA-LeWM です。
- Neighboring route は Branch-JEPA v3、UniJEPA、Qantara、INTACT です。LeWM version ではなく、隣にあるだけで replacement にはなりません。
- LeJEPA v3 は 2025-11-14、LeWM v3 は 2026-06-03 改訂。最新の named direct update は DA-LeWM v1 の 2026-08-19。evidence cutoff は 2026-08-20、Asia/Tokyo。baseline code は
8edfeb3に凍結し、他の inspected revision も動くmainではなく Appendix E の記録に固定します。 - baseline と最新項目のうち SMWM、PSG-JEPA、tinylab、VIScore、ACPC、Traj-LeWM、AC-MTM、INTACT で author-linked code を確認し、TRM、VLWM、SCALE、DA-LeWM では未確認です。independent reproduction は明記した TwoRoom environment と protocol だけです。他の result は各 author の task、supervision、planner、compute、assumption を保ちます。
3つのクイック質問
- broad unknown を scientific open question に変えるものは何ですか?
- equal average loss/success が異なる world-model failure を隠せるのはなぜですか?
- proposed successor 同士で “better” を意味ある語にするには、どの evidence field を共有すべきですか?