コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
- 同じ現在1本のlatent history
- 行動Acontrol knobを回す
- 行動B別方向へ回す
- 別の枝next latentを比べる
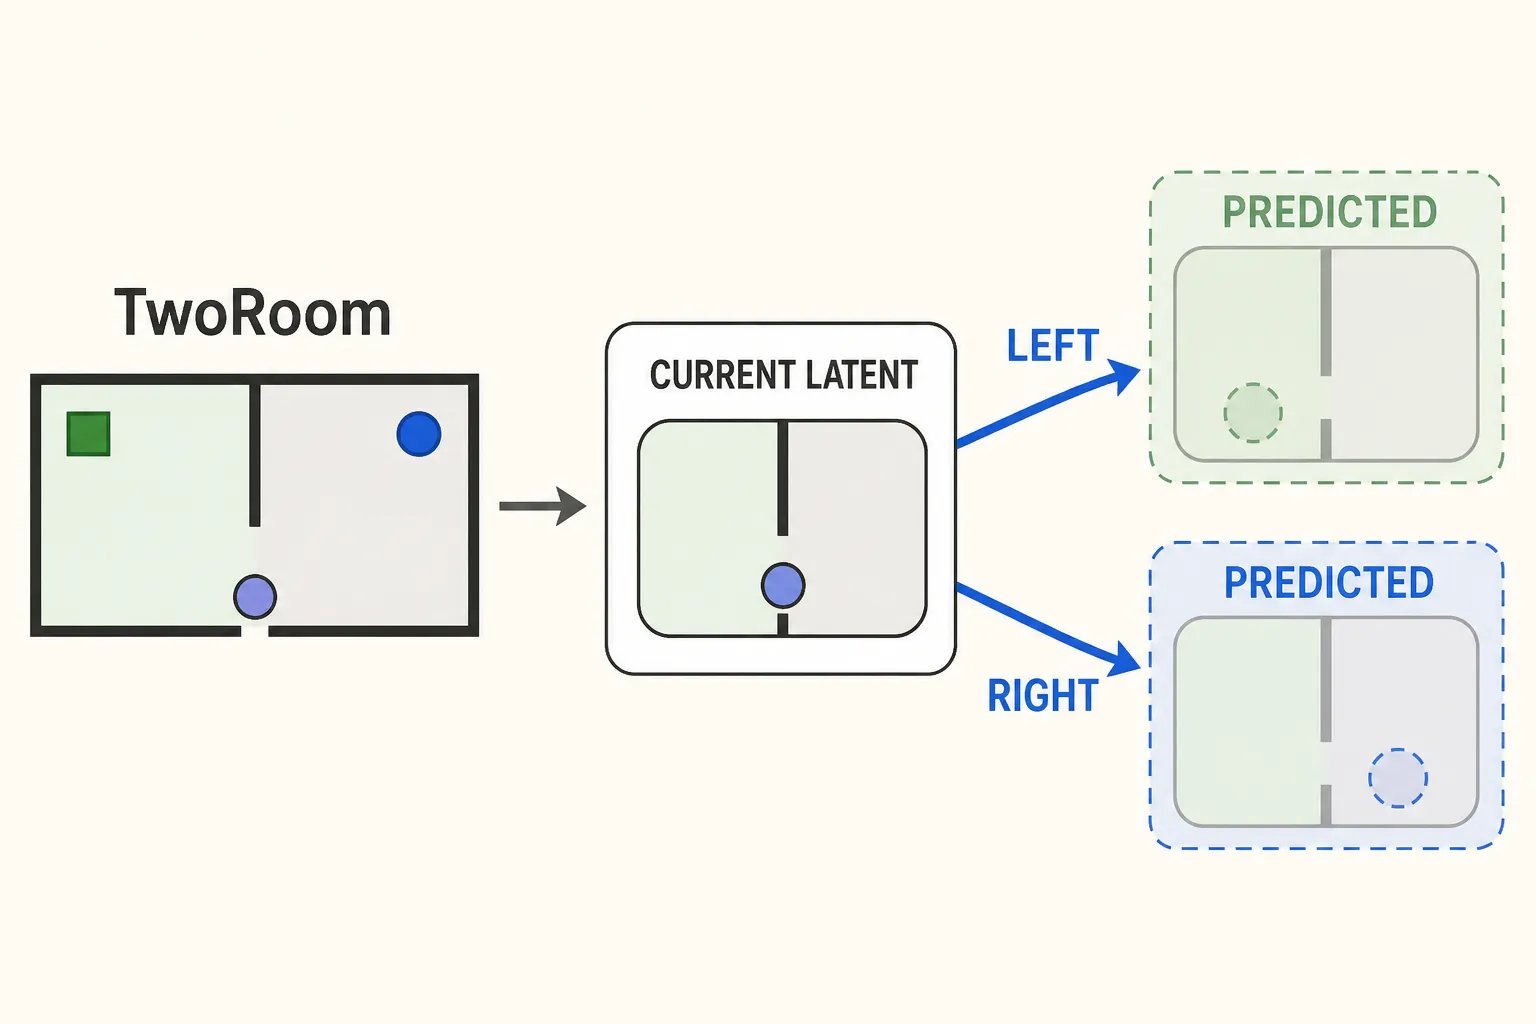
小さなお話
agentをdoorwayの下に置きます。current imageだけでは明日を選べません。「左」「右」「停止」でsuccessorは変わります。encoderは小さな名詞、つまり状況を渡します。dynamics predictorは動詞、つまりaction-conditioned changeを渡します。
historyは1 frameから見えないmotionを補えますが、hidden force、contact mode、occluded objectのすべては明かせません。出力はdeterministic latent estimateであり、real futureが1つだけという約束ではありません。
技術バックパック
conceptual interfaceは次です。
state_history  = encode(observed_frames)     # [B,T,D]
action_history = encode(action_blocks)       # [B,T,D]
next_guesses   = causal_predict(state_history, action_history)
frozen data configはframeskip=5です。1 model stepには5 consecutive environment actionsが入ります。dense blockをflattenし、width Dへ写します。action embedderはwidth-one temporal convolutionと小さなmultilayer mapを使うため、そこで隣接time positionsは混ざりません。temporal mixingはcausal Transformerで起きます。
paperは6-layer predictorと10% dropoutを記述します。actionはAdaLNを通じ各conditional Transformer blockへ入ります。action pathはattention branchとfeed-forward branchそれぞれにshift、scale、residual gateを作り、合計6 controlsです。final modulation layerはzero-initなので、初期状態のaction modulationはneutralで、学習により大きくなれます。
AdaLNはcontrol cableを設置しますが、trained modelが聞く証明ではありません。causal maskもfuture tokenの覗き見を防ぐだけで、causal physicsを証明しません。future-mutation checkでは、later inputを変えてもearlier outputが変わらないことを確かめます。
frozen four-observation defaultでは3 pairすべてを揃えます。
context:      z0  z1  z2
actions:      a0  a1  a2
predictions:  p1  p2  p3
targets:      z1  z2  z3
これがteacher forcingです。contextはrecorded encoded observationから来ます。teacher encoderではありません。planning時にはrolloutがp1をappendし、自分の出力を次第に多く含むhistoryから次を予測します。frozen codeはconfigured history windowの最新部分だけを残します。
だまされる仕掛け
data、model size、budgetを揃えたまま、全action blockをzeroへ置換してaction channelをmuteします。behavior policyがいつも同じrouteを取るなら、muted modelもaverage continuationをよく予測できるかもしれません。
次にleft/rightでrecorded successorが異なるsupport内doorway contextを選びます。visual historyを固定してactionだけswapし、predicted separationをencoded real successor間のseparationと比べます。free spaceで2 tiny actionsが本当に似るcontrolも入れます。
3 metricsは分けます。teacher-forced one-step error、action-swap sensitivity、horizon別open-loop errorです。step oneでは効いたactionが後で消えることも、低one-step errorとdriftが共存することも、良いrolloutをbad planner costが誤順位にすることもあります。
実験レシート
LeWorldModel v3と固定module.pyはcausal attentionとAdaLN pathを裏づけます。固定jepa.pyはautoregressive append-and-truncate rolloutを裏づけます。
許される主張は、v3がaction-conditioning route、causal training context、autoregressive planningを持つことです。AdaLNがcontrollabilityを証明する、teacher forcingがEMA teacherを意味する、全LeWM stepが5 raw actionsである、low one-step errorがplanningを保証する、とは言えません。
3問クイックチェック
- AdaLNは何を可能にし、何を証明しませんか。
- ここでのteacher forcingがteacher–student architectureでないのはなぜですか。
- local prediction、action use、rollout stabilityを分ける3 diagnosticsは何ですか。