コース進捗 コース目次 48レッスン中 48件を公開中
第0部 読み方ガイド:私たちは何を学ぶのか
第1部 世界モデル:エージェントの頭の中にある実験場
第2部 画面を状態に変える:LeWMのモデル構造
第3部 モデルの抜け道を防ぐ:予測損失とSIGReg
第4部 モデルを行動に使う:潜在空間での計画
第5部 エンジニアリング再現:論文から動くシステムへ
第6部 LeWMは何を学んだのか
第7部 「予測が正確」でも「計画がうまくいかない」のはなぜか
第8部 再現者から研究者へ
付録 数学・実装・再現・査読のための参照資料
まず大きな絵
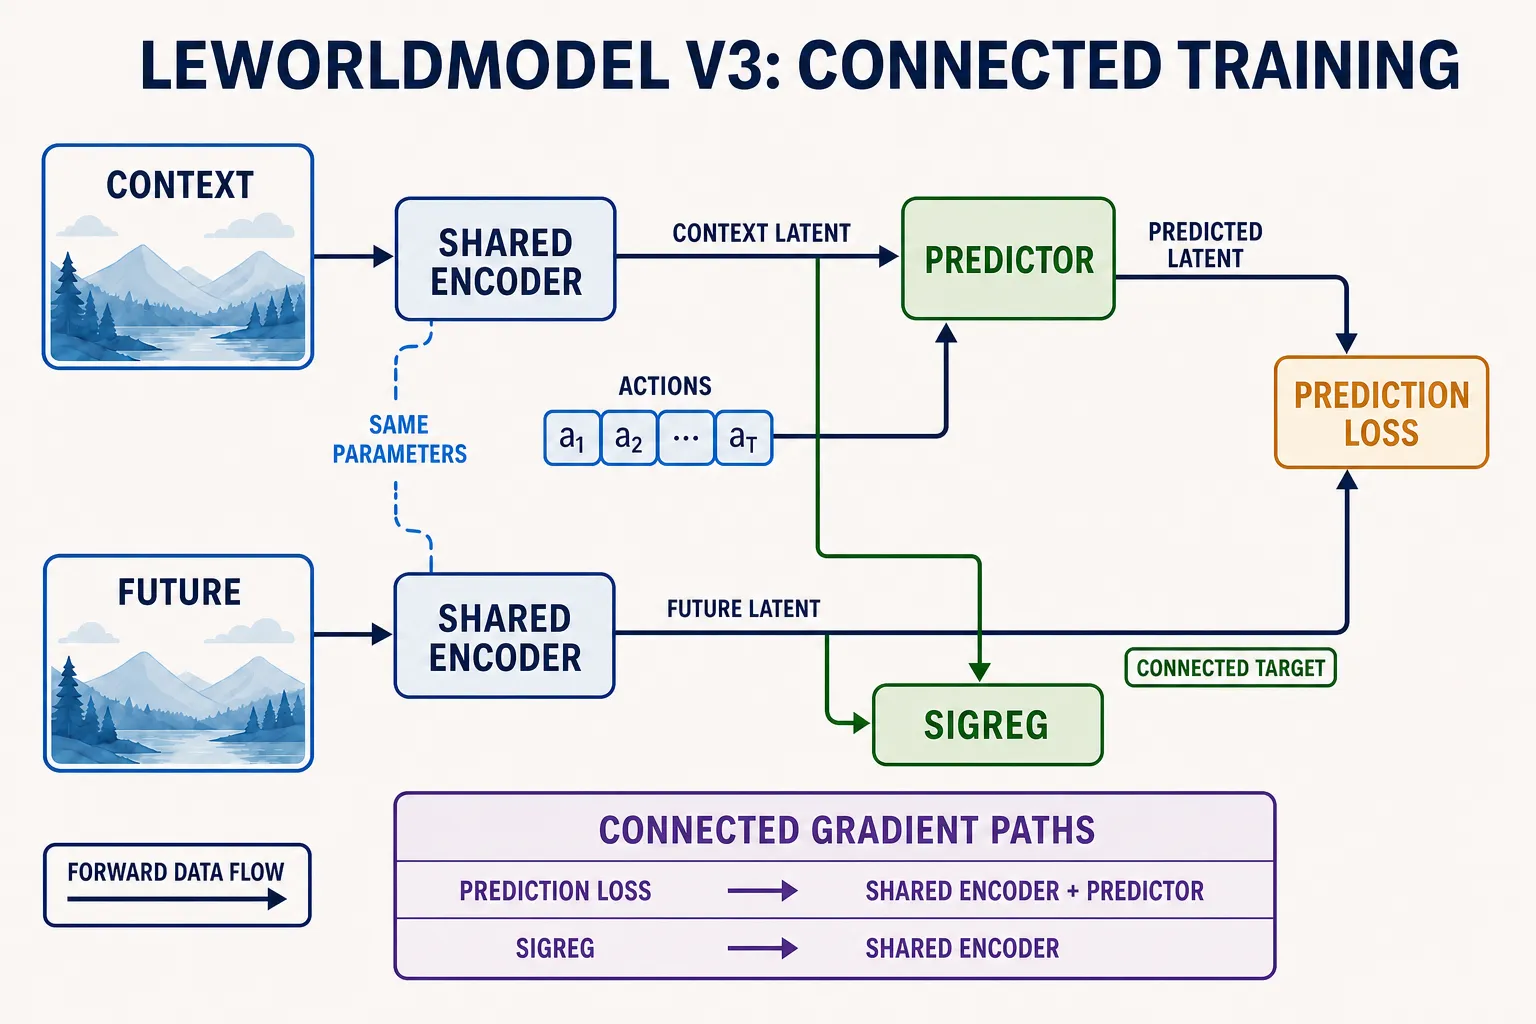
- 1 encodercontextとfuture
- actionpredictorを条件付け
- connected targetstop signなし
- SIGRegconstant cheatに圧力
小さなお話
簡単ですが誤ったsketchには、context encoder、薄いtarget tower、stop sign、EMA arrowがあります。BYOL、I-JEPA、V-JEPAの名前付きversionが近いtarget mechanismを使うため、見慣れています。しかしoriginal LeWM v3ではありません。
LeWMは、mapmakerとroute-rule learnerが1つのlive mapを一緒に編集するようなものです。SIGRegは全addressが1 lotになるのを防ぐzoning ruleです。zoningはcityを広げてもroadを正しくしません。
技術バックパック
v3 training topologyは次です。
observations -> one shared trainable encoder -> all latents
context latents + recorded actions -> predicted future latent
predicted future <-> connected future latent
observation latents -> SIGReg
one total objective -> joint updatetargetは「predictionと比較するもの」を意味します。weight ownerやupdate ruleは決めません。frozen train.pyは同じencoded sequenceからfuture latentをsliceし、prediction loss前にdetachしません。そのためprediction pressureはcontext useとfuture useの両方からshared encoderへ届き、action encoder/predictorへも届きます。
Gaussian referenceはanalyticで、learned teacherではありません。recorded next observationはdataで、teacher networkではありません。original v3はvisual pretrainingもoffです。「from scratch」はvisual encoderがないのではなく、external pretrained checkpointから始めないという意味です。
predictionだけなら全placeに同じaddressを付けられます。ideal SIGReg targetでは、repeated pointはnon-degenerate isotropic Gaussianに一致できません。joint objectiveは最も簡単なexact constant solutionへ圧力をかけます。しかしfinite optimizationでcollapseを不可能にしたり、spread representationにrare task variableを必ず残したりはしません。
「end to end」はtraining boundaryで止まります。dataset constructionは学習されません。後のCEM planningではencoder/predictor weightをfreezeし、planning gradientが戻って再学習することもありません。
名前付きgraphは別々です。BYOL v3、I-JEPA v3、V-JEPA v1は引用recipeでstop-gradient/EMA target mechanismを使い、LeWorldModel v3はshared connected encoder+SIGRegです。これはmechanism comparisonであり、異なるdata/task間のperformance rankingではありません。
だまされる仕掛け
3つの.detach()はkeyword searchでは同じに見えても意味が違います。
- training loss前のfuture target detach:手法を変える。
- loss後のmetric copy detach:logging bookkeeping。
- frozen planning中のgoal detach:そもそもmodel update不能。
value、timing、phaseをauditします。次にtiny topology probeをします。
A: future target connected
B: comparison前にfuture targetをdetach
C: target connected + SIGReg
hookではBだけtarget-side prediction routeが消え、Cではencoder-side population routeが加わるはずです。1 batchが示すのはconnectivityであり、どのvariantがよくtrain/planするかではありません。
実験レシート
graphはLeWorldModel v3、固定train.py、固定model/lewm.yamlに基づきます。比較はBYOL v3、I-JEPA v3、V-JEPA v1へversion固定します。
許される主張は、LeWM v3がfully end to endであり、それらnamed stopped-target/EMA recipeと構造的に異なることです。EMAがobsolete、SIGRegがteacherを普遍的に置換、from-scratchが本質的に優れる、connectivityがphysicsを証明する、とは言えません。
3問クイックチェック
- 「target」が「teacher」を意味しないのはなぜですか。
- prediction pressureが届くlearned pathと、SIGRegが直接届くpathはどこですか。
- logging、frozen goal、loss前future targetのうち、どのdetachがv3を変えますか。