课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
全局图景
- 明确标识版本、数据、种子与回合。
- 量化预算为训练和规划分别设定预算。
- 完整交付日志、失败记录、命令和检查点一并交付。
一个小故事:只有一个数字的手提箱
一名研究人员带着一张写有 82% 成功率的卡片抵达边境。官员问:哪一版代码?哪些字节?哪些种子?多少规划器预算?哪些回合?失败的运行记录在哪里?这张卡片无法回答。
这个数字或许真实可信,但它并不是一份完整的实验凭据。请在运行前、运行期间以及发布前使用下面的十个分区。标明“未经验证”的空白项,胜过凭记忆作出的猜测。
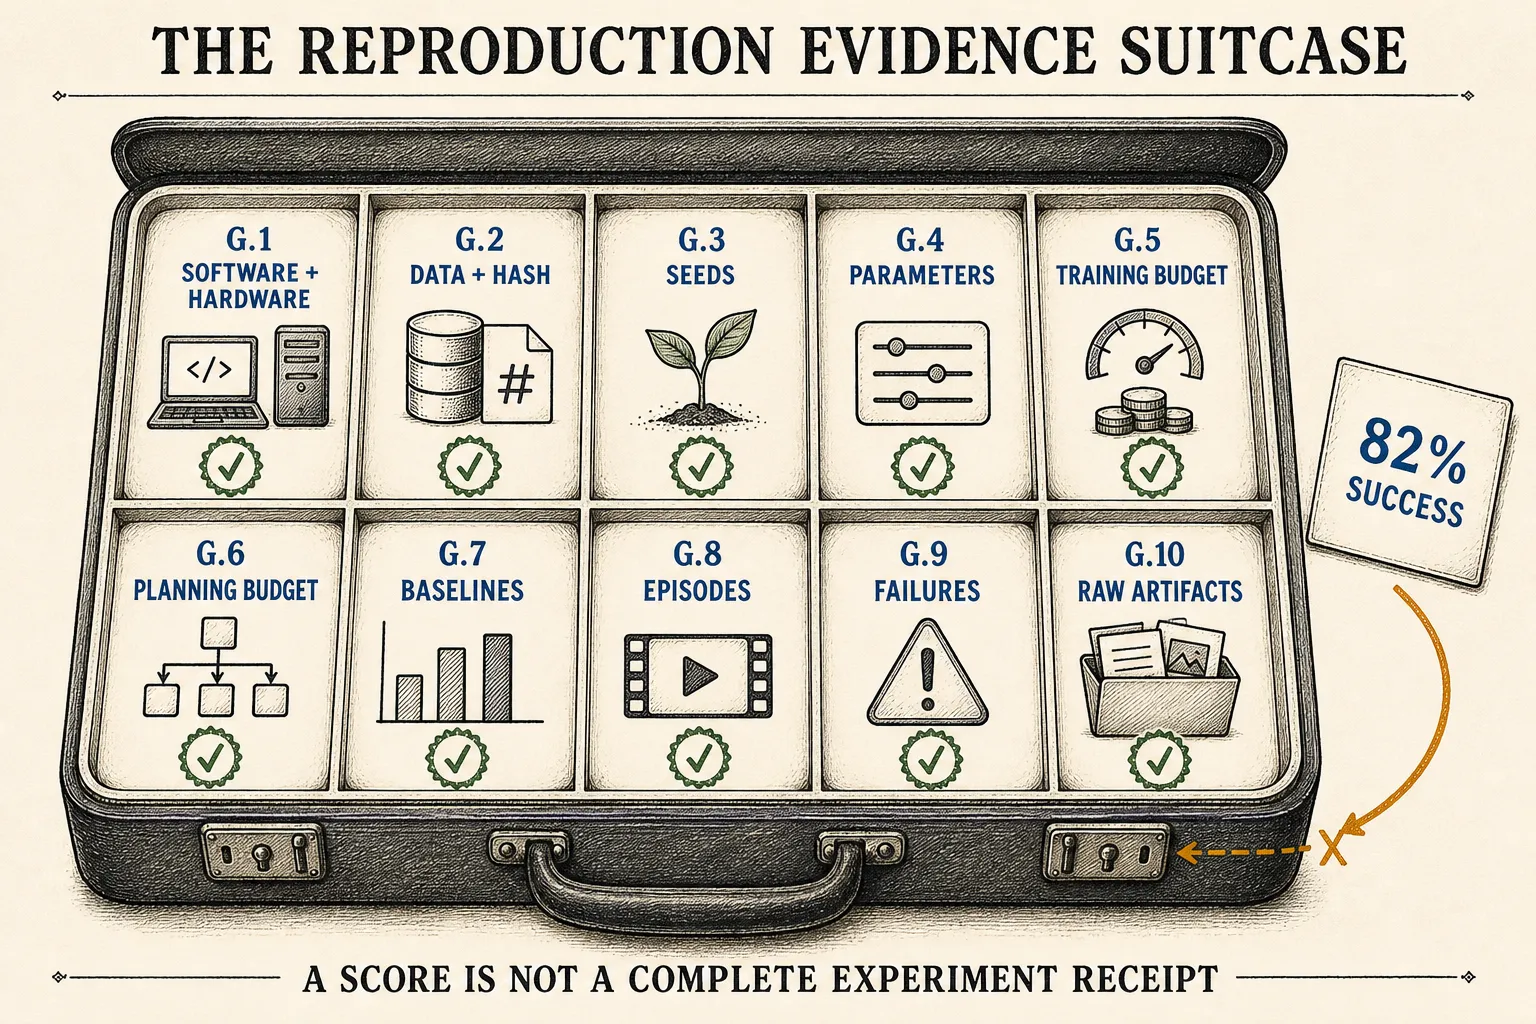
完整性有助于核查,但并不保证在不同硬件和非确定性内核上实现逐比特一致。
可复制的十分区运行凭据
G.1 软件与硬件
- 论文/版本、代码仓库 URL、精确 SHA、本地差异、启动命令,以及会改变行为的环境变量。
- 操作系统、Python、框架、CUDA/cuDNN、GPU 型号/数量/显存、精度、编译/融合内核,以及确定性设置。
- 锁文件或导出的完整解析环境,包括第一方依赖项。仅凭 LeWM 核心
8edfeb3并不能冻结不断变化的stable-pretraining或stable-worldmodel。 - 协议历史。当前 v3 TwoRoom 规定目标偏移量/预算为
25/50;独立审计中论文侧的100/150属于较早的 v1/v2 历史。
G.2 数据身份与哈希
- 产物 URI/修订版本、下载文件名、密码学哈希、许可证/访问规则、解压缩/转换过程,以及加载器实际读取的精确字节。
- 格式、字段、裁剪/缩放、归一化、拟合预处理所用的数据划分、跳帧/动作分组、历史信息、窗口长度/步幅,以及无效窗口规则。
- 在窗口化之前确定回合 ID,以及回合互不重叠的训练集/验证集/测试集划分;将每个采样窗口追溯到唯一回合。
- 明确解决格式差异:冻结版 PushT YAML 标注的是 Lance,而经检查的公开产物/README 路径采用压缩 HDF5/面向 HDF5 的格式。
对于经审计的 TwoRoom 重新实现,请记录每个跳帧块内的稠密动作、以程序方式确定的动作编码器宽度、ImageNet 像素归一化,以及动作 z 分数标准化。这些是 TwoRoom 审计事实,并非 LeWM 的通用要求。
G.3 种子与随机策略
- 列出用于数据划分/窗口采样、初始化、数据增强、dropout、加载器工作进程、环境重置、采集策略、CEM 采样和目标选择的种子,或列出由主种子精确派生这些种子的方法。
- 说明仍然存在的非确定性,以及失败/排除运行的处理规则。保留各个种子的身份信息,而不只是注明“五个种子”。
- 当比较需要配对噪声时,在不同变体之间配对评估种子和规划器种子。
G.4 参数与训练图
- 分别统计视觉骨干网络、投影器、动作编码器、预测器和可选头部的总参数量与可训练参数量;标明冻结部分和预训练部分。
- 确认基线 v3 的身份:可训练视觉编码器、已连接的移位目标、无 EMA 教师、无预训练视觉编码器。
- 记录每项损失会作用于哪些参数。参数总量相近并不意味着架构或先验计算量相同。
G.5 训练预算
- 优化器更新次数、批大小/上下文大小、数据窗口数/暴露次数、训练轮数、优化器/调度方案、验证频率、提前停止、精度、实际运行时间/设备小时数,以及检查点选择规则。
- 预训练数据/计算量,或
unreported——绝不能在未说明的情况下记为零。 - 解决论文与代码之间的差异:具名的 LeWM 实验报告训练 10 轮;冻结的全局最大值为 100。归档实际运行时组合配置得到的值。
G.6 规划预算
- 候选样本数量、精英样本、优化轮数、提议初始化、动作边界、模型时域、每个模型步对应的环境动作数、执行前缀、重新规划间隔、动作总额度、向量化,以及每次决策的延迟。
- 将此计量与训练分开。同等参数量不等于同等搜索量;同等墙钟时间不等于同等动作采样数。
- 换算时钟单位。在引用的冻结卡片中,5 个环境动作构成一个模型步;时域和执行前缀均为 5 个模型步,因此会在重新规划前执行完整的五块序列。
G.7 基线与预言机条件
- 对每个基线记录:实现/SHA、检查点、数据/预处理、预训练、容量、训练/规划预算、调优空间,以及相同的回合账本。
- 按角色标明随机策略、行为克隆、预言机动力学和预言机代价。预言机用于定位性能提升空间;它们既不是可部署的方法,也不能证明可获得一个通过学习得到的替代方案。
- 说明某个调度方案/超参数是在评估前选定,还是事后选定。仅重新调优偏好的方法并非匹配比较。
G.8 评估回合
- 环境/任务修订版本、回合/起点/目标 ID、目标规则、数量、动作预算、成功定义、终止/超时/重置规则、规划器种子,以及失败处理方式。
- 在适当情况下复用配对的起点/目标/随机性。报告每个种子/每个回合的结果、不确定性、超时情况和目标类型分层结果,而非仅报告均值。
- 在查看主要结果之前冻结回合账本。
G.9 失败、零结果与负面结果
- 使用事先声明的选择规则保存原始成功与失败样本:固定套件中的所有失败、每个种子的首次失败、均匀抽样,或预注册的分层。
- 对最早可观察到的断裂点进行分类:数据支持不足、坍缩/变量缺失、动作不敏感、单步失配、自馈送漂移、代价排序错误、CEM 搜索遗漏、执行/接口错误,或超时。
- 保存对齐的帧、观测、动作、预测诊断量、候选代价、所选序列、执行前缀,以及终止原因。
- 归档零结果与负面消融结果。“此处无增益”是在该设置下的证据,而非不可能性的证明。
G.10 原始档案与命令记录
- 源代码/差异、依赖锁定文件、命令、环境变量、组合后的配置、数据清单/哈希值、标准输出/标准错误、结构化指标/事件、检查点,以及在恢复运行至关重要时的优化器/调度器/缩放器/随机数生成器状态、回合账本、原始预测/动作和分析/绘图脚本修订版本。
- README 应包含目录映射、缺失项清单、访问限制,以及
not collected、lost、private、too large和available on request的含义。 - 将原始证据(帧/动作/ID/代价)、派生证据(表格/统计量)和展示材料(裁剪后的图像/视频)分开,并在三者之间保留可追溯路径。
- 对干净交接进行冒烟测试:加载一个检查点,将一个窗口追溯至其回合,重新生成一份摘要,并分别测试训练恢复与推理。
尝试击穿复现凭据
两个实验室使用相同的提交、种子、GPU 和检查点。它们的损失完全一致。随后,双方都发现采样器确定性地将一个回合的最后一帧与下一个回合的第一个动作配了对。
复现性重复了该流程,却没有使该流程变得正确。应为回合边界、目标偏移、因果可见性、动作敏感性、梯度接收方,以及训练目标与规划目标之间的分离添加机械化测试。反之,两次正确的随机运行可能在数值上不同,却支持相同的分布性结论。
现在设想两个 80% 的分数。其中一个使用了预训练视觉模型、300 个候选样本、30 轮优化、5 个种子,以及同轨迹目标。另一个进行端到端训练,使用 64 个候选样本、5 轮优化、1 个种子,以及更广泛的目标划分。相同的数值并不代表相同的实验。在比较之前锁定复现凭据。
证据凭据
方法身份源自 LeWorldModel v3、冻结的 LeWM 代码、第一方依赖项/工件,以及 TwoRoom 复现 v1 与对应的 tinylab efa9e5d。LeWM v3 于 2026-06-03 修订;核心提交的日期为 2026-05-22;复现 v1 发布于 2026-08-10;检查清单的截止日期为 2026-08-20。独立复现仍仅限于 TwoRoom。完整的检查清单能够保留身份信息与缺口;它无法保证逐比特一致、修复缺乏支持的数据,也无法在事后使不可比的运行变得公平。
三个快速问题
- 为什么训练预算和规划预算必须使用彼此独立的计量表?
- 数据哈希能证明什么,又有哪些问题仍未确定?
- 哪些工件能让陌生人在无须猜测的情况下重新生成一项结果?