课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
全局图景
- 为世界命名任务、数据、修订版
- 为时钟命名时钟步、模型步、视界
- 为预算命名训练、搜索、评估
- 为来源盖章论文 ≠ 代码 ≠ 运行
一个小故事
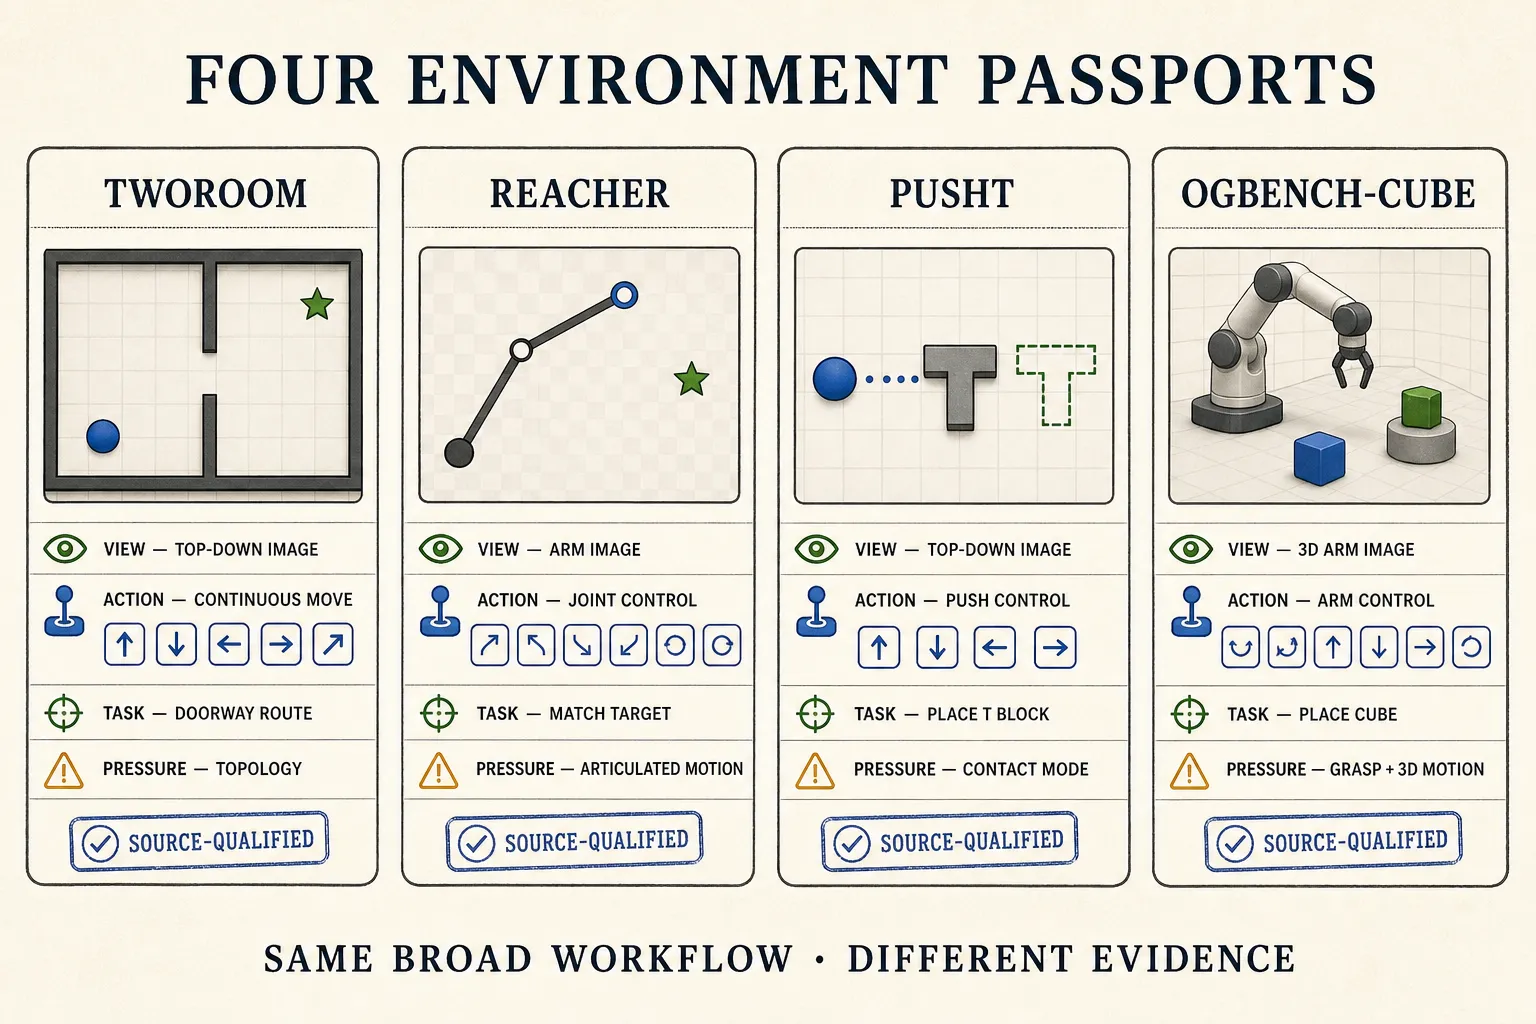
四支团队都说:“我们测试了一个世界模型。”一支穿过门口,一支移动双关节机械臂,一支推动 T 形物体,另一支拿起方块。这句话是真的,却太过简略,无法比较。
配置护照记录世界、制品、观测、动作分组、历史、训练、规划、执行、目标、指标、随机种子和计算资源。无法核实的字段就写未核实。空白会邀请调查;猜出来的数值却是在伪造证据。
配置背包
四本基准护照
| 世界 | 论文卡 | 冻结代码卡 | 压力与边界 |
|---|---|---|---|
| TwoRoom | 10,000 个回合;平均 92 个环境步;带噪声的“先到门口再到目标”启发式策略;10 个 epoch;历史 1;非 PushT 的 CEM 最多 10 次精炼 | tworoom.h5;像素/动作/本体感知;跳帧 5;全局历史 3,最多 100 个 epoch;评估 50 回合,目标偏移 25,动作预算 50,视界 5,执行前缀 5;共享 CEM 30 次精炼 | 门口拓扑会暴露潜在空间中的直线捷径。简单的二维沙盒并不能代表所有世界建模问题。 |
| Reacher | 10,000 个回合 × 200 步;用 Soft Actor-Critic 采集;10 个 epoch;论文历史在所引用陈述中未得到明确核实 | reacher.h5;像素/动作/观测;跳帧 5;全局历史 3;swm/ReacherDMControl-v0、qpos_match;评估 50,偏移 25,预算 50,视界/前缀 5/5 | 这是仿真的关节控制,不是一般机器人证据。成功容差和完整环境行为都需要绑定到解析后的平台修订版。 |
| PushT | 20,000 个专家回合;平均 196 步;10 个 epoch;历史 3;300 个候选、30 个精英、初始方差 1、视界 5,最多 30 次 CEM 精炼 | 全局历史 3,最多 100 个 epoch,SIGReg 权重 0.09;YAML 中名称为 pusht_expert_train.lance;已检查的公开制品/README 使用压缩 HDF5;评估偏移 25,预算 50,视界/前缀 5/5,跳帧 5 | 接触位置、朝向和“只能推不能拉”的历史都很重要。分数不能迁移到真实机器人。 |
| OGBench-Cube | 10,000 个回合 × 200 步;基准启发式策略;10 个 epoch;历史 3;非 PushT 的 CEM 最多 10 次精炼 | ogbench/cube_single_expert.h5;像素/动作/观测;跳帧 5;swm/OGBCube-v0,单方块,224 像素渲染;评估 50,偏移 25,预算 50,视界/前缀 5/5;共享 CEM 30 次精炼 | 三维运动和抓取不同于“三维 PushT”。特权字段负责设置环境目标;这并不能证明原始 LeWM 训练接收了特权状态。成功容差仍与修订版绑定。 |
在这些冻结卡中,一个模型步会把五个环境动作组成一组。因此,五步视界覆盖 25 个环境动作。同一组卡还会在重新规划前执行全部五个模型步。这只是一种 MPC 时序选择,不是 LeWM 的普适常数。
TwoRoom 还有一个版本历史陷阱。一次独立复现把论文侧偏移 100、预算 150 与代码仓库中的 25/50 做了审计。100/150 属于 LeWM v1/v2 历史;当前 v3 附录 F.1 写的是 25/50。该复现还只针对它自己的 TwoRoom 重新实现报告了以下做法:收集每个跳帧块里的所有动作,以编程方式推导动作编码器输入宽度,使用 ImageNet 像素归一化,并对动作做 z-score 标准化。不要把这些审计发现提升为通用基准规则。
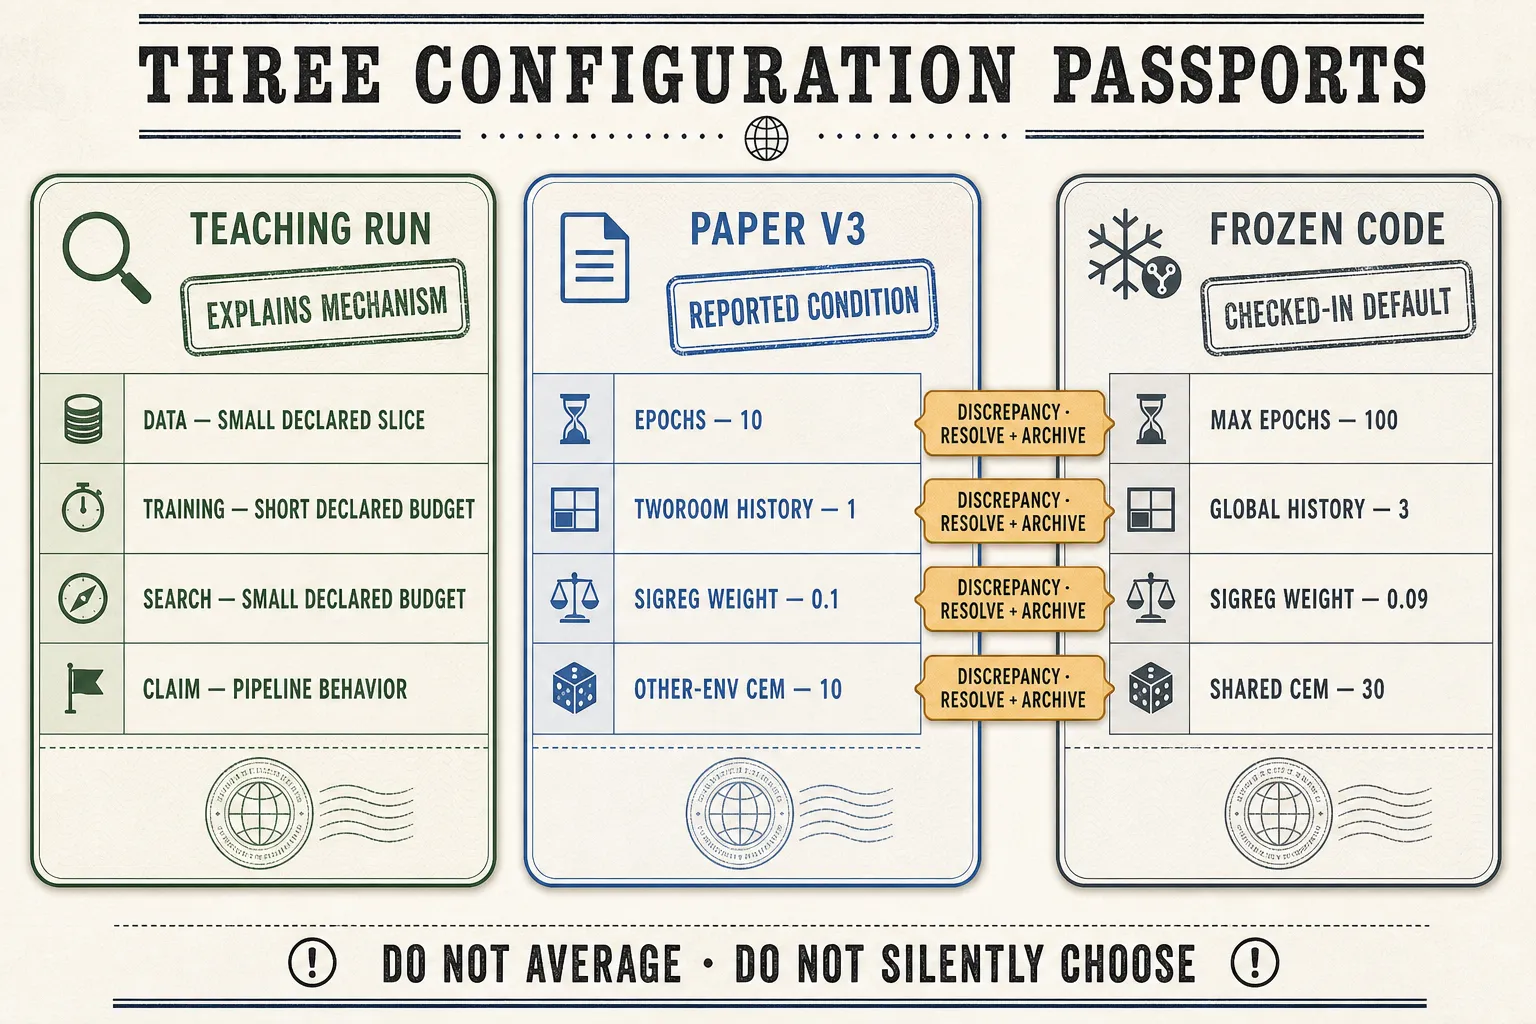
绝不要把论文与代码求平均
| 字段 | 论文 v3 标签 | 冻结代码标签 |
|---|---|---|
| 训练时长 | 四个具名任务均为 10 个 epoch | 全局上限 100 |
| TwoRoom 历史 | 1 | 全局默认 3;数据配置没有覆盖 |
| SIGReg 权衡系数 | 除非另有说明,默认 0.1 | 0.09 |
| 非 PushT 的 CEM 精炼次数 | 最多 10 | 共享求解器为 30 |
| PushT 数据名称/格式 | 沿用 DINO-WM 的轨迹描述 | Lance 文件名;已检查公开制品为压缩 HDF5 |
两列都不“获胜”。论文描述的是所报告条件;冻结代码仓库描述的是该修订版在没有额外覆盖项时解析出的配置。真实运行会再增加第三种标签:解析后的运行,其中每个继承值都被打印并归档。原始 LeWM v3 的方法卡还写明:一个共享且可训练的编码器、连接的目标、没有停止梯度、EMA 教师或预训练;任何改变都必须写进运行护照。
三种有用的运行卡
一次教学运行,是便宜、透明的机制检查。使用回合不重叠的数据切片,并确保其中仍有穿门或多样的接触;必要时缩小容量或预算;保留动作互换、潜在离散度、单步、自馈滚动、CEM 轨迹和执行诊断。把每个改动字段标为 TEACHING,绝不要标成 PAPER。
choose one teaching purpose
freeze data slice, episode IDs, revisions, and seed
resolve every inherited value
run data -> forward -> rollout -> search -> execution gates
archive the resolved card with logs and outputs一次论文复现会锁定所引用的任务、数据、历史、训练、模型、规划器、基线、随机种子和评估,然后记录每一项差异。必须区分三个层级:(1) 加载固定制品并得到有限输出;(2) 在锁定回合与规划器预算上评估它;(3) 用声明的多个随机种子重新训练,并比较指定统计量。通过第一层不代表通过第三层。Hydra 可以组合今天的配置,却无法找回未归档的历史覆盖项、依赖、GPU 软件栈或转换过程。
一次单 GPU 适配首先记录 GPU/显存、软件、精度、墙钟时间、存储和延迟。分别记录训练预算、模型评估预算与规划预算。更小批次会改变 SIGReg 的批次统计;更少投影会改变它的近似;更短历史会改变信息;更少 CEM 候选/精炼会改变搜索;更短视界会改变控制问题。这些节省并不等价,而且修改后的运行卡不能继承论文分数。
骗过我们的把戏
运行 A 使用预训练编码器、300 个候选、30 次精炼、五个随机种子和同轨迹目标。运行 B 端到端训练,使用 64 个候选、5 次精炼、一个随机种子和更宽划分中的目标。两者都报告 80%。这些是刻意构造的假想运行卡,不是对原始 LeWM v3 的描述。
锁定制品、回合 ID、预处理、目标规则、成功定义、时间抽象、模型、训练计算、动作/搜索预算、随机种子和统计量;只改变一个具名因素。即便分数相同,也不能证明机制相同——还要检查滚动、代价排序和失败分布。
证据凭据
LeWorldModel v3,尤其是附录 D–F,以及冻结的官方代码 8edfeb336732b5f3ce7b8b210d0ba370a09e2cac,支持论文/代码卡。TwoRoom 独立复现 v1 及其 tinylab 制品只支持它们自己声明的 TwoRoom 审计。证据截止时间:2026-08-20,Asia/Tokyo。
允许的说法是:四项任务共享一条宽泛流程,但承受不同压力,具有不同来源,并使用经来源限定的设置;有文档记录的论文/代码差异确实存在。本节没有建立完整套件的独立复现、通用超参数或分数迁移。
快速检查
- 为什么论文、冻结代码与解析后的运行历史必须放在不同方框里?
- 在所引用的冻结时序中,五个环境时钟步、视界五和执行前缀五是什么关系?
- 在两个相同成功率能够比较之前,必须锁定哪些条件?