课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 许多像素纹理、光照、噪声
- 一个微小线索门开着还是关着?
- 形成编码保留有用差异
- 测试它紧凑不代表正确
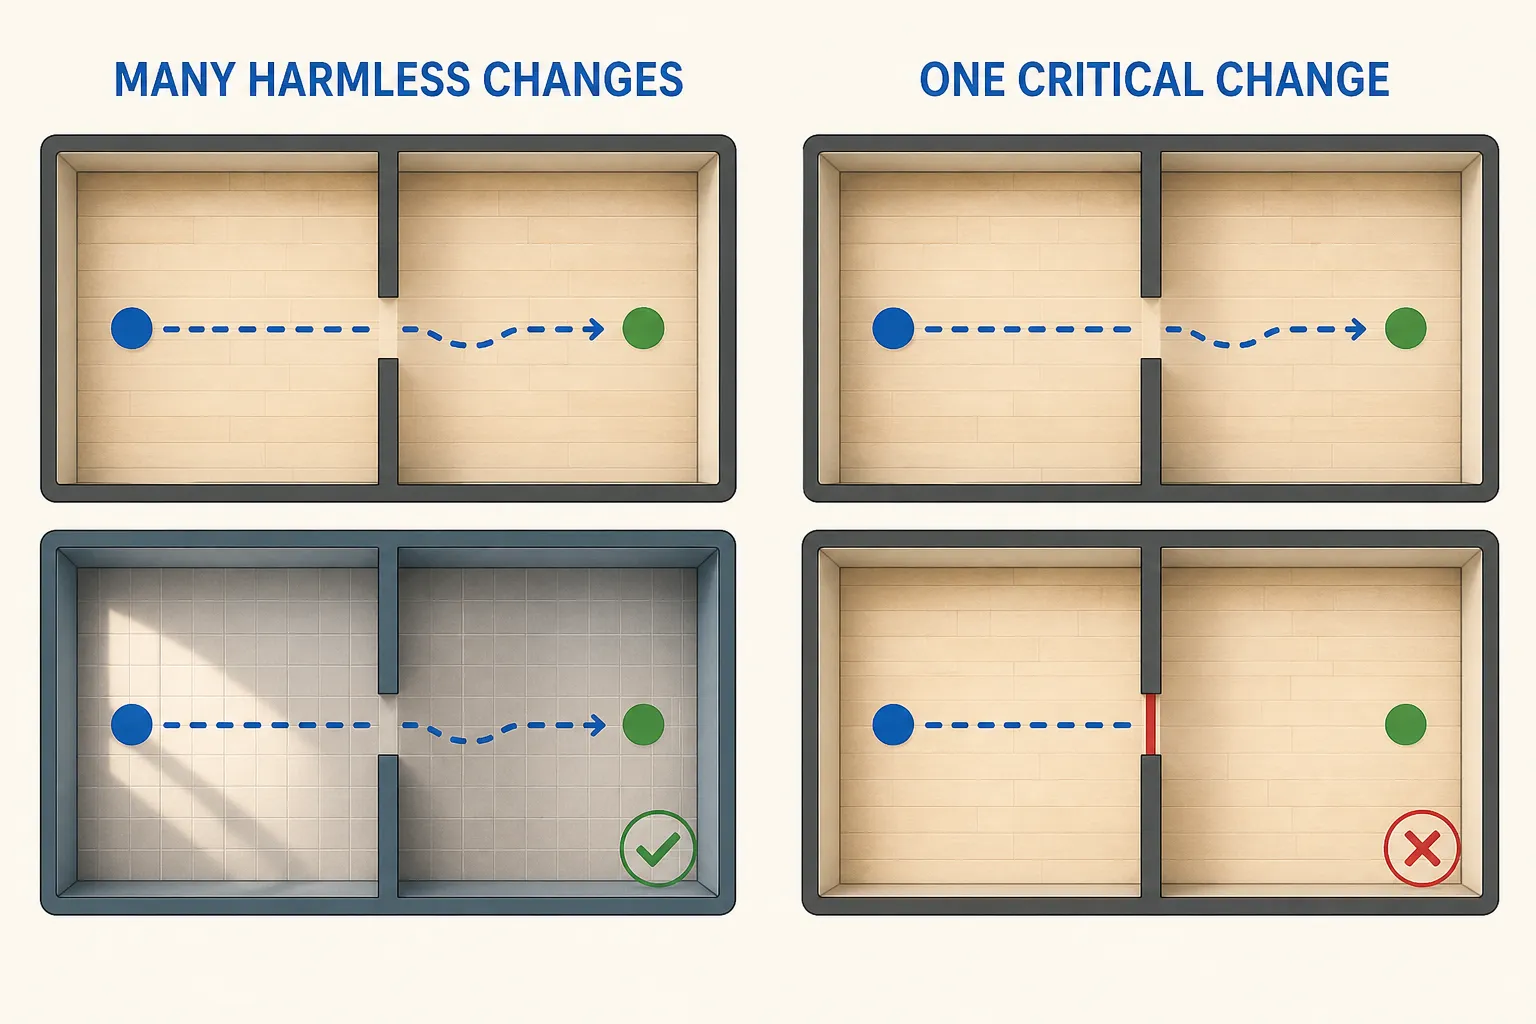
一个小故事
预测 A 弄错了地板纹理和阴影,但智能体、墙壁和门口都在正确位置。预测 B 看起来几乎完美,唯一问题是一条很细的区域把门口封住了。像素分数也许会更喜欢 B,但控制器不应该这样选。
像素并非毫无用处。一个小红灯、一根电缆、一块湿地或一道接触边缘,都可能极其重要。这里的结论更窄:我们在哪里测量误差,决定了训练会迫使模型保留哪些差异。
真正规则
LeWM 的核心目标不是生成下一张图像。它对记录中的下一观测进行编码,根据更早的编码和动作预测该观测的编码,再比较这两个编码。
observations: [B,T,C,H,W] -> codes: [B,T,D]
used actions: [B,T-1,A]
prediction and target: [B,T-1,D] <-> [B,T-1,D]
这为**选择性抽象(selective abstraction)**留出了空间。如果不同光照不改变动作后果,它们可以共享一个有用编码。但“潜在”二字并不提供任何保证。学习到的编码可能保留墙纸,却丢掉门口。核心滚动展开是一串向量,而不是隐藏的视频;若要渲染图像,需要另配诊断用解码器。
对控制有用的表征,应该保留情境差异、动作效果、时间线索,以及能供规划器使用的比较关系。在离线数据的状态—动作支持范围之外,还必须谨慎对待这种表征。这些都是需要检验的期望性质,不是压缩天然承诺的属性。
冻结的基准路径使用一个共享且可训练的编码器。编码后的下一观测与它保持连接——没有 EMA 教师,也没有 stop-gradient。后面介绍的 SIGReg 会抵抗最简单的常量编码捷径,但 SIGReg 并不会为物理规律或可达性贴标签。
容易骗过我们的把戏
想象一个“压缩旋钮”。一端是包含一切干扰因素的完整图像,另一端则把所有图像变成同一个常量向量。常量非常小,也完全可以预测:预测器每次返回它即可。但它同样毫无用处。
一种好的诊断方式,是每次只改变一个因素。先固定几何结构,只改变纹理和光照;然后保持外观相似,只开关门口。理想结果是:编码对明确指定的干扰因素保持不变,却对会改变路线的线索敏感。再把任务反过来——例如让地板纹理指示摩擦力——以证明“干扰因素”取决于任务,并不是像素固有的属性。
一张漂亮的聚类图远远不够。还要同时查看留出数据上的预测、动作交换测试和规划结果。
证据凭据
LeWorldModel v3 和冻结的 train.py 支持紧凑的下一嵌入预测、保持连接的目标、SIGReg,以及位于核心目标之外的辅助解码器。
I-JEPA v3 中一项范围有限的比较报告称:在 ImageNet-1K 上使用 ViT-L/16,并以 1% 标签进行线性评估时,采用表征目标得到 66.9 的 top-1,采用像素目标得到 40.7。两者预训练日程并不相同——分别为 500 和 800 个 epoch。这是一个有明确名称的静态图像结果,不能证明在控制任务中,潜在预测总是优于像素预测。
允许的表述是:潜在预测允许选择性抽象,但不保证它一定发生。不要声称像素预测天生更差、编码越小越好,或潜在误差就等于任务误差。
快速检查
- 为什么许多错误像素可能不如一条错误的门边重要?
- 为什么常量编码很容易预测,却无法用于控制?
- 哪一组受控样本可以检验编码是否保留了门口几何结构?