课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 数据回合和动作真实吗?
- 状态有用差异保留下来了吗?
- 未来固定动作滚动展开会留在正轨吗?
- 规划代价、搜索和执行能利用它吗?
一个小故事
测试烟雾报警器时,使用一小股烟雾即可,不必点燃整座房子。TwoRoom 就是这股小烟。
它包含两个连续空间房间、一堵隔墙、一个门口、一个移动智能体,以及墙另一侧的目标。论文报告了 10,000 个回合,平均每个回合 92 个环境步。带噪声的启发式策略先朝门口移动,再朝目标移动。因此数据形成的是一条支持范围走廊,并不是对每个位置和动作的均匀调查。
通过这项测试,说明组装后的“数据到规划”路径能在一个透明环境下工作;却不能证明接触物理、真实机器人安全性、广泛泛化能力或论文的精确复现。
真正规则
调参之前,先冻结产物和回合划分。验证时间顺序、动作/图像对齐、穿门过程、支持范围、frame skip,并确保没有窗口跨越回合边界。
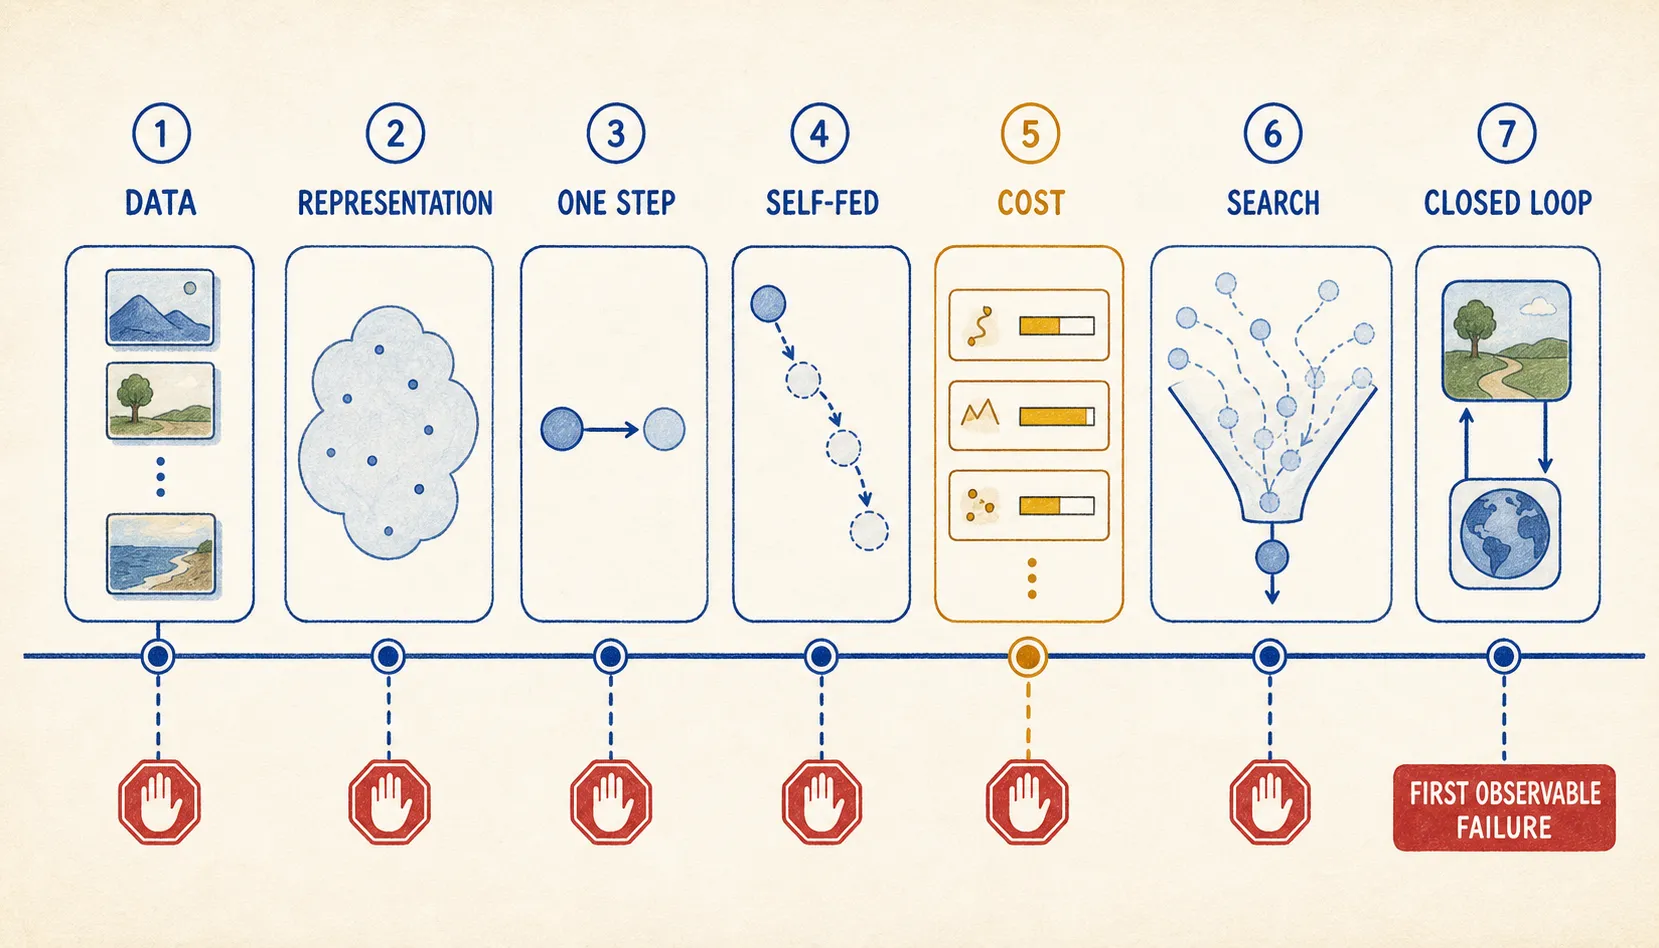
然后按顺序通过七道关卡:
- 数据: 有效回合、动作、取值范围和支持范围。
- 表征: 分布宽度、协方差谱、重复项、最近邻和动作敏感性。
- 单步: 留出数据中的记录转移,以及动作交换。
- 自反馈: 固定记录动作,并按时域检查滚动误差。
- 代价: 候选终点能够区分,墙壁拓扑不会被错误排序。
- 搜索: CEM 提议和精英确实发生变化。
- 闭环: 反归一化动作能够到达环境;新观测会触发重规划。
在第一个失败关卡停下,并保留检查点和回合。“第一个可观察到的断点”比“唯一真正原因”更稳妥,因为更深层的故障可能同时存在。
论文卡片写着训练 10 个 epoch、TwoRoom history 为 1,以及非 PushT CEM 优化 10 轮。冻结代码卡片则写着最多 100 个 epoch、全局 history 为 3 且 TwoRoom 没有覆盖,以及共享 CEM 优化 30 轮。接受检查的官方检查点也记录 history 为 3。可以进行小规模运行,但必须标为 TEACHING SMOKE TEST,并披露参数、更新次数或 epoch、batch/history、精度、设备、耗时和数据暴露量。
可能骗过我们的把戏
假设平均单步误差很低,只是因为大多数转移都发生在开阔地面。把起点和目标放在墙壁两侧,彼此靠近。终端潜在距离也许会偏爱一条被环境阻挡的直线路径。
进行下列受控替换:
- 预言机最短路径代价 + 学习动力学;
- 预言机动力学 + 学习代价;
- 强制经过门口的航点;
- 在不引入新搜索随机性的情况下,重放选定动作。
一次撞墙本身无法诊断动力学。若预言机代价能够修复,问题更可能在几何或排序;若预言机动力学能够修复,问题更可能在滚动展开;航点只说明人为提供的拓扑会有帮助。动作缩放、稀疏门口数据和有限搜索仍然可能是原因。
对 SIGReg 也要保持同样谨慎。LeWM v3 报告 TwoRoom 规划弱于命名的基线,并提出一种可能解释:低多样性、低内在维度数据与高维等方高斯目标之间存在张力。这是与结果相符的假设,而不是独立验证的因果发现。
实验凭据
接受检查的官方数据版本为 6903a2d。冻结评估卡片使用 50 个回合、同一轨迹上向前 25 个环境步的目标、50 步动作预算、每个时域和执行间隔各五个模型动作块,以及每个块中的五个原始动作。共享求解器卡片使用 300 个候选、30 个精英、初始方差 1 和 30 轮优化。当 (H=K=5) 时,要等完整的 25 步计划片段执行完才获得反馈。
独立的 TwoRoom 复现 报告,在相同回合上,其检查点成功率为 94%,发布检查点为 84%,每项配置只有一个训练随机种子。它还报告,在三个检查点之间,单步误差无法排序长时域成功率。其对 100/150 的讨论指旧版 LeWM v1/v2;v3 现在采用仓库的 25/50 目标/预算卡片。
请记录数据版本、划分、检查点、论文/代码/运行卡片、七关轨迹、所有随机种子和确切动作单位。全局潜在点云健康,或有一条路线成功,仍不能证明所有区域都有有用拓扑。
快速检查
- 为什么穿门启发式会限制数据的支持范围?
- 为什么固定动作滚动展开必须先于规划器选择动作的滚动展开?
- 撞墙能够诊断什么,又不能诊断什么?