课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
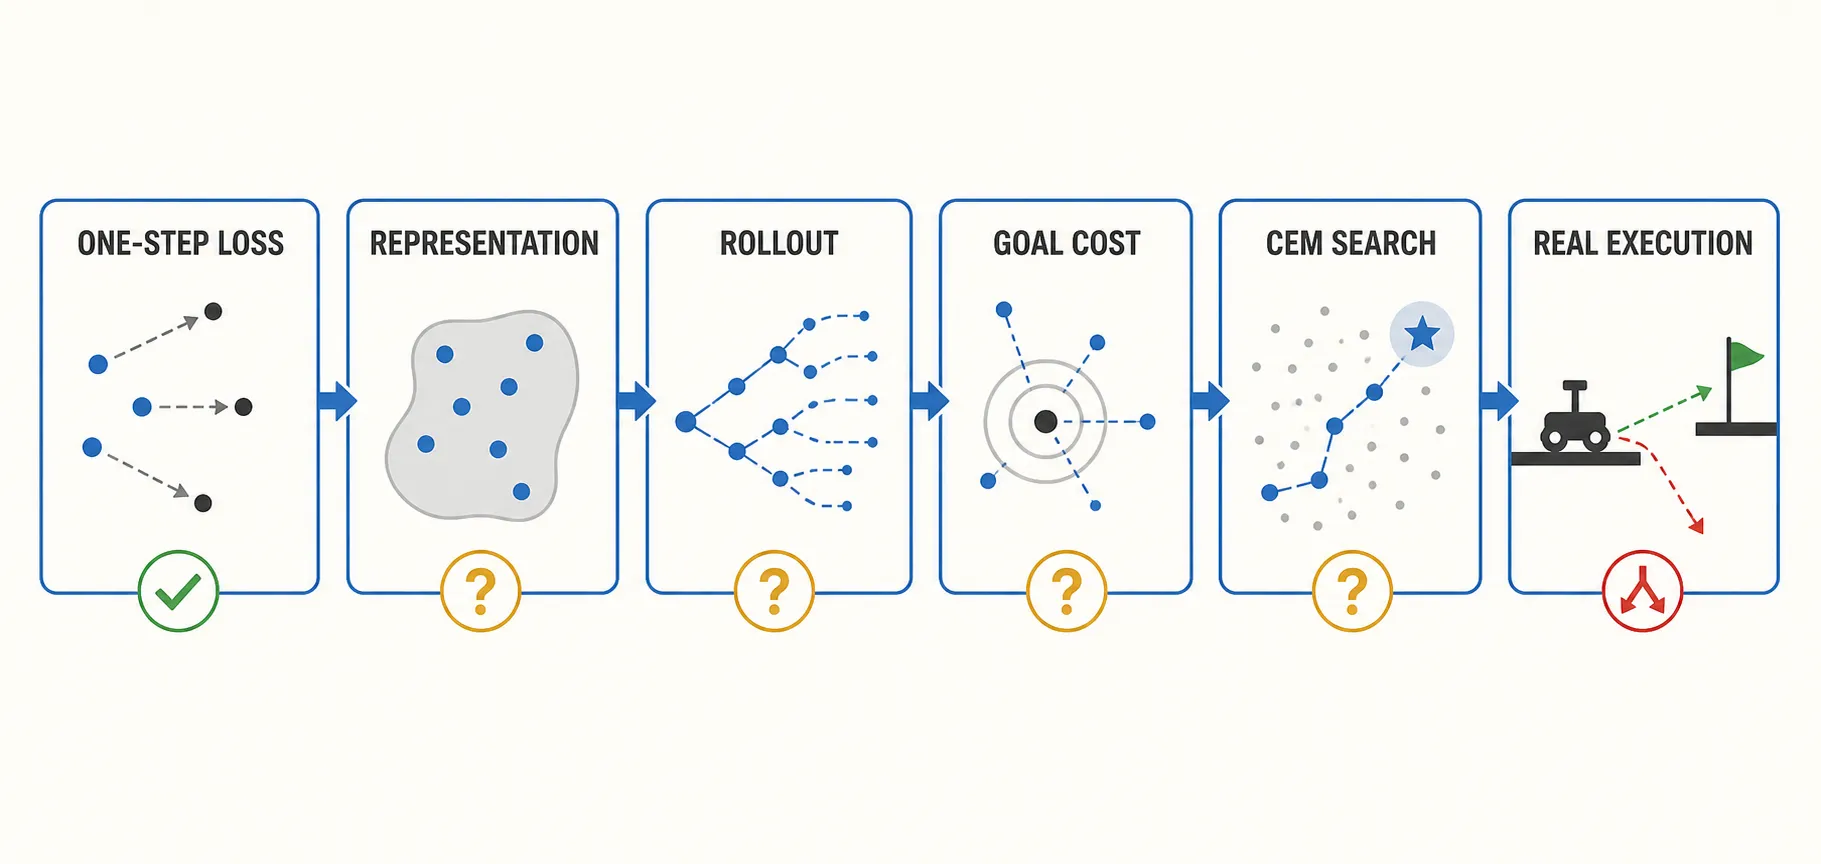
- 猜测下一潜在状态
- 编码现实中真正发生的下一步
- 测量坐标差的平方
- 牢记只是一把局部直尺
一个小故事
驾驶学员可以准确完成许多单独转弯,却仍然选择一条横跨城市的错误路线。LeWM 的预测损失就像测量一次局部转弯的直尺。它会问:下一潜在状态的猜测,是否接近共享编码器对记录中下一观测给出的表征?
这把直尺不可或缺。没有它,预测器就没有直接理由遵循记录下来的转移。但它的坐标是学习得到的,并不是米、角度或速度。
技术背包
冻结实现采用均方误差:
observed_states = encode(recorded_frames)
guesses = predict(observed_states_without_last, recorded_actions_without_last)
targets = observed_states_without_first       # still connected
L_pred = mean((guesses - targets)^2)
平方可以防止正负差距相互抵消;取平均则合并 batch、时间位置和潜在坐标。如果一个重要物理变量根本不在表征中,MSE 就没有能够对它提出异议的坐标。
目标是学习得到的。它不是预言机状态、EMA 教师,也不是停止梯度的固定答案。预测梯度会通过上下文侧和目标侧的使用路径到达共享编码器。这种灵活性也允许常量编码的崩塌捷径,因此 SIGReg 承担另一项不同的工作。
采用冻结的四观测默认设置时,所有移位样本对都参与计算:
context/actions:  z0+a0   z1+a1   z2+a2
predictions:      p1      p2      p3
targets: z1 z2 z3它们是不同上下文位置上的三个单步目标,并不是从同一个起点直接滚动一、二、三步得到的结果。num_preds=1 设定偏移量。frameskip=5 时,“一个模型步”横跨五个环境动作。论文报告 TwoRoom 的 history 为一,而冻结的全局默认值为三。
使用教师强制时,每一个上下文状态都来自记录观测。规划时,预测状态会被追加,并成为下一次预测的输入。最初的一点小偏移可以改变后续预测。误差可能增大、缩小、旋转、抵消或饱和,并不一定单调上升。
容易骗过我们的把戏
构建一个包含 95 次直行转移和 5 次罕见门口转弯的数据集。预测器可以处理好绝大多数样本,却忽略转弯动作,同时仍报告看起来不错的平均值。
不要抛弃 MSE,而要把它拆开检查:
- 按区域和预测位置报告留出数据上的教师强制单步误差;
- 以自回归方式重放记录动作,并绘制误差随时域的变化;
- 针对相同目标,比较教师强制上下文和自回归上下文;
- 固定历史并交换数据支持范围内的动作;
- 只在明确限制的前提下使用特权状态探针;
- 分别报告代价排序和闭环成功率。
训练 MSE 和终端规划代价都可能包含潜在状态差距的平方,但它们使用不同张量和归约方式。前者是在移位转移上取平均,后者则是每条候选序列的终端求和分数。两者的原始数值不能互换。
证据凭据
LeWorldModel v3、冻结的 train.py 和冻结的 JEPA.rollout,支持教师强制单步训练和自回归规划。
在一次单随机种子的 TwoRoom 复现中,三个检查点的单步准确率能够排序短时域行为,却无法排序长时域规划成功率。这支持在该协议下分别测量后续链路;但它既不能建立普遍定律,也无法指出原因。
允许的表述是:较低的连通单步 MSE 表明,在接受评估的转移上存在局部潜在一致性。不要把它提升为有意义的状态、可达性、稳定滚动展开、有效 CEM 或成功控制的证据。
快速检查
- 为什么编码后的下一观测虽不是固定真值,却仍然有用?
- 教师强制上下文与自回归上下文之间发生了什么变化?
- 哪项指标可以揭示被平均值掩盖的罕见动作相关失败?