课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 论文论文描述了什么实验?
- 核心使用哪个冻结 LeWM 代码?
- 工坊依赖采用哪些版本?
- 凭据实际上运行了什么?
一个小故事
你拿到了一台官方引擎、一套官方工具箱和一把官方钥匙。但钥匙仍可能打不开引擎,因为工具箱在钥匙制成后发生过变化。
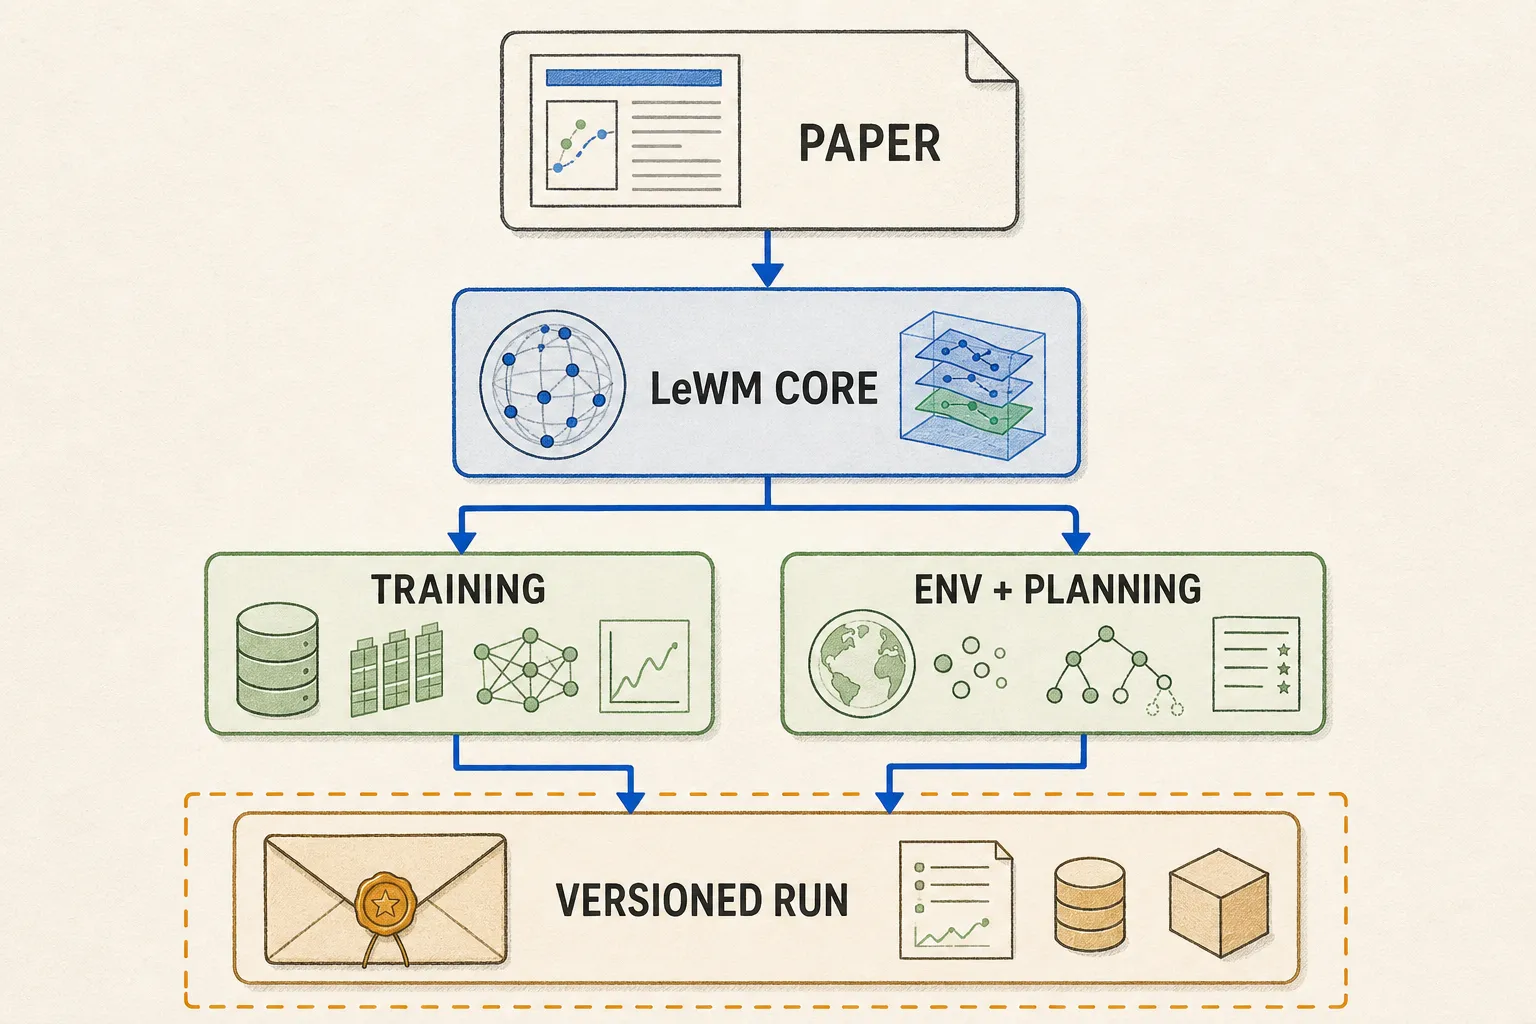
LeWorldModel 同样由多个层次组成。论文是设计说明,小型冻结仓库是核心引擎,stable-pretraining 和 stable-worldmodel 提供训练、环境、规划与评估,数据和检查点则是另外的产物。“官方 + 官方”并不能自动重建作者当时使用的历史工坊。
真正规则
冻结的 LeWM 核心是提交 8edfeb3。jepa.py/module.py 负责模型和 SIGReg;train.py 连接数据与损失;eval.py 则连接冻结模型、CEM 或随机动作、环境和指标。
核心没有依赖锁定文件。本课程检查了 stable-worldmodel@addbab4 和 stable-pretraining@9aa93f8。这些版本使当前行为可以检查,却不是 LeWM 提供的历史版本锁定。
完成下面五项健康检查,就足以称一次运行在机械结构上准备就绪:
- 记录 Python、PyTorch、加速器栈和操作系统;
- 记录所有源代码版本;
- 计算数据和检查点文件的哈希,并记录解压后的名称;
- 验证一个不跨回合的 batch、有限值前向传播和短时环境交互;
- 归档解析后的配置、硬件、日志和输出。
README 指定 Python 3.10。诊断缺失字段前,必须完整组合 Hydra 配置:launcher 片段会提供 wandb 和 cache_dir。解析后的运行记录,而不是散落的 YAML,才是可执行实验记录。
原始 v3 仍由一个共享且完全可训练的视觉编码器、动作条件预测器和 SIGReg 组成。目标保持连接。训练中没有 stop-gradient 目标、EMA 教师、预训练视觉骨干、奖励、目标或 CEM 监督。
可能骗过我们的把戏
论文、代码和运行时数值是三张不同的卡片:
| 设置 | 论文卡片 | 冻结代码卡片 |
|---|---|---|
| 指定任务训练 | 10 个 epoch | 最多 100 |
| TwoRoom history | 1 | 全局默认值 3 |
| SIGReg 权重 | 除非另有说明,否则为 0.1 | 0.09 |
| 非 PushT CEM 优化轮数 | 10 | 共享配置为 30 |
| PushT 训练数据 | 轨迹描述 | YAML 指定 Lance;公开产物是压缩 HDF5 |
不要对这些卡片取平均,也不要悄悄选择方便的数值。
另一个陷阱是检查点身份。接受检查的官方仓库提供 weights.pt 和 config.json,其目标类位于 stable_worldmodel.wm.lewm;冻结核心则构造 jepa.JEPA,并记录了转换方式。应记录类路径、架构、预处理、来源和依赖版本、哈希以及转换过程。
训练脚本会在委托出去的随机划分之前,对完整载入数据集拟合非图像归一化器,因此这条已提交代码路径并不是只用训练集做归一化。回合分组也依赖最终解析出的 stable-pretraining 版本。成功载入模型并不能消除这些科学差异。
实验凭据
这里检查的官方产物版本分别是:TwoRoom 数据 6903a2d、PushT 数据 655cd44、TwoRoom 模型 77adaae 和 PushT 模型 22b330c。数据集凭据必须包含回合/时间字段、预处理、归一化划分、时间窗口、frame skip、加载器、格式转换,以及证明任何窗口都不会跨越回合边界的测试。
论文描述的模型约含 1,500 万参数,在单张 GPU 上训练数小时,并报告在其设置下规划最高加速 48×。冻结训练器以 GPU、自动设备选择和 bfloat16 为目标,但确切的历史 GPU 和计时软件栈并未提供。应把这些说法保留为作者报告且依赖配置的结果。
一项独立的 TwoRoom 研究 及其公开提交 efa9e5d 报告了发布 YAML 之外四项影响重大的约定:每个 frame-skip 块包含五个原始动作、动作编码器宽度为 10、采用 ImageNet 归一化,以及对每个动作坐标执行 z-score。在匹配的 50 回合协议下,它报告自己的检查点成功率为 94%,发布的作者检查点为 84%,位置探针 Pearson 相关系数为 0.9988。它只覆盖一个环境,并且每项配置只有一个训练随机种子——不是四任务表格,也不是精确的历史环境。
快速检查
- “在机械结构上准备就绪”能证明什么,不能证明什么?
- 为什么必须保存解析后的 Hydra 配置?
- 为什么两个官方产物仍可能无法重建论文环境?