课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 动力学仪表下一潜在状态一致吗?
- 群体仪表点云崩塌了吗?
- lambda平衡两股压力
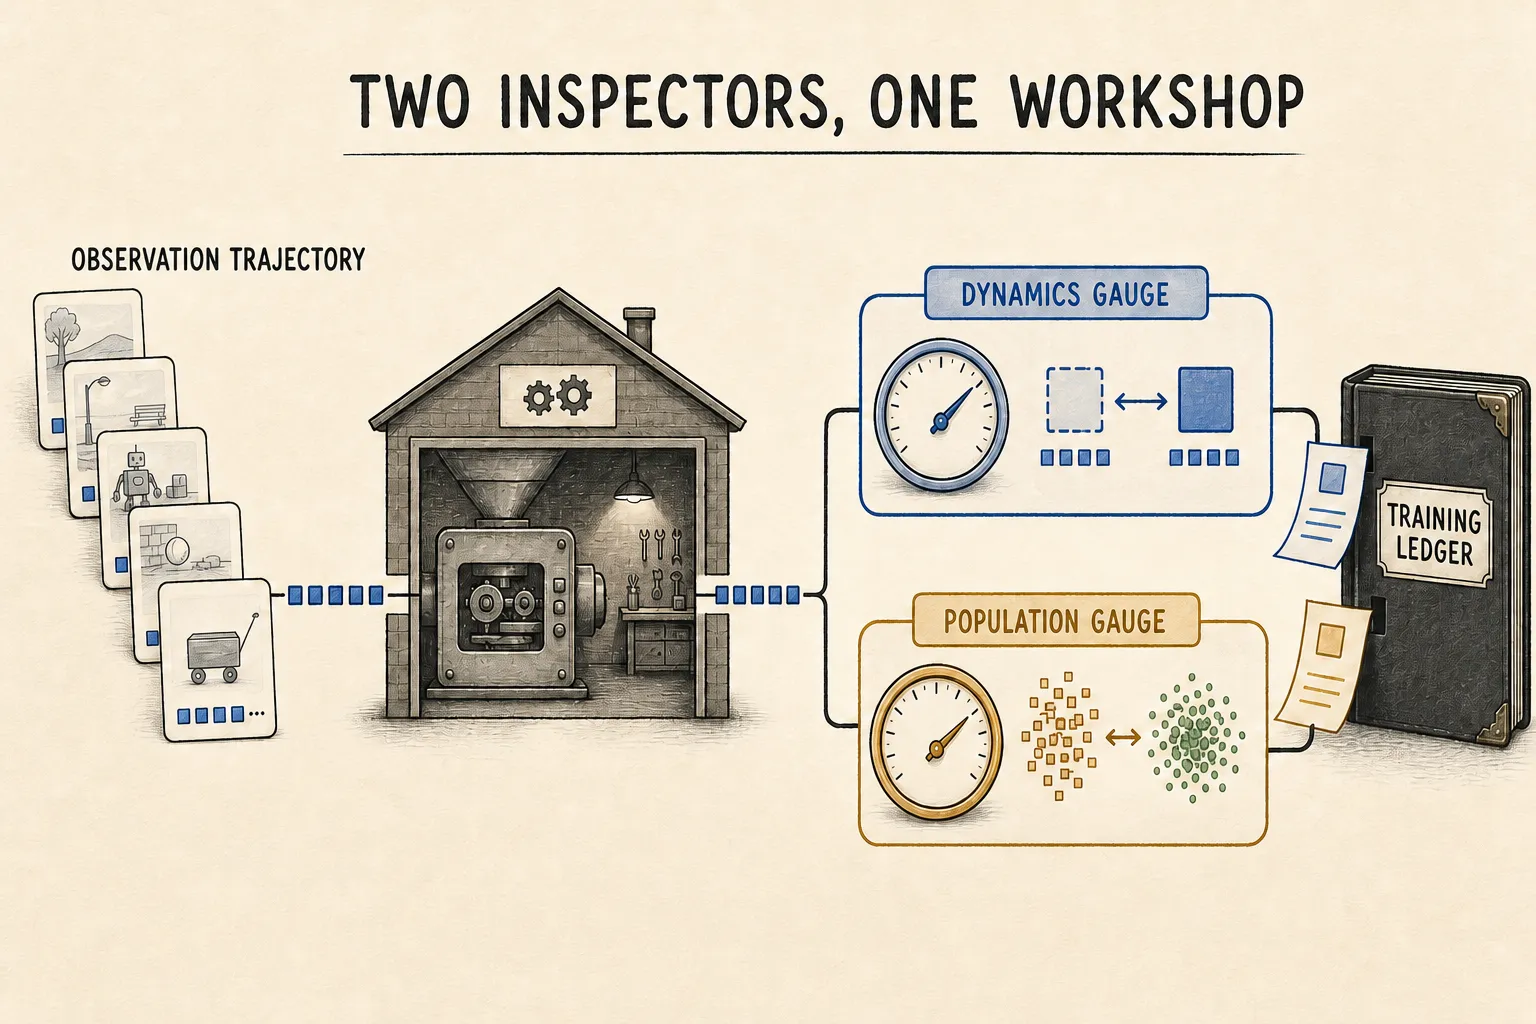
一个小故事
一位工坊检查员负责检查:以动作为条件的猜测,是否匹配现实中下一步的潜在状态。另一位检查员则检查:观测嵌入构成的人群,是否已经收缩成一种简单的退化形状。
只听第一位的话,每个观测都可能变成同一个常量答案。只听第二位的话,点云可以分布得十分漂亮,却忘记哪个动作能到达门口。两位检查员评判的不是同一件事。
技术背包
预测项是针对保持连接的下一观测嵌入计算的逐坐标均方误差:
z = shared_encoder(observation_window)
z_hat = action_conditioned_predictor(z_context, recorded_actions)
L_pred = mean((z_hat - z_next_connected)^2)
因为目标由共享且可训练的编码器产生,并且没有被 detach,L_pred 可以更新预测器、动作路径、上下文表征和目标表征。
SIGReg 作用于每个相对时间位置上的观测嵌入。随机单位方向产生一维投影;有限的余弦/正弦指纹再与解析形式的标准高斯指纹比较。它直接更新视觉编码器和编码器投影器,而不是动作编码器或动力学预测器。
完整目标为:
L_total = L_pred + lambda * L_SIGReglambda 是控制群体分布压力的音量旋钮。它不会改变 SIGReg 测量的内容,不会选择潜在宽度、设定投影数量、调整优化器,也不会控制规划时域。音量太小,会让平凡捷径继续可用;音量太大,则可能偏爱全局高斯形状,而牺牲转移之间的关系。
版本标签也是数学定义的一部分:
| 来源 | 数值 | 稳妥解读 |
|---|---|---|
| LeWM v3 方法 | 0.1 | 论文中声明的默认值 |
| 冻结 YAML | 0.09 | 已提交代码中的可执行设置 |
| PushT 附录 G 扫描 | 在 0.09 附近达峰;测试的 0.01–0.2 范围内 >80%;在 0.5 急跌 | 作者在该设置下报告的结果 |
论文把投影数量和正则化权重称为两个新增设置,并在报告投影消融之后,将 lambda 称作唯一真正有效的待调参数。这并不意味着模型、优化器、数据和规划器总共只有一个超参数。
冻结的 SIGReg 使用 1,024 个投影和从 0 到 3 的 17 个节点。batch 大小控制每个经验投影中的样本数,投影数量则控制有多少个方向检查同一批样本。二者不能相互替代。
容易骗过我们的把戏
训练三组其余条件匹配的模型:不使用 SIGReg;使用明确标注来源的论文或代码权重;使用一个故意大到压倒一切的权重。分别记录原始 L_pred 和 L_SIGReg,而不只是它们的加权和;同时记录方差、有效秩、最近邻、动作交换、单步误差和随时域变化的自回归误差。
预期机制都是有条件的。移除 SIGReg 会让常量一致性与目标函数兼容,但一次运行未必真的崩塌。过强的 SIGReg 可能损害动力学,但不存在由此推出的通用阈值。点云分布广泛、预测却听不见动作,不是全局崩塌,而是动力学较弱。训练仪表良好但规划糟糕,说明问题可能出在后续链路,例如滚动展开、代价或搜索。
证据凭据
LeWorldModel v3、冻结的 train.py、冻结的 SIGReg 和冻结的 lewm.yaml,支持这个双项目标及各来源特有的数值。LeJEPA v3 提供了带明确假设边界的高斯动机,而不是通用物理状态保证。
允许的表述是:理想的高斯匹配会排除完全相同的常量表征,而预测则提供时间和动作关系。较低总损失既不能证明物理规律,也不能证明规划能力。
快速检查
- 每只仪表分别抵抗或约束哪一种捷径?
- 为什么增大
lambda可能改善群体形状,却损害动力学? - 为什么
0.1和0.09都是正确事实,却不能互换?