课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 冻结编码器和动力学此刻不再学习。
- 搜索CEM 提出完整计划。
- 排序把想象终点与目标比较。
- 执行运行 K 个动作块,观察,再重复。
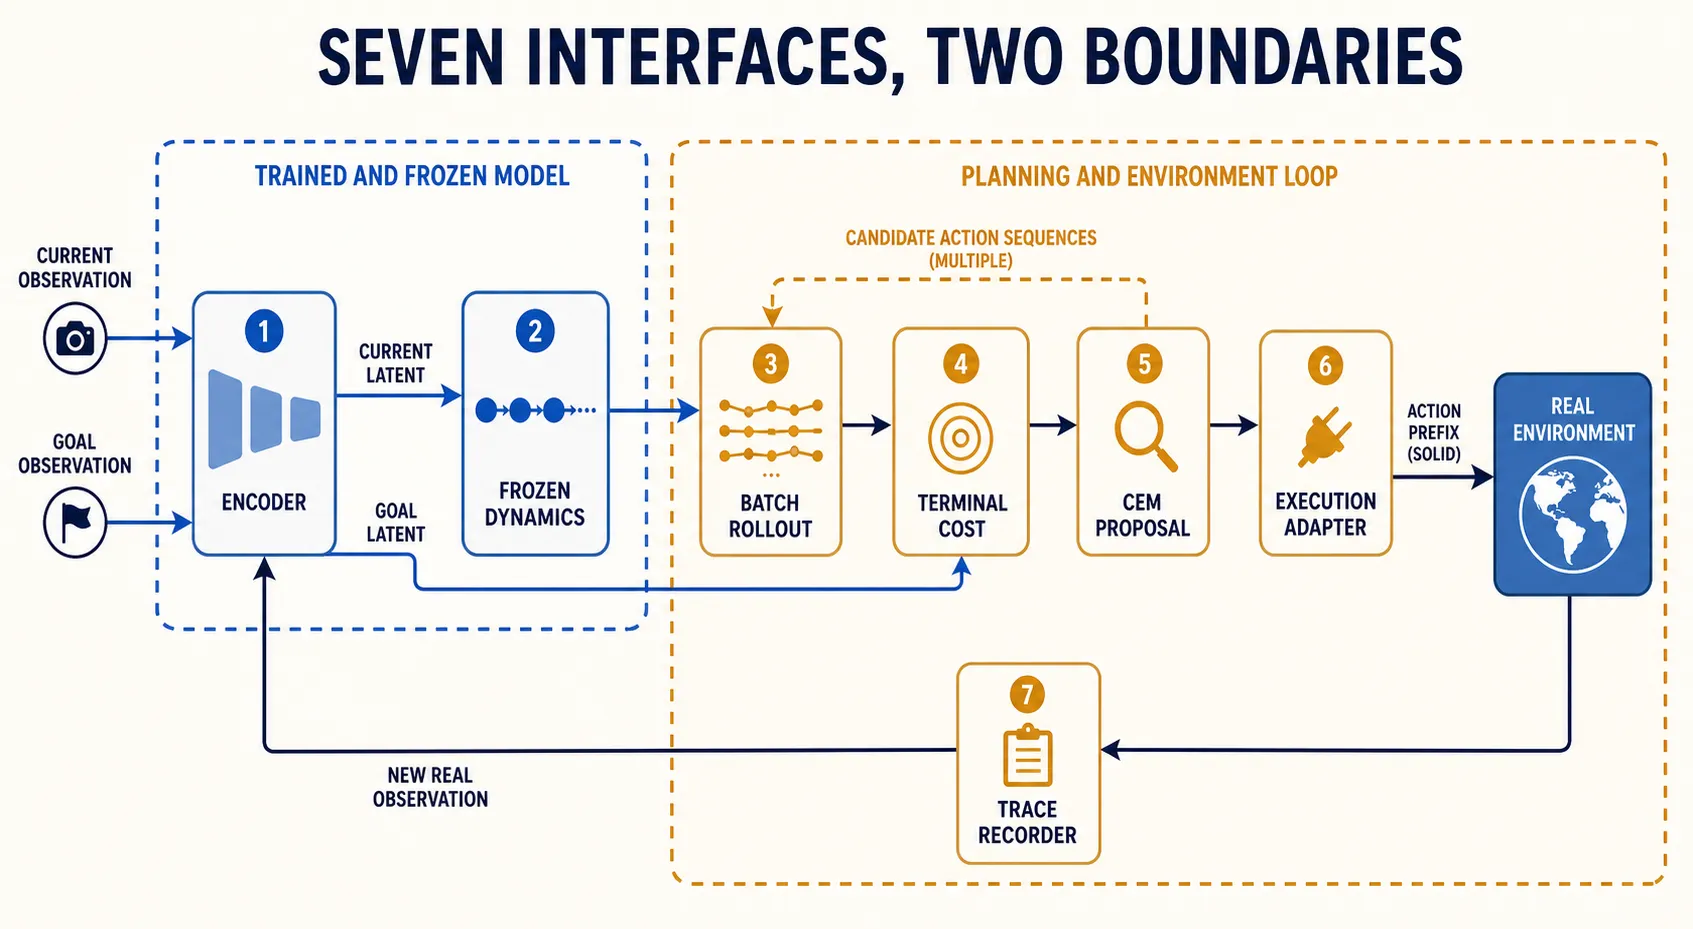
一个小故事
搭建玩具铁路之前,先为每个连接器贴上标签。哪根线传递真实观测?哪根线传递想象潜在状态?哪个动作最终到达电机?
最小 LeWM 规划器也应该这样做。这里的“从头构建”是指围绕一个已经训练并冻结的检查点建立清晰接口。它并不是发明一种新的 LeWM 实现,也不能假装教程伪代码就是作者的确切运行时。
真正规则
请分开保存下列对象:
current images   [B, T_context, C, H_image, W_image]
current latents  [B, T_context, D]
goal latent      [B, D]
candidate actions[B, N, H_plan, A_block]
imagined latents [B, N, T_rollout, D]
candidate costs  [B, N]
execution prefix [B, K, A_block]
单独编码的目标进入终端代价,而不是动力学预测器。正确的向量化实现可以把 (B\times N) 展平以提高吞吐量,但必须保留每个环境、候选和目标的身份对应关系。应把一个小型循环实现与向量化路径比较;置换候选顺序,应只会以相同方式置换对应输出。
基准 LeWM 使用到目标的平方欧氏距离,为指定的最终预测潜在状态打分。模型保持冻结,CEM 则重新拟合动作提议分布。应同时记录采样到的最佳序列和最终提议均值。附录 B 与接受检查的 stable-worldmodel 快照都返回最终均值;改为执行 best_seen 是应明确标注的变体。
报告设置中,(H=5) 个模型动作块、(K=5),每个动作块包含五个环境动作。只有选定的前缀会进入现实;预测潜在状态永远不会作为虚假测量值写进真实观测缓冲区。
可能骗过我们的把戏
选择一个隔墙却很近的 TwoRoom 目标。在候选预算和真实动作预算固定时,用同一个冻结任务运行四种明确命名的设置:
- 学习动力学 + 学习潜在代价;
- 预言机动力学 + 学习代价;
- 学习动力学 + 预言机代价,但前提是想象状态存在有效的评分桥梁;
- 两者都用预言机,且采用相同有限搜索。
再加入等预算随机策略,以及另一项采用支持范围约束提议分布的设置。它们回答的是不同问题:预言机动力学测试替换滚动展开的效果;预言机代价测试替换排序的效果;两者都是预言机,仍不能让 CEM 变成最优;支持约束则会改变搜索位置。
如果预言机动力学修复了回合,说明滚动展开值得怀疑。如果预言机代价修复了回合,说明排序值得怀疑。如果两者都失败,应检查候选覆盖、动作表征、可达性和执行。单张最终图像无法定位原因。
实验凭据
每个 MPC 循环都要保存当前观测与目标身份、预处理、检查点、(H)、(K)、动作块语义、所有随机种子、采样与精英代价、提议分布宽度、支持范围警告、选定的归一化动作、原始环境动作、虚线表示的想象潜在状态、实线表示的返回观测、终止状态和耗时。固定投影可以帮助可视化两条路径,但原生潜在距离仍是实际测量值;模拟器坐标则应放进独立的特权信息面板。
来源边界是 LeWorldModel v3、冻结的 jepa.py 和 eval.py,提交为 8edfeb3。核心没有锁定其历史求解器依赖,尽管两个接受检查的求解器版本都返回最终均值。预言机和失败档案是教程诊断工具,而不是基准功能或可部署的纯像素结果。
快速检查
- 为什么目标潜在状态必须留在基准动力学滚动展开之外?
- 哪项断言可以揭示向量化实现中的身份混淆?
- 预言机动力学和预言机代价分别测试哪些不同瓶颈?