课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 从真实开始编码一段真实历史。
- 预测形成下一潜在状态。
- 反馈给自身估计结果变成上下文。
- 测量跟踪每个时域上的漂移。
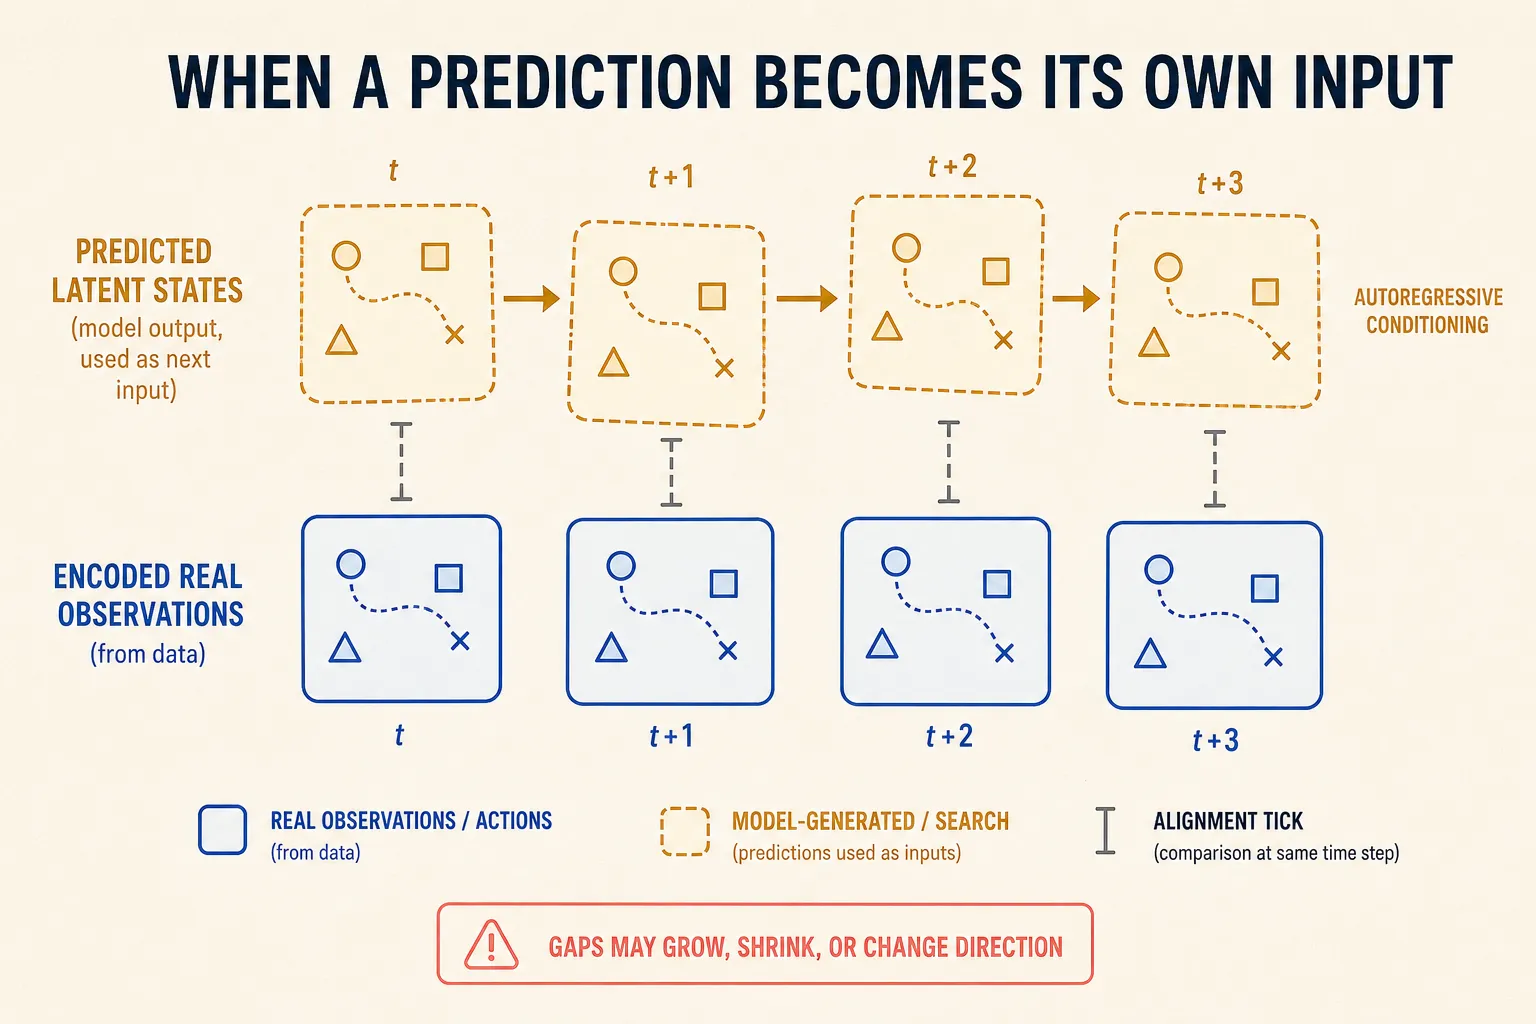
一个小故事
把一张图片复印一次,看起来也许没有问题。再把复印件反复复印,微小失真就可能产生显著影响。
LeWM 的滚动展开是自回归的。第一次预测从编码后的真实观测开始,后续预测则可能消费先前预测出的潜在状态。训练和单步测试通常看到的真实上下文,比长时间规划滚动展开更多。这就是训练—滚动展开上下文差距。
不过,复印故事也有局限:误差不一定平滑增长,也不一定永远增长。动力学可以放大、旋转、抵消或衰减一项差异。应当测量曲线,而不是假设误差会指数或单调漂移。
真正规则
针对同一个留出回合和同一段记录动作序列,保留两条路径:
- 记录上下文路径: 每一步都重新编码真实观测。
- 自反馈路径: 初始历史之后,把预测结果反馈给下一次预测。
把每个预测潜在状态,与冻结编码器为现实中实际后继观测产生的潜在状态相比较。绘制误差随模型时域的变化,而不只查看终点。按穿门、开始接触、丢失接触、动作幅度和经验支持范围分别切片。
原始 LeWM v3 只输出一个潜在估计。它不会输出经过校准的置信度,也不会给出可能未来的分布。确定性输出并不意味着环境本身是确定的。
单步准确率仍然有用,只是回答的问题更小。良好的记录上下文预测,可以与糟糕的自反馈滚动展开、错误的终端代价或损坏的执行适配器同时存在。
可能骗过我们的把戏
CEM 的职责是寻找较低的预测代价。如果某个不受数据支持的动作序列,会让学习到的滚动展开产生不切实际的乐观结果,那么增加候选数或优化轮数,反而可能更可靠地找到这个漏洞。
不要把每一次失败都直接叫作“模型利用”,而应检验下列主张:
- 固定一组动作序列库。
- 比较想象代价与真实执行结果。
- 标注动作支持范围和时域。
- 保持模型、任务和真实动作预算不变,增加搜索预算。
如果预测出的最佳代价改善、选中序列离数据支持范围更远,同时真实结果以配对方式恶化,模型利用就成为可信假设。仅凭最终崩溃,无法区分动力学、代价、搜索、支持范围和执行问题。
如果预言机代价修复了候选排序,但滚动终点仍错误,应修复动力学。如果采用预言机动力学加学习代价后仍偏爱错误路线,应修复代价或表征几何。缩短时域可以减少滚动深度,却无法修复一把把隔墙状态错误排序的直尺。
实验凭据
保存检查点、预处理、初始真实历史、对齐的记录动作、动作块语义、教师强制和自反馈潜在状态、每个时域的误差、支持范围标签及所有随机种子。标记第一次定性分歧,而不只记录最后一张难看的图像。
这一机制以作者提交 8edfeb3 中冻结的 LeWM 滚动展开代码,以及 LeWorldModel v3 的局限性讨论为依据。模型利用思想在相邻工作 Model-Based Planning with Energy-Based Models 中也有先例。
独立的 TwoRoom 重实现 报告称,在一个环境、每项配置只使用一个训练随机种子的条件下,单步误差能够排序三个检查点的短时域成功率,却不能排序其长时域成功率。该研究没有确定原因;它不能证明漂移或模型利用普遍存在。
快速检查
- 记录上下文预测与自反馈预测之间发生了什么变化?
- 为什么一个确定性潜在状态并不代表经过校准的确定性?
- 哪种成对变化趋势会让模型利用成为可信假设?