课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
全局图景
- 缓慢的链条每个想象出的步骤都要等待上一步。
- 跨大步前缀预测或层次结构可能有用。
- 错误的终点更长的视界修不好错误的代价函数。
一个小故事:四家旅行办事处
一名信使必须穿越整个国家。办事处 A 一条接一条地画出每条道路。办事处 B 并行地询问:“前 1、2、3 或 4 条指令分别会把人带到哪里?”办事处 C 使用可复用的火车区间来规划。办事处 D 则凭空发明了一座靠近目标、却不与任何轨道相连的魔法车站。
四家都宣称自己在做“长程规划”,但它们修复的是不同问题。基线 LeWorldModel v3 以自回归方式向前滚动潜在状态:候选计划可以彼此并行,但每个计划内部的时间步仍然是串行的。后面的预测状态会把前面的预测状态当作输入,因此计算量和模型误差都可能累积。
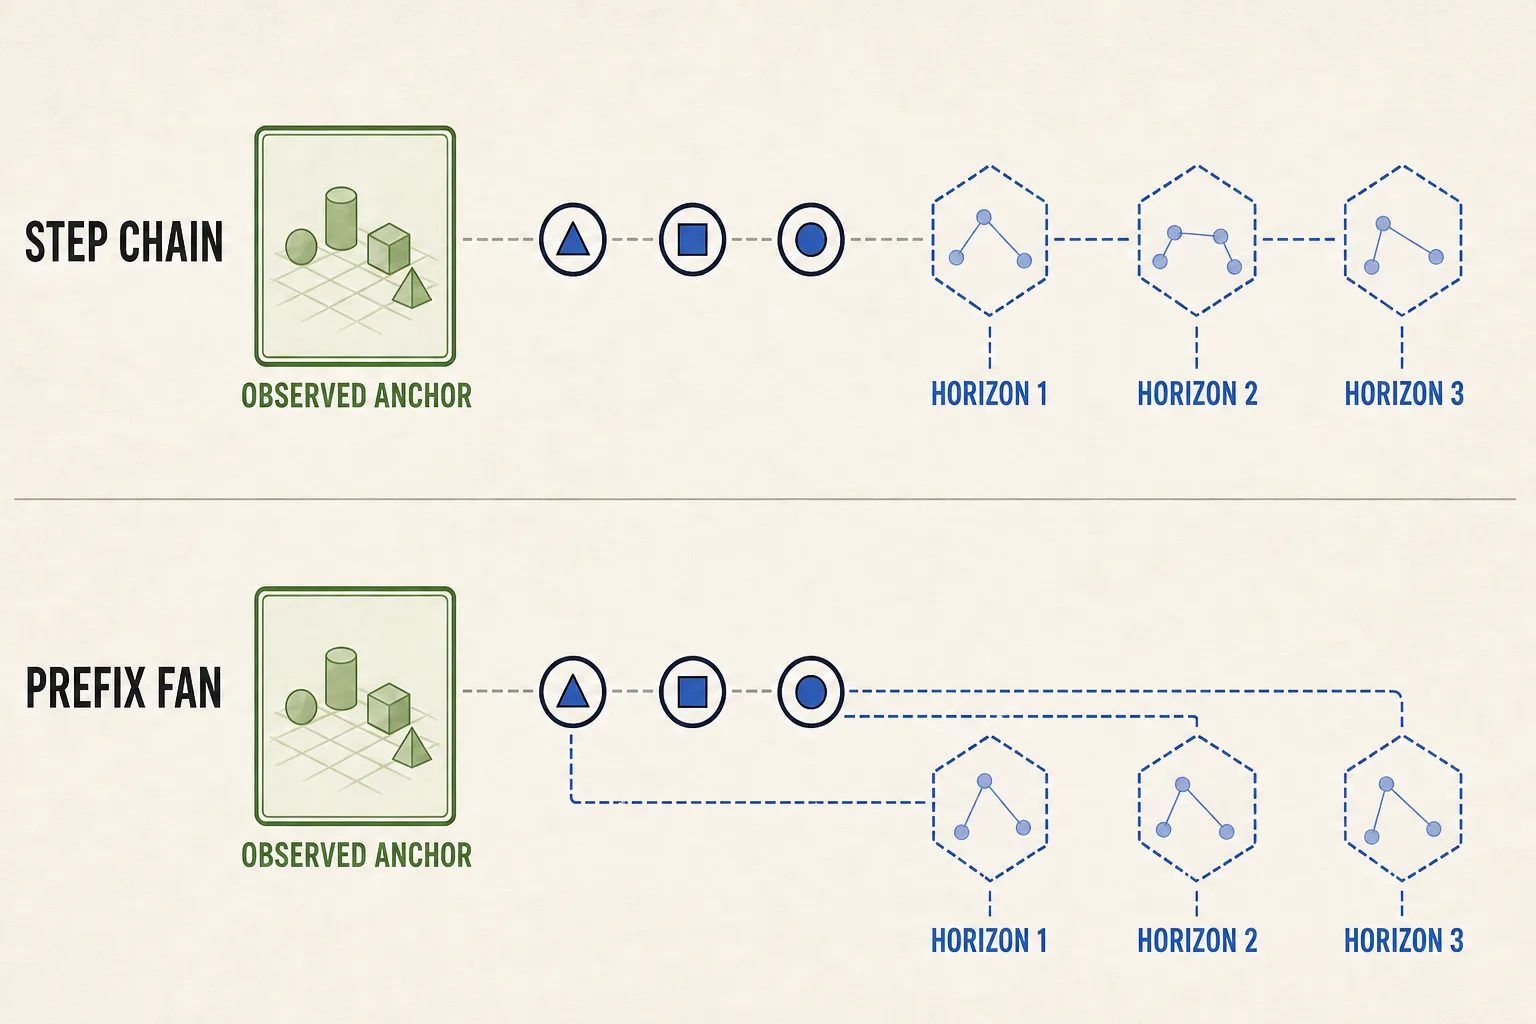
扇形结构改变了预测接口;它不会因此生成多个随机未来,不保证校准,也没有取消动作搜索。
技术背包
| 路线 | 确切改动 | 必须随时附带的边界 |
|---|---|---|
| 基线 v3 | 在 CEM/MPC 内进行单步、自我馈入的潜在滚动预测 | 候选项并行不会消除时间依赖 |
| Fast-LeWM | 从同一个观测锚点并行预测多个前缀视界 | “多个未来”指多个时间视界,而非多模态结果;编码、采样、评分和模型误差仍然存在 |
| VLWM,Beyond the Next Step | 用分块调度进行可变长度的直接预测 | 它不是 Fast-LeWM;所报告的平均 13% 使用训练种子 3072,并对每个 (dataset, Δ) 在事后选取最佳 P1/P2/P3 |
| 2024 年层次 RSSM 研究 | 学习更粗时间层级和抽象动作 | “HWM”是本课程的简称,不是论文中的方法名,也不是 LeWM 变体 |
| Hi-LeWM | 高层 CEM 在一个冻结的低层 LeWM 之上提议潜在子目标 | 不受限制的宏动作和子目标可能离开训练支持;层次化不会自动变得更好 |
一个有用的层次结构需要:可复用的动作块;一个误差增长速度慢于所节省低层工作量的高层模型;低层控制器真正可达的子目标;以及两层都足够的搜索预算。经验宏动作搜索能使提案更靠近已观测的锚点,但接近数据并不是可达性或安全性证书。
在增加任何时间视界之前,先测试终端度量。独立 TwoRoom 后续研究报告称,对其审计的检查点和协议而言,仅更换代价函数就大幅改善了远距离目标的结果。这标识了该设置中的规划器接口瓶颈;它不能证明所有长视界失败都是代价函数导致的。
尝试推翻这个想法
给一名完美的低层司机安排一座不可能的高层车站:它在潜在欧氏距离上看似接近目标,却落在已编码宏动作的集合之外,而且与目标之间隔着一面墙。提高高层视界和 CEM 种群数。如果规划器反而更自信地选中了这座不可能的车站,那么更多搜索只是放大了支持不匹配。
现在比较四个锁定条件:基线滚动预测、前缀预测、使用自由潜在子目标的层次结构,以及受经验宏动作约束的层次结构。使用完全相同的数据、编码器、低层模型、动作预算、候选项统计口径、目标和随机种子。记录实际时延、模型调用次数、滚动误差、支持距离、子目标可行性和闭环成功率。没有匹配硬件和预算的加速比不可移植;没有可行子目标的成功率提升,也不能作为层次结构的证据。
实验凭据与证据边界
- 基线:LeWorldModel v3,固定代码
8edfeb3,修订于 2026-06-03。 - 后续方法:Fast-LeWM v1,代码
492752d,发布于 2026-06-24;VLWM v1,发布于 2026-06-19,未找到作者关联代码;Hi-LeWM v2,代码4bb21a2及 Zenodo 制品,修订于 2026-07-15。 - 相邻工作与审计:2024 年层次 RSSM 研究;TwoRoom 复现;Objective Is the Bottleneck;tinylab
efa9e5d。 - 证据截止时间:2026-08-20,Asia/Tokyo。后续性能和效率声明均为作者自报;独立复现只对明确声明的 TwoRoom 重新实现及协议成立。每项加速声明都必须附带硬件、视界、候选预算和基线实现。
三个快问快答
- 即使候选项已经向量化,基线滚动预测中哪一部分仍是串行的?
- 为什么一个在潜在空间中看似可达的子目标,对低层控制器而言可能无法使用?
- 在为更长时间视界付出成本之前,应该先诊断什么?