课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
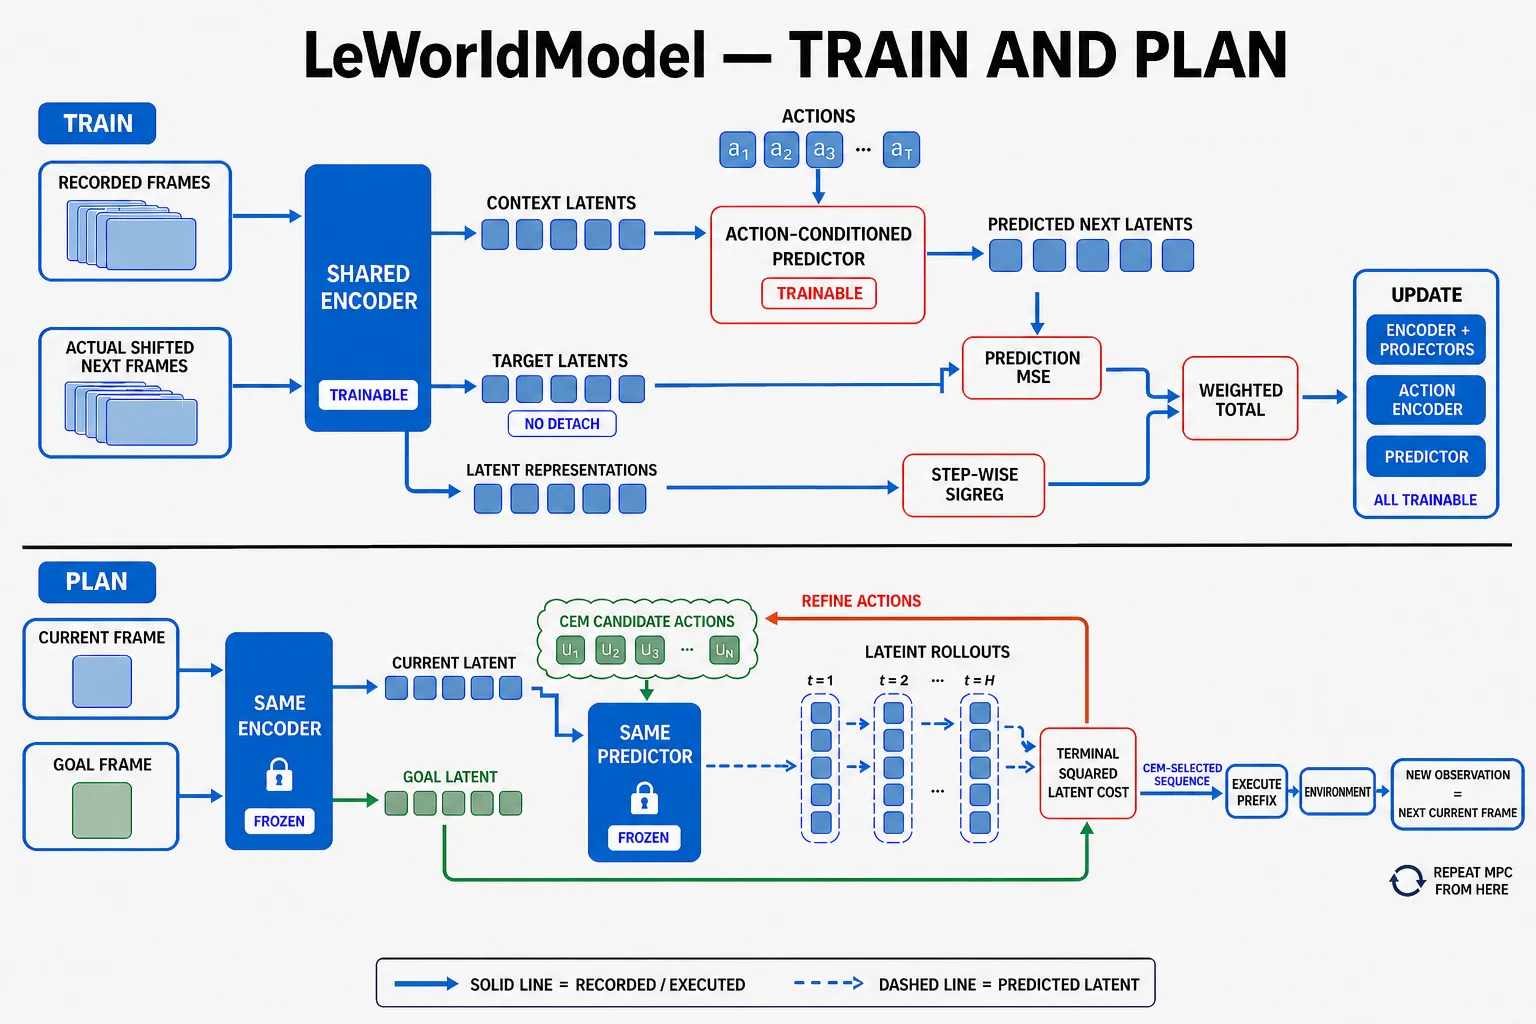
先看全景
- 训练真实过去 + 真实下一步
- 学习编码器 + 动力学
- 冻结模型停止变化
- 规划想象未来 + 反馈
一个小故事
在白天的控制室里,LeWM 学习记录下来的旅程。它可以查看真实的下一帧,将自己的猜测与答案比较,并更新编码器和预测器。到了夜间,训练好的模型开始帮助选择动作。尚未执行的未来是一片空白,因此每个候选未来都必须由模型自己产生。
混淆这两间控制室,会制造出貌似合理的荒唐结构:带有目标和 CEM 的训练计算图、能够看见真实未来的规划器,或是为了让不可能路线显得便宜而修改模型权重的规划器。
真正规则
两条路径很短,可以直接记住:
TRAIN
recorded frames + actions -> encode -> predict
encoded real next frames -> connected targets
prediction loss + weighted SIGReg -> update the learned components

PLAN
current + goal -> frozen encoder
candidate actions -> autoregressive latent rollouts -> terminal cost
CEM changes the action proposal -> execute K -> observe -> repeat
第一条路径有答案,却没有任务目标。第二条路径有任务目标,却没有尚未执行动作的答案。
用符号表示,图像从 [B,T,C,H,W] 变成潜在状态 [B,T,D]。引用的实验中,图像大小是 224×224,frame skip 为五,而冻结默认设置中抽样的子轨迹包含四个观测位置。v3 附录报告 TwoRoom 的 history 为一,PushT 和 OGBench-Cube 的 history 为三;冻结的全局配置使用 history_size: 3,且 TwoRoom 没有覆盖它。请保留并注明两个来源各自的标签。
训练期间,真实的编码状态提供因果上下文——这里的“教师强制(teacher forcing)”并不意味着存在教师网络。移位后的目标仍与共享编码器保持连接。日志记录或推理阶段的 .detach() 调用,不会让 v3 的训练变成 stop-gradient。
SIGReg 作用于训练嵌入。它会让完全采用常量编码的捷径代价高昂,但它不是规划代价,也不保证学到了物理规律。论文方法中该项权重的默认值是 0.1;冻结 YAML 使用 0.09。二者都不是放之四海而皆准的最优值。
容易骗过我们的把戏
假设规划同时更新候选动作和世界模型权重,终端代价很快下降。动作真的变好了吗?未必——优化器可能只是弯曲了预测器,让它的终点看起来更像目标。
基准方法必须保持下面这条不变量:
model_parameter_change = 0
candidate_action_change = allowed
CEM 只优化动作分布。目标潜在状态绕过动力学,并在终端平方欧氏代价处与想象终点相遇。论文附录 B 的文字说明返回最终提议分布的均值,而算法 2 也允许返回采样到的最佳序列,或均值序列的第一个动作。仓库把 CEM 委托给一个未锁定版本的 stable-worldmodel 依赖,因此必须记录最终解析出的返回约定。
MPC 规划 H 个模型步,执行 K 步,再进行观测。报告中的设置使用 H=5、K=5,且每个模型步包含五个环境步:因此经过 25 个环境步才获得反馈。重规划可以减少想象过期造成的问题;却无法补回遗漏的墙壁,也无法修复错误的目标几何。
证据凭据
LeWorldModel v3、冻结的 train.py 和冻结的 jepa.py,共同支持这套双路径方法、连通的训练计算图、向量化潜在滚动展开和终端准则。
允许的表述是:LeWM 用预测损失加 SIGReg 联合训练编码器和动作条件预测器,随后冻结模型,由 CEM/MPC 搜索并执行动作。不要声称 CEM 能找到全局最优、潜在距离等同于可达性,或 MPC 总是只执行一个动作。
快速检查
- 哪些信息在训练时存在,在尚未执行的规划分支中却不存在?
- CEM 会改变什么,什么必须保持冻结?
- 为什么冻结规划时对目标执行 detach,无法说明训练时的目标也采用了 detach?