课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 看见墙壁 + 门口
- 分支尝试多个动作
- 比较哪种未来更有帮助?
- 重规划再看一次
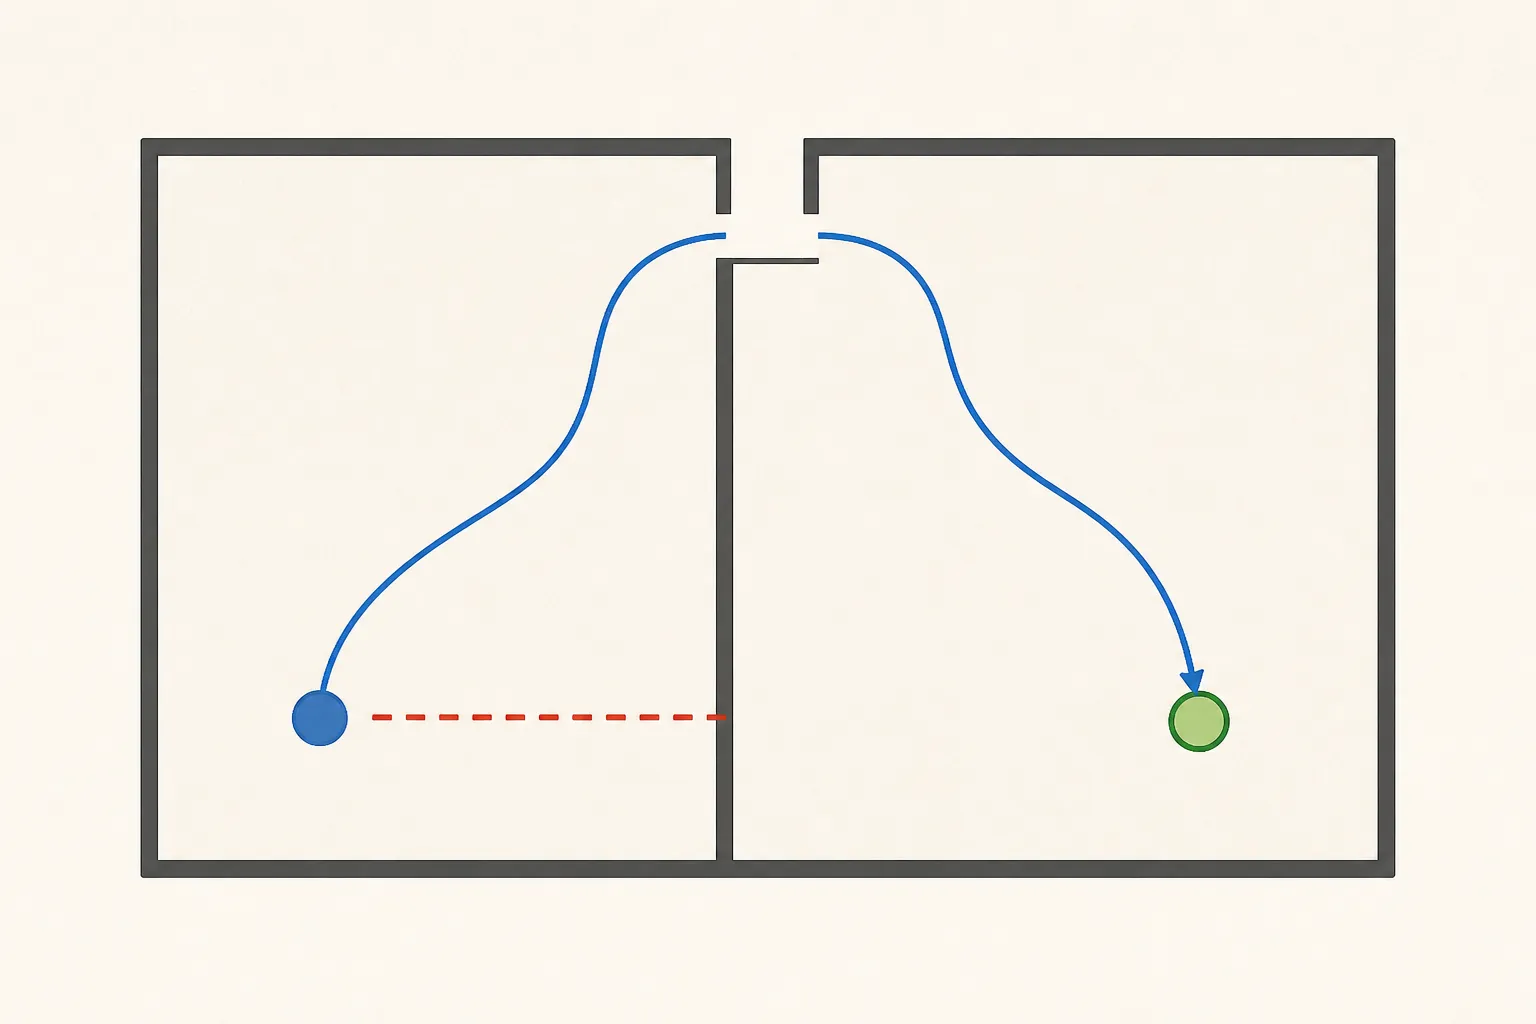
一个小故事
一个机器人把墙壁、门口和目标都看得一清二楚,却仍然撞上了墙,因为它总选择此刻看起来最接近目标的移动方向。真正有用的路线反而会先远离目标,到达门口,穿过墙壁,再折返回来。
只看见名词还不够。行动需要目的、后果模型以及时间。直接策略同样可以很强大,也可以利用历史;差别在于,世界模型规划器会在决策时显式展开多个候选未来并进行搜索。
真正规则
在本课程中,“想象”指的是条件计算,而不是人类脑海中的电影:
current latent history + proposed action -> predicted next latentLeWM 的编码器在潜在空间中描述当前情形。它的预测器会问:“如果执行这个动作,接下来会发生什么?”一个有用的决策模拟器需要三样东西:
- 动作敏感性: 后果不同的动作能够改变预测。
- 滚动展开(rollout): 预测状态可以被再次向前推进。
- 决策接口: 一个代价函数能够将想象结果与目标进行比较。
核心模型预测的是潜在状态,而不是未来视频。论文中的辅助解码器用于检查,不是训练目标,也不参与规划。单个确定性预测还可能掩盖多个合理未来;基准接口并不提供经过校准的不确定性分布。
MPC 让计划始终保持暂定:提出序列、想象终点、为其评分、执行预设前缀,然后再次观察。在论文报告的 LeWM v3 设置中,规划时域为五个模型步,并且重规划前会执行完这五步。每个模型步对应五个环境动作,因此要经过 25 个环境步才获得反馈。每执行一个动作就重规划也是有效的 MPC,但那并不是论文报告的时序。
基准的终点分数,是预测终点与编码后目标之间的平方欧氏距离。这是一把方便的潜在空间直尺,并不等同于可达性、路径长度或行程时间。
容易骗过我们的把戏
去掉前瞻能力,贪心智能体就会贴着墙走,因为每次立即朝向目标的移动看起来都不错。去掉反馈,一条起初合理的路线也可能在可观察的障碍出现后失效。加入 MPC 后,智能体也许能改道——但前提是观测、表征、模型、代价和搜索都确实有用。
同一次碰撞可能源自不同位置:
- 感知: 潜在状态遗漏了墙壁或运动。
- 想象: 预测器穿墙而过,或随时间漂移。
- 选择: 代价函数偏爱错误终点,或 CEM 没有找到门口。
如果模型每轮都系统性地重画同一条虚假捷径,重规划也无法修复它。看到最终失败,并不能确定失败原因。
证据凭据
LeWorldModel v3 和冻结的官方仓库 支持以下机制:像素编码器、动作条件潜在预测器、自回归滚动展开、终端潜在代价、CEM 搜索和可配置的 MPC 前缀。仓库将部分规划与评估工作委托给 stable-worldmodel;必须记录实际采用的求解器约定,不能靠猜测。
TwoRoom 绕路、门被堵住的故事以及三段式诊断,都是教学构造。它们说明前瞻和反馈为什么可能重要;并不能证明所有直接策略都会失败,也不能证明所有基于模型的控制器都会成功。
快速检查
- 为什么远离目标可能是正确的第一个动作?
- 怎样的动作交换结果会警告你:预测器忽略了控制信号?
- 即使每次都有新观测,MPC 仍可能反复犯哪一种错误?