课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
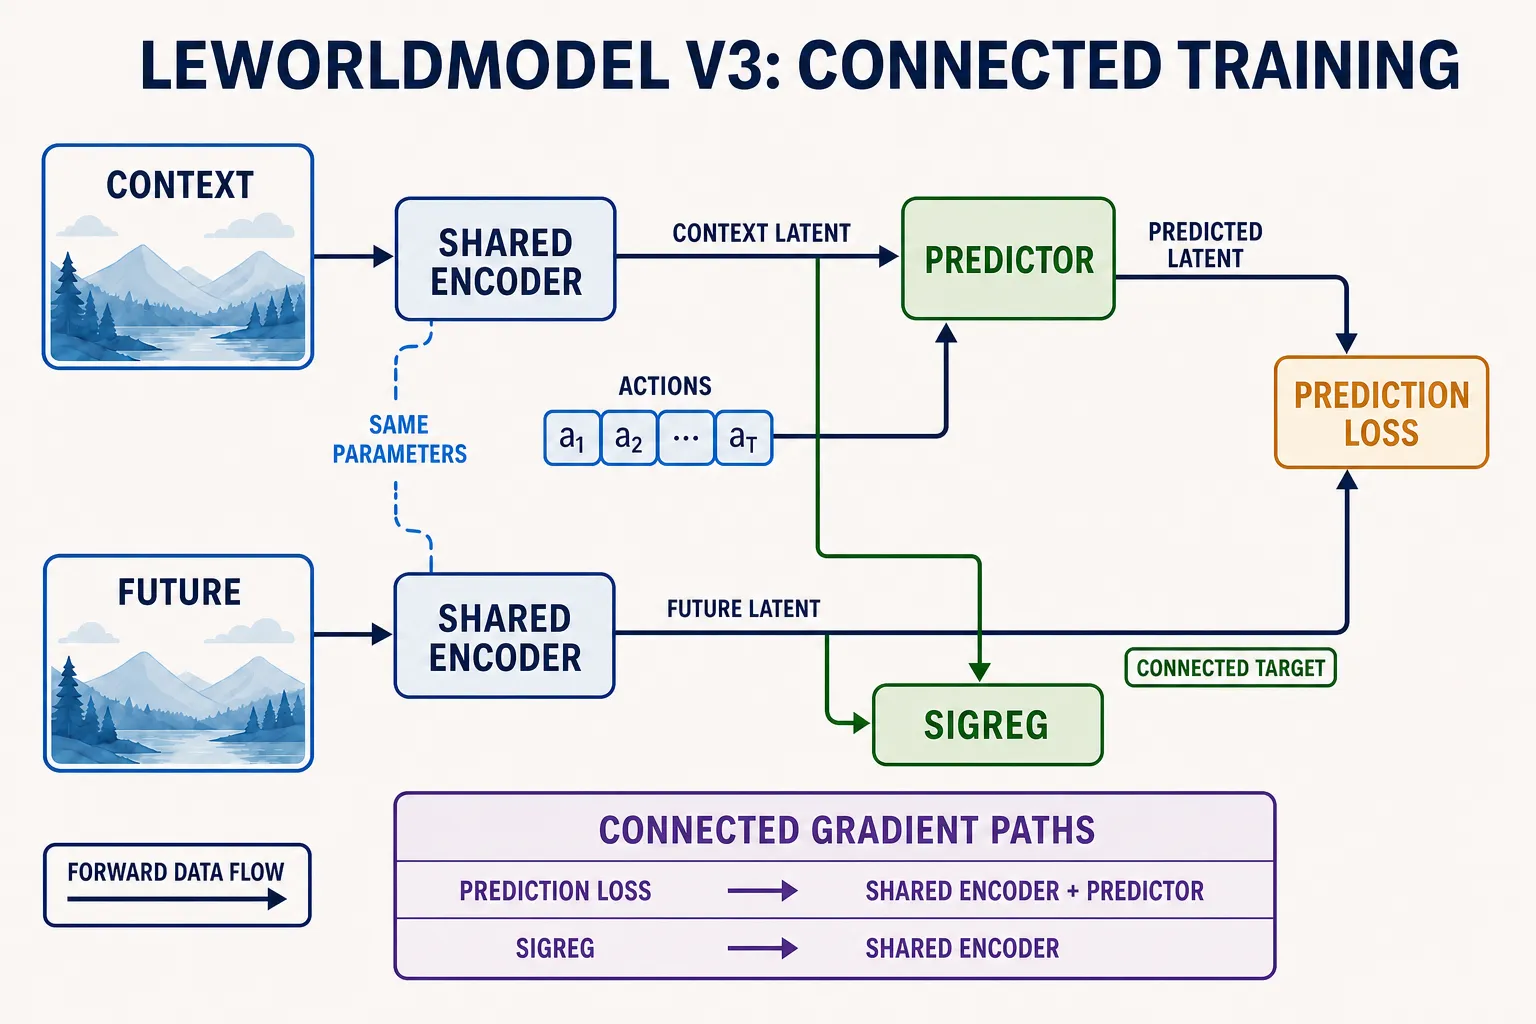
- 一个编码器上下文和未来
- 动作作为预测器的条件
- 连通目标没有停止标志
- SIGReg抵抗常量作弊
一个小故事
一张简单却错误的示意图,画着上下文编码器、浅色目标塔、停止标志和一条 EMA 箭头。它看起来眼熟,是因为 BYOL、I-JEPA 和 V-JEPA 的特定版本确实使用相关的目标机制。但它不是原始 LeWM v3。
LeWM 更像是一位制图师和一位路线规则学习者共同编辑同一张实时地图。SIGReg 是一项分区规定,防止所有地址都挤到同一块土地上。分区规定可以让城市铺开,却无法让道路自动变得正确。
技术背包
v3 的训练拓扑如下:
observations -> one shared trainable encoder -> all latents
context latents + recorded actions -> predicted future latent
predicted future <-> connected future latent
observation latents -> SIGReg
one total objective -> joint update
**目标(target)**一词仅表示“预测要与什么进行比较”,并没有规定谁拥有权重、权重如何更新。冻结的 train.py 从同一段编码序列中切出未来潜在状态,并且在计算预测损失前不会将其 detach。因此,预测压力会通过共享编码器在上下文侧和未来侧的使用路径到达它,同时也会到达动作编码器和预测器。
高斯参考是解析的,不是学习得到的教师。记录中的下一观测是数据,并不是教师网络。原始 v3 还关闭了视觉预训练;“从头开始”意味着视觉编码器仍然存在,只是没有从外部预训练检查点初始化。
只使用预测损失时,每个地点都可以获得同一个地址。在理想的 SIGReg 目标下,一个重复点无法匹配非退化的等方高斯。因此,联合目标会抵抗最简单、最精确的常量解。但它无法让有限优化中的崩塌变得不可能,也无法确保分布广泛的表征保留了罕见的任务变量。
“端到端”的范围止于训练边界。数据集构建不是学习出来的。后续 CEM 规划中,编码器和预测器权重都被冻结,也不会有规划梯度返回去重新训练它们。
命名不同的计算图仍然不同:BYOL v3、I-JEPA v3 和 V-JEPA v1 在所引用的方案中使用 stop-gradient/EMA 目标机制;LeWorldModel v3 则使用共享的连通编码器加 SIGReg。这是机制比较,不是在不同数据和任务之间进行性能排名。
容易骗过我们的把戏
关键字搜索中,三处 .detach() 调用可能看起来完全一样,含义却各不相同:
- 在训练损失之前 detach 未来目标:会改变方法;
- 在损失之后 detach 指标副本:只是日志记录;
- 在冻结规划期间 detach 目标:此时本来就不可能更新模型。
审计时要看数值、调用时机和所处阶段。然后运行一个小型拓扑探针:
A: future target connected
B: future target detached before comparison
C: target connected + SIGReg
钩子应当显示:B 只丢失目标侧的预测路径,而 C 新增了一条编码器侧的群体分布路径。一个 batch 能揭示连接关系,却不能说明哪种变体最终训练或规划得更好。
证据凭据
这张计算图来自 LeWorldModel v3、冻结的 train.py 和冻结的 model/lewm.yaml。比较对象分别绑定到 BYOL v3、I-JEPA v3 和 V-JEPA v1。
允许的表述是:LeWM v3 完全采用端到端训练,并且在结构上不同于这些有明确名称的停止目标/EMA 方案。不要声称 EMA 已经过时、SIGReg 能普遍替代教师、从头训练天生更好,或梯度连通就证明学到了物理规律。
快速检查
- 为什么“目标”并不意味着“教师”?
- 哪些学习路径会收到预测压力?SIGReg 又会直接作用于哪些路径?
- 日志记录、冻结目标和损失前的未来目标中,哪一种 detach 会改变 v3?