课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
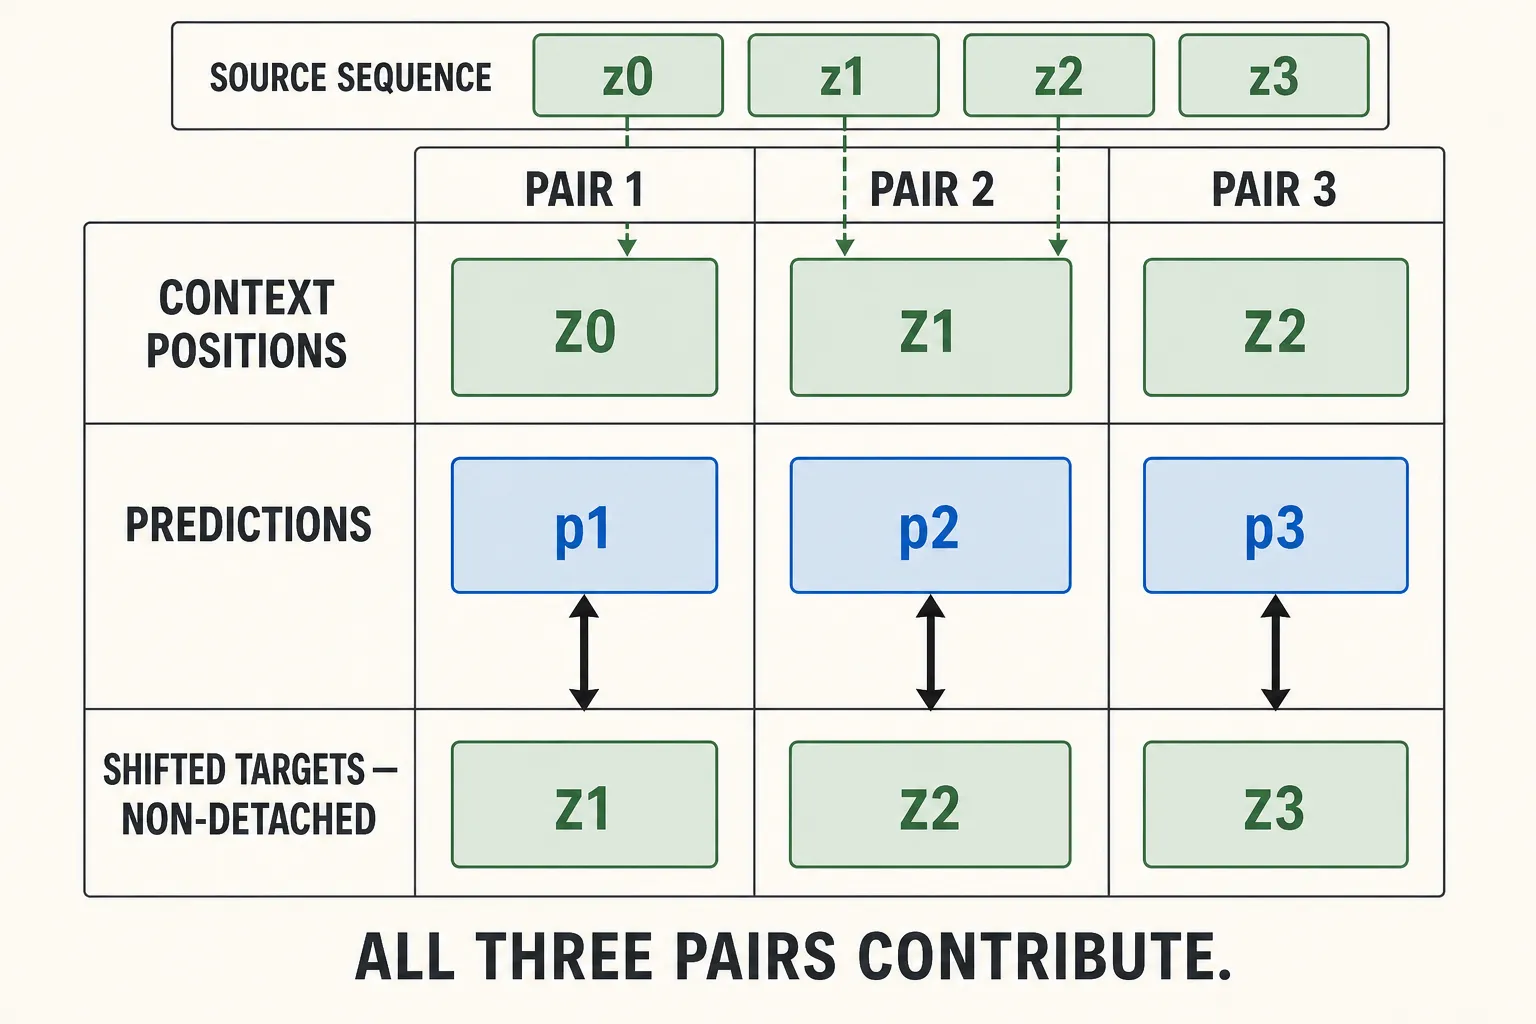
- 编码四个z0 z1 z2 z3
- 对齐三个a0 a1 a2
- 预测三个p1 p2 p3
- 拉合目标p1↔z1, p2↔z2, p3↔z3
一个小故事
工厂可以生产尺寸正确、内部标签却完全错误的箱子。LeWM 的 batch 也可能这样。三个预测和三个目标在形状上可以完全匹配,即使每个预测都与当前状态而不是下一状态进行比较,只训练了最后一组样本,或目标已被 detach。
本章作出一个简单承诺:确保来源可追踪。对于每个位置,我们都能指出对应的观测、动作块、预测和目标。
技术背包
冻结默认值让整个前向传播变得具体:batch B=128、history_size=3、num_preds=1、潜在宽度 D=192,以及 frameskip=5。
pixels                 [B,4,C,H,W]
flattened pixels       [B×4,C,H,W]
observation latents    [B,4,192]
raw action blocks      [B,4,5×A]
encoded actions        [B,4,192]
state/action context   [B,3,192]
connected targets      [B,3,192]
predictions            [B,3,192]
SIGReg input           [4,B,192]
losses                 scalar
论文报告 TwoRoom 的 history 为一,PushT/OGBench-Cube 为三;冻结的全局默认值为三。这些形状描述的是冻结默认配置,而不是所有 LeWM。
最短而又忠实的前向传播卡片如下:
z = encode_each_frame(images)              # [B,4,D]
u = encode_each_action_block(actions)       # [B,4,D]
z_pred = causal_predict(z[:,:3], u[:,:3])  # [B,3,D]
z_next = z[:,1:]                            # [B,3,D], do not detach
L_pred = mean_square_gap(z_pred, z_next)
L_sig = sigreg(time_first(z))               # [4,B,D]
L_total = L_pred + lambda * L_sig全部三组移位后的单步样本对都参与计算。num_preds=1 表示目标偏移一个位置,并不是只有最后一个输出。在这些数据配置中,一个模型步跨越五个环境动作。
预测分支会直接训练视觉编码器、编码器投影器、动作编码器、因果预测器和预测投影器。因为 z_next 保持连接,预测梯度还会经过共享视觉编码器在目标侧的使用路径返回。SIGReg 只直接训练视觉编码器及其投影器。一个优化器更新整套连通的学习系统;不存在目标编码器优化器或 EMA 更新。
SIGReg 在 batch 中查看每一个相对时间位置。不能把 B×T 展平为一个群体,因为时间变化与样本间多样性不是一回事。冻结代码使用 1,024 个随机投影和从 0 到 3 的 17 个频率节点。论文附录采用了不同的求积表述。论文方法的权重是 0.1,冻结 YAML 则是 0.09。务必保留每个数值的来源标签。
容易骗过我们的把戏
故意构造一条错误分支:
wrong targets: [z0,z1,z2]
right targets: [z1,z2,z3]
二者都是 [B,3,D]。错误分支可以学会复制当前状态,并报告令人满意的损失。使用明显的时间校验和,并打印 prediction_slot / last_visible_context / target_source。正确的三行分别是 0/0/1、1/1/2、2/2/3。
然后测试计算图。在一次性探针中,只对正确的目标切片执行 detach,确认目标侧梯度路径消失,而上下文路径仍然存在。仅仅发现编码器有某种梯度还不够。
五项廉价检查可以捕获绝大多数管线错误:精确形状、移位来源、因果未来突变、所有预期模块中有限且非空的梯度,以及没有 NaN 或无穷值。通过这些检查只能证明机械结构正确,并不能证明动力学或规划有用。
证据凭据
LeWorldModel v3、冻结的 train.py、jepa.py 和 module.py,支持这里所述的冻结对齐方式和连通计算图。论文展示的训练伪代码中,F.mse_loss 调用格式有误,因此在精确索引问题上,应以可执行的 train.py 为准。
不要把下一状态目标称作规划目标,不要出于 JEPA 的习惯将其 detach,不要在 SIGReg 中混合 batch 与时间,也不要把形状匹配当作正确性的证明。
快速检查
- 四个观测会产生哪三组预测—目标样本对?
- 预测损失可以通过视觉编码器的哪两条使用路径传播?
- 为什么错误的时间目标可以通过所有普通形状断言?