课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 采样抽取完整动作计划。
- 想象让每个计划在冻结模型中滚动展开。
- 选择保留代价最低的精英。
- 重新拟合移动提议分布并重复。
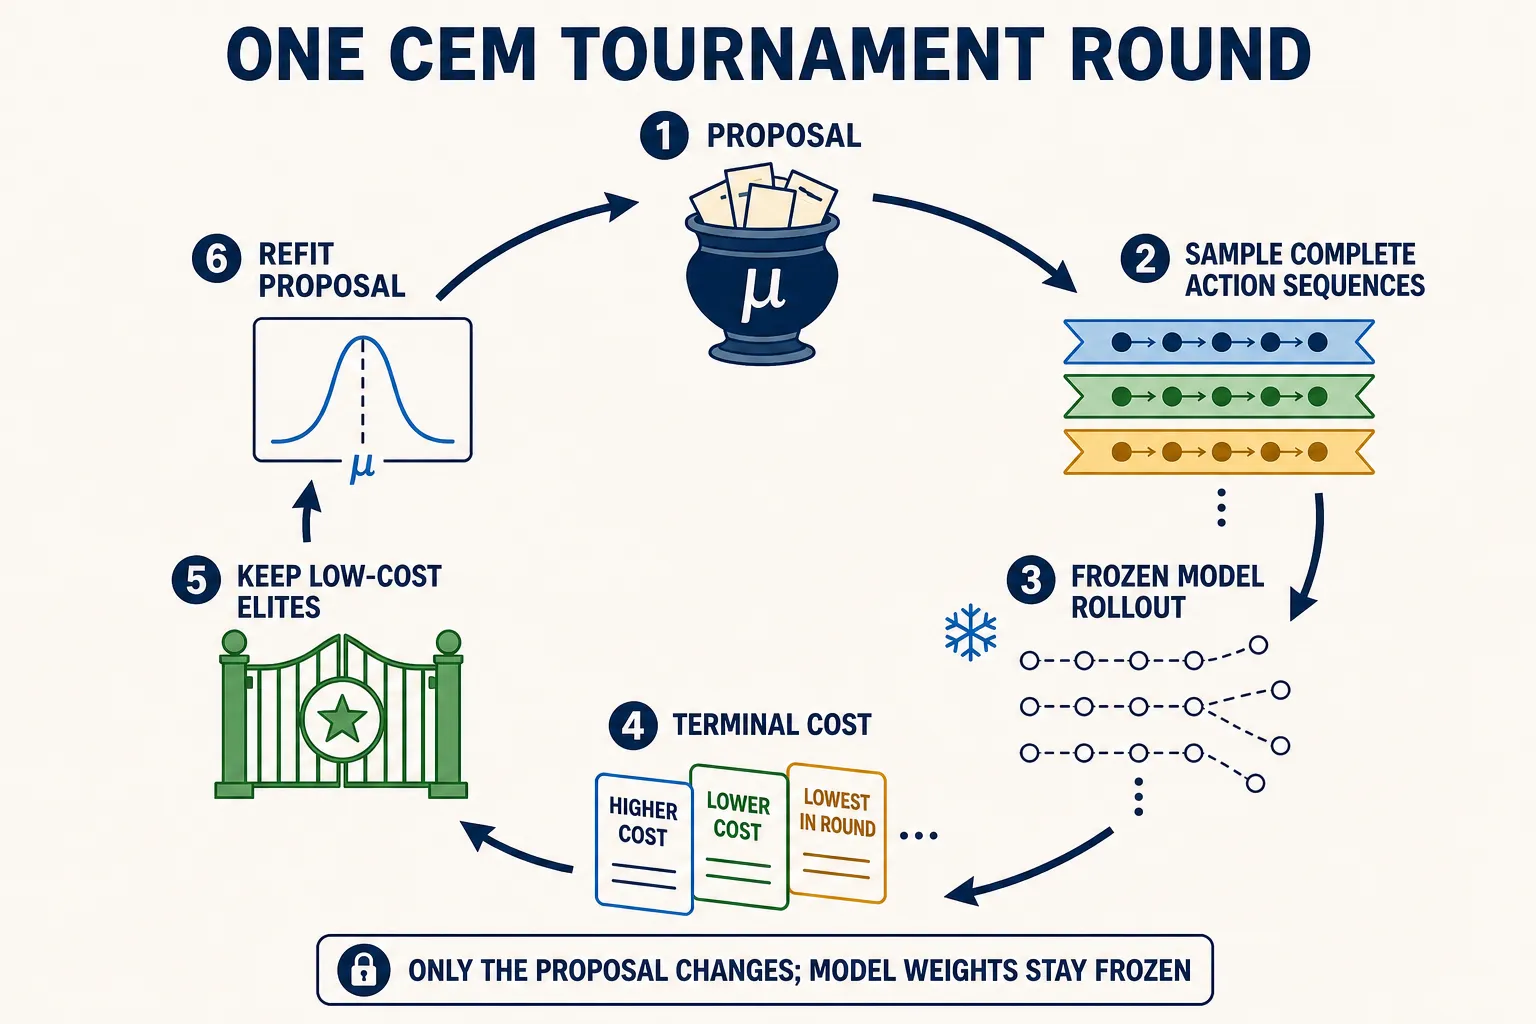
一个小故事
一位导演不可能观看所有舞蹈。于是 300 名舞者分别表演一套完整动作,其中模型预测分数最好的 30 套会影响下一轮选拔。几轮过后,选拔范围会集中到有希望的动作附近。
这就是 LeWM 规划使用的交叉熵方法(Cross-Entropy Method,CEM)。这里的“交叉熵”是采样优化器的名称,不是分类损失。训练好的编码器和预测器保持冻结,改变的只有用于采样动作序列的概率分布。
真正规则
一个候选是完整序列,而不是一个贪心动作。便于理解的形状是 [B, N, H, A]:分别表示环境 batch、候选、规划时域和动作块宽度。
initialize a proposal over complete action sequences
repeat for the declared number of rounds:
  sample candidates
  roll them through the frozen world model
  compute one terminal goal cost per candidate
  keep low-cost elites
  refit the proposal from those elites
return the plan using the declared solver convention
命名的 LeWM 设置使用 300 个候选和 30 个精英。论文通用描述与冻结的共享 YAML 都包含 30 轮优化,而附录 D 写明 PushT 最多使用 30 轮,其他环境使用 10 轮。请分开保留这些来源卡片。
论文为其连续控制任务描述了多元高斯提议分布。具体的裁剪、协方差、平滑和边界处理属于最终解析出的外部求解器版本;LeWM 核心并没有锁定该依赖。一般而言也可以使用类别型离散动作求解器,但冻结基准并未确立这种做法。
可能骗过我们的把戏
设想两条绕过障碍物、质量相同的走廊:一条向左,一条向右。精英分成两组,它们的高斯均值却正好指向障碍物。
因此,应分别记录采样到的最佳计划和最终提议均值。LeWorldModel 附录 B 使用最终均值;算法 2 则允许返回找到的最佳序列,或最终均值的第一个动作。接受检查的两个 stable-worldmodel 版本——标签 0.0.5 和快照 addbab4——都返回最终均值。由于 LeWM 没有锁定其历史依赖,这不能证明作者运行过其中任何一个确切版本。执行 best_seen 是一种有用且应明确标注的变体,而不是可以悄悄替换基准的做法。
更多搜索并不总是更安全。CEM 可能错过狭窄的优质走廊、过早收缩、面对平坦代价、把多个模式求平均、饱和于动作边界,或更高效地发现学习模型中的漏洞。“精英”只表示“这一轮采样中,在该模型和代价下表现最好”,并不意味着它在真实环境中可达或能成功。
实验凭据
记录时域、动作宽度和变换、提议分布随机种子与尺度、群体大小、精英数、轮数、候选和精英代价分布、各时域位置的提议分布宽度、边界比例、支持范围警告、模型调用次数、硬件和耗时。真实动作预算必须与想象中的预测器工作量分开统计。
来源边界是 LeWorldModel v3、冻结配置 8edfeb3,以及另行检查的当前求解器快照。独立的 TwoRoom 重实现 在一个环境中比较了 10 轮和 30 轮;它没有找回历史依赖,也没有验证所有基准。
可辩护的结论很小:CEM 会把有限样本集中到模型预测代价较低的动作序列附近。它既不保证全局最优,也不保证真实成功。
快速检查
- CEM 过程中什么会变化,什么保持冻结?
- 为什么两组优质精英可能产生一个糟糕的提议均值?
- 哪些论文与代码卡片对非 PushT 环境的优化轮数表述不一致?