课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
全局图景
- 真实帧[B,T,C,H,W]
- 潜在旅程[B,T,D]
- 移位一步上下文 → 下一目标
- 多个未来[B,N,H,D]
一个小故事
两个行李箱可以尺寸完全相同,却应该登上不同航班。张量也是如此。一次变形可以保留每个值,却把时间变成候选身份;一次广播可以得到预期形状,却沿错误的轴复制目标。程序仍在运行,故事却已经坏了。
每次都使用这些名字:B 是批次,T 是已记录观测位置,C 是通道,图像 H/W 是空间尺寸,D 是潜在宽度,N 是候选序列,规划中的 H 是模型视界,U 是控制块宽度,F 是每个模型步包含的环境时钟步数,A 是动作宽度,P 是图像 patch 数,Dv 是内部视觉宽度。H 的两个含义是一个记号陷阱:请明确说图像高度或规划视界。
形状背包
车道 1:观测变成状态卡
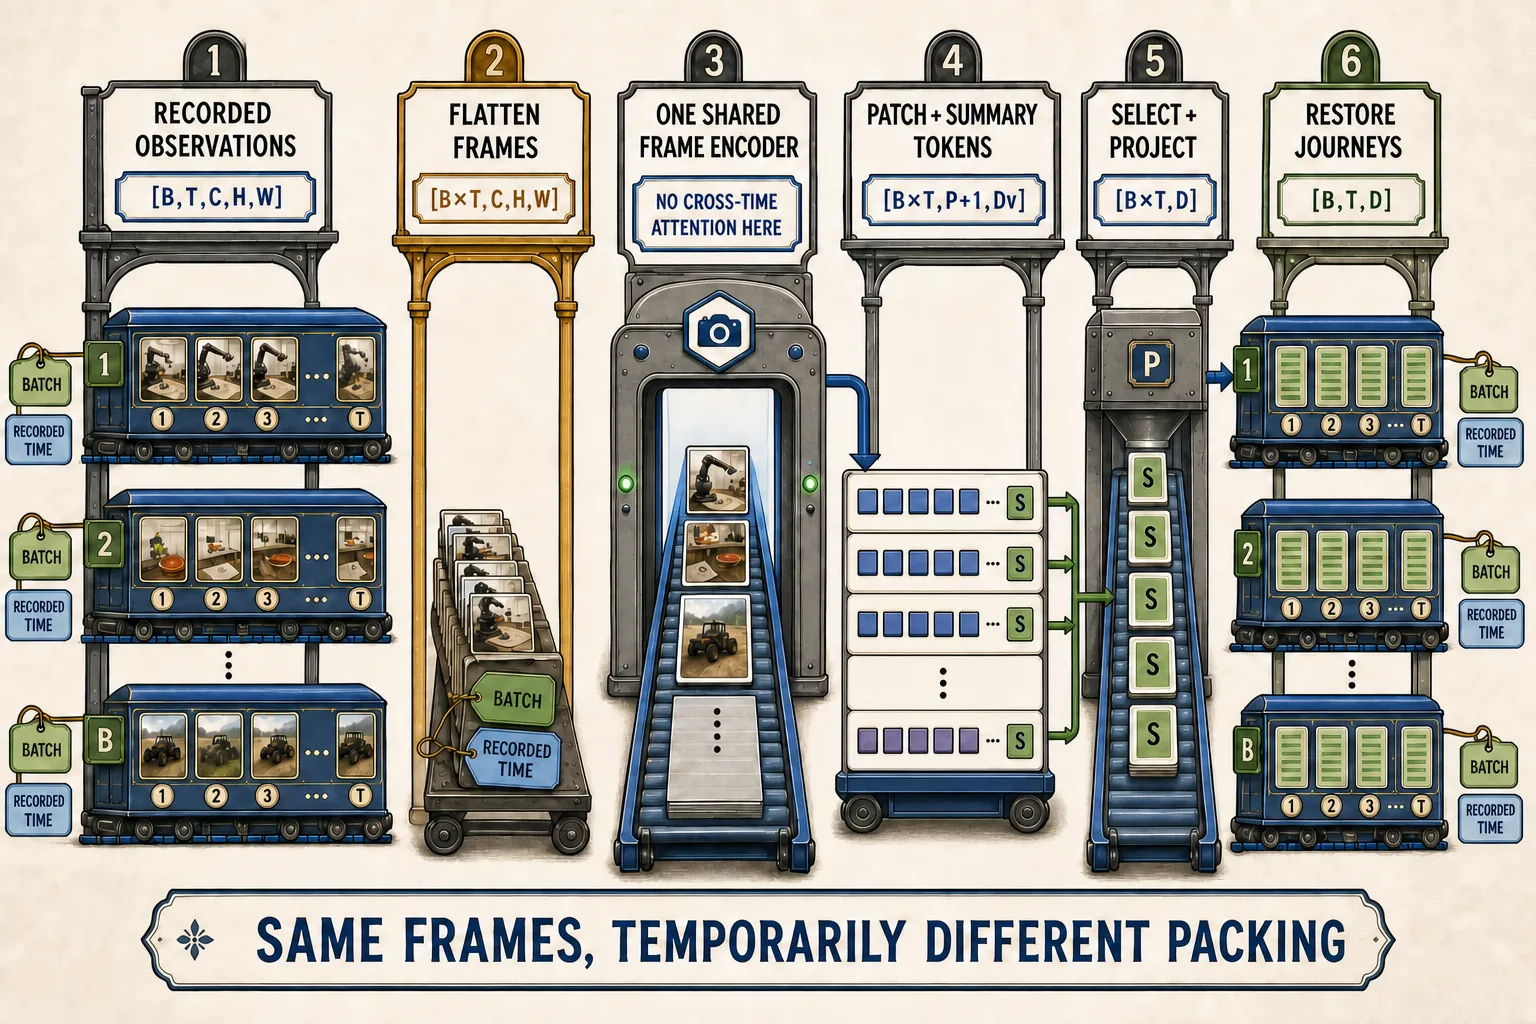
视觉编码器独立处理每一帧。它暂时把批次和记录时间折叠成一个帧批次,编码每张图像,选取摘要 token,做投影,然后还原整段旅程。
| 站点 | 形状 | 含义 | 静默危险 |
|---|---|---|---|
| 加载的观测 | [B,T,C,H,W] | 样本、记录时间、通道、图像高度、图像宽度 | 打乱一次旅程内部的帧 |
| 帧批次 | [B×T,C,H,W] | 独立帧、通道、高度、宽度 | 按错误顺序还原 B 和 T |
| ViT token | [B×T,P+1,Dv] | 帧、patch 加摘要、视觉宽度 | 把 patch 顺序误认成回合时间 |
| 投影后的帧 | [B×T,D] | 帧、潜在特征 | 选错 token 或层 |
| 潜在旅程 | [B,T,D] | 样本、记录时间、潜在特征 | 静默交换批次和时间 |
展平 [B,T] 并不会让视觉编码器获得时间注意力;它只是构造了一个更大的独立帧批次。即使 P、Dv 和 D 恰好在数值上相等,它们仍扮演不同角色。
车道 2:动作与转移对齐
动作不是作为图像通道进入模型的。在冻结基线中,连续 F=5 个环境动作组成一个模型步控制块,动作编码器再把该控制块映射到宽度 D。
| 站点 | 形状 | 含义 | 静默危险 |
|---|---|---|---|
| 原始动作块 | [B,T,F×A] | 样本、模型位置、分组控制 | 跨越回合边界 |
| 编码后的动作 | [B,T,D] | 样本、模型位置、条件特征 | 把动作向后错移一个转移 |
| 训练动作上下文 | [B,T-1,D] | 源转移位置 | 把最后一个加载位置当成额外目标 |
加载的观测和动作可能都有长度 T;单步目标仍只使用前 T-1 个源动作。请用有明显区别的动作测试对齐,不要用移位后看起来仍一样的全零控制。
车道 3:移位拉链
给定四个编码观测,契约如下:
z0 with a0 -> p1 compared with connected z1
z1 with a1 -> p2 compared with connected z2
z2 with a2 -> p3 compared with connected z3| 对象 | 形状 | 角色 |
|---|---|---|
| 状态上下文 | [B,T-1,D] | 真实编码的源位置 |
| 动作上下文 | [B,T-1,D] | 与这些源位置对齐的动作 |
| 预测器输出 | [B,T-1,D] | 预测的后继状态 |
| 移位目标 | [B,T-1,D] | 真实编码的后继位置 |
| SIGReg 视图 | [T,B,D] | 每个记录时间分别在批次总体上接受检查 |
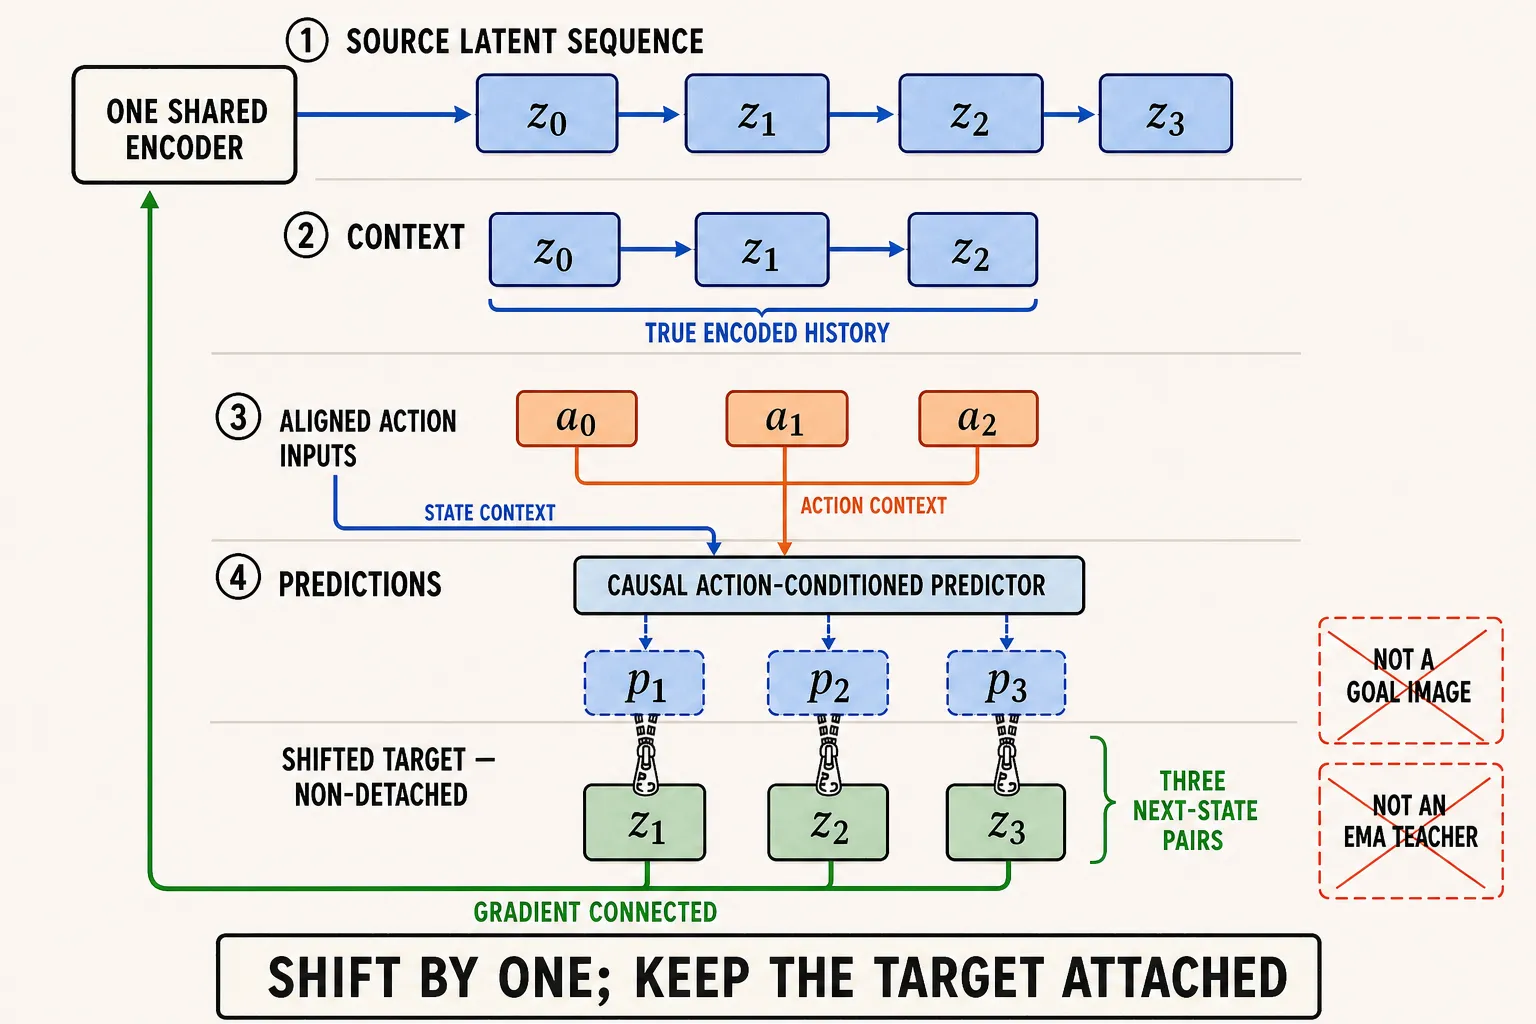
预测与目标形状一致是必要条件,却不是充分条件:拿 p1,p2,p3 和 z0,z1,z2 比较仍会得到一个标量,却教会错误的关系。在原始 LeWM v3 中,z1,z2,z3 来自同一个共享且可训练的编码器,并保持连接——没有停止梯度、EMA 教师或预训练冻结编码器。分离它们会改变计算图,却不改变任何形状。SIGReg 也会保持时间位置彼此独立;展平 T 与 B 会改变它测量的总体。
车道 4:规划打开候选车道
规划时,每个假想动作都没有对应的真实未来帧。系统会沿候选车道复制同一个已观测当前状态,再用冻结的预测器自回归地向前滚动。
| 对象 | 形状 | 角色与允许的复制 |
|---|---|---|
| 当前状态 | [B,D] 或能感知历史的等价表示 | 只沿候选轴重复 |
| 候选动作 | [B,N,H,U] | 问题、候选、模型视界、控制块 |
| 预测滚动 | [B,N,H,D] | 每个候选内部的时间仍按顺序推进 |
| 编码目标 | [B,D] | 只沿候选终点重复 |
| 终点 | [B,N,D] | 每个候选一个预测终点 |
| 候选代价 | [B,N] | 保留到动作序列的映射 |
实现可以为了 GPU 执行而展平 [B,N],但必须还原候选的归属。一个环境中的低代价路线不能选中另一个环境的动作。目标沿候选轴复制,是因为它们共享目的地;目标不会沿预测器时间轴复制成训练监督。
冻结数值卡——不是普适常数
被检查代码中纳入版本控制的默认值为:批次 128,历史大小 3,因此加载 4 个观测位置;潜在宽度 192;单步移位目标;每个模型位置包含 5 个环境动作。一个具体的预测/目标形状是 [128,3,192]。
论文报告 TwoRoom 的历史大小为 1,PushT 与 OGBench-Cube 为 3;冻结的全局默认值是 3,数据配置并未覆盖它。[B,T,D] 是符号契约;[128,4,192] 是冻结代码中的一个实例。始终把论文、冻结代码和解析后的运行分别标注。
骗过我们的把戏
仪表盘显示图像是 5 维的,预测和目标都是 [128,3,192],候选代价是 [1,1024],总损失则是标量。所有指示灯都亮着绿灯。然而目标没有移位;候选轴和视界轴在两者长度都为 5 时被交换;目标也被沿时间轴而非候选轴复制。
用一个带标记的微型批次修复这类问题:两个回合 ID、不同的时间标记、不同的候选 ID,以及不重复的动作。然后依次扰动一个较晚 token、一个候选动作和一个目标。较早的因果输出应忽略较晚 token;只有对应候选车道应对其动作作出反应;改变目标应该改变代价,而不是模型滚动。这些检查证明的是管线不变量,不是模型准确度。
证据凭据
LeWorldModel v3 以及冻结的官方 train.py、jepa.py、module.py和配置文件,支持上文引用的路径与冻结默认值。
允许的说法是:即使重新安排了存储方式,忠实的实现仍会保留具名的观测、时间、动作、候选、视界、目标和潜在角色。通过形状断言并不能证明对齐、广播、梯度流、规划语义或论文复现。本节并未建立独立复现。
快速检查
- 为什么
[B×T,C,H,W]本身不会创造时间注意力? - 哪些目标应该与
p1,p2,p3配对?为什么错误目标也能通过形状检查? - 在
[B,N,H,D]中,哪条轴可以并行,哪一种依赖仍必须顺序执行?