课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
全局图景
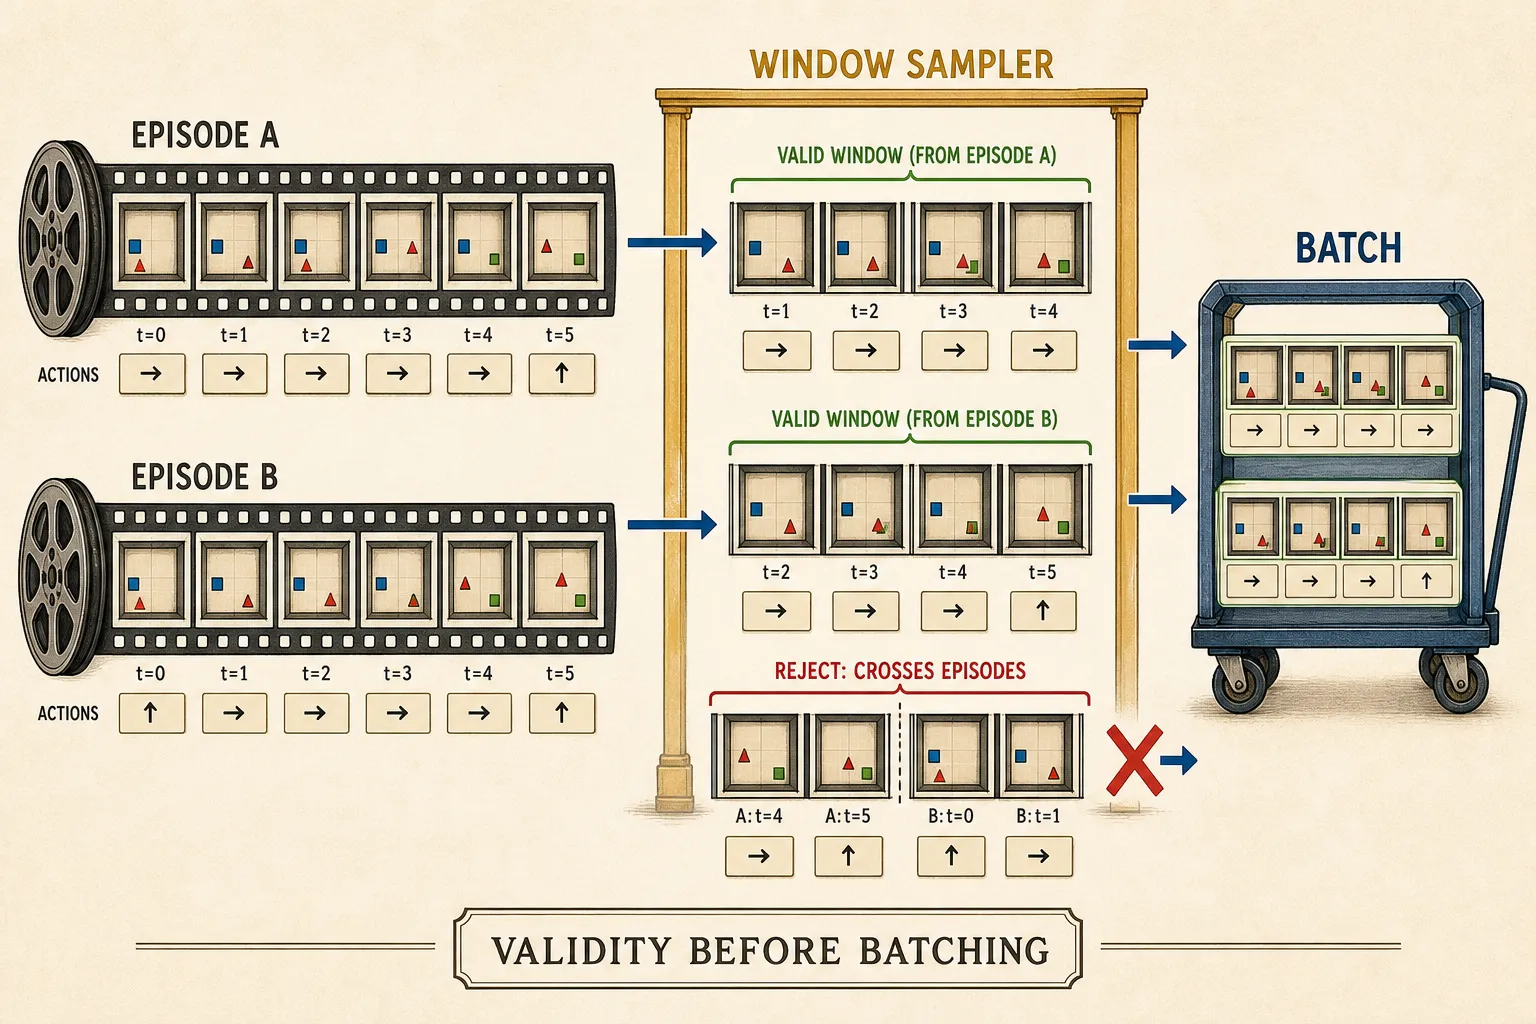
- 保持回合完整先构造有效窗口
- 为每条轴命名带着含义变形
- 测试每条路径掩码、动作、梯度
- 保存整段航程状态加凭据
一个小故事
把 PyTorch 想成一套速度极快的行李系统。无论我们交给它什么,它都会照样分批、变形、广播和相乘。它不会知道两个相邻帧其实属于不同回合,不会知道一个 H 表示图像高度而另一个 H 表示规划视界,也不会知道某个目标本应继续连接到共享编码器。
所以,本附录是一张驾驶舱检查卡,而不是官方实现的逐行替代品。它只问一个简单问题:每次快速移动张量之后,哪些不变量仍应成立?
技术背包
数据与形状契约
Dataset 回答“第 417 个样本是什么?”;DataLoader 则调度这些样本并组成批次。数据集或采样器必须保留回合归属、时间顺序、动作对齐和窗口长度。加载器可以打乱完整窗口,但绝不能把一个窗口内不同回合的帧混在一起,凭空制造转移。
存储格式不等于科学身份。HDF5、Lance、文件夹或视频可以承载同一套轨迹契约;两个 HDF5 文件也可能在预处理、划分、跳帧或动作对齐上不同。容器格式和数据契约都要记录。
在调用 Transformer 前,先准备一张口头登机牌:
batch = independent examples
time = ordered latent positions
feature = learned coordinates
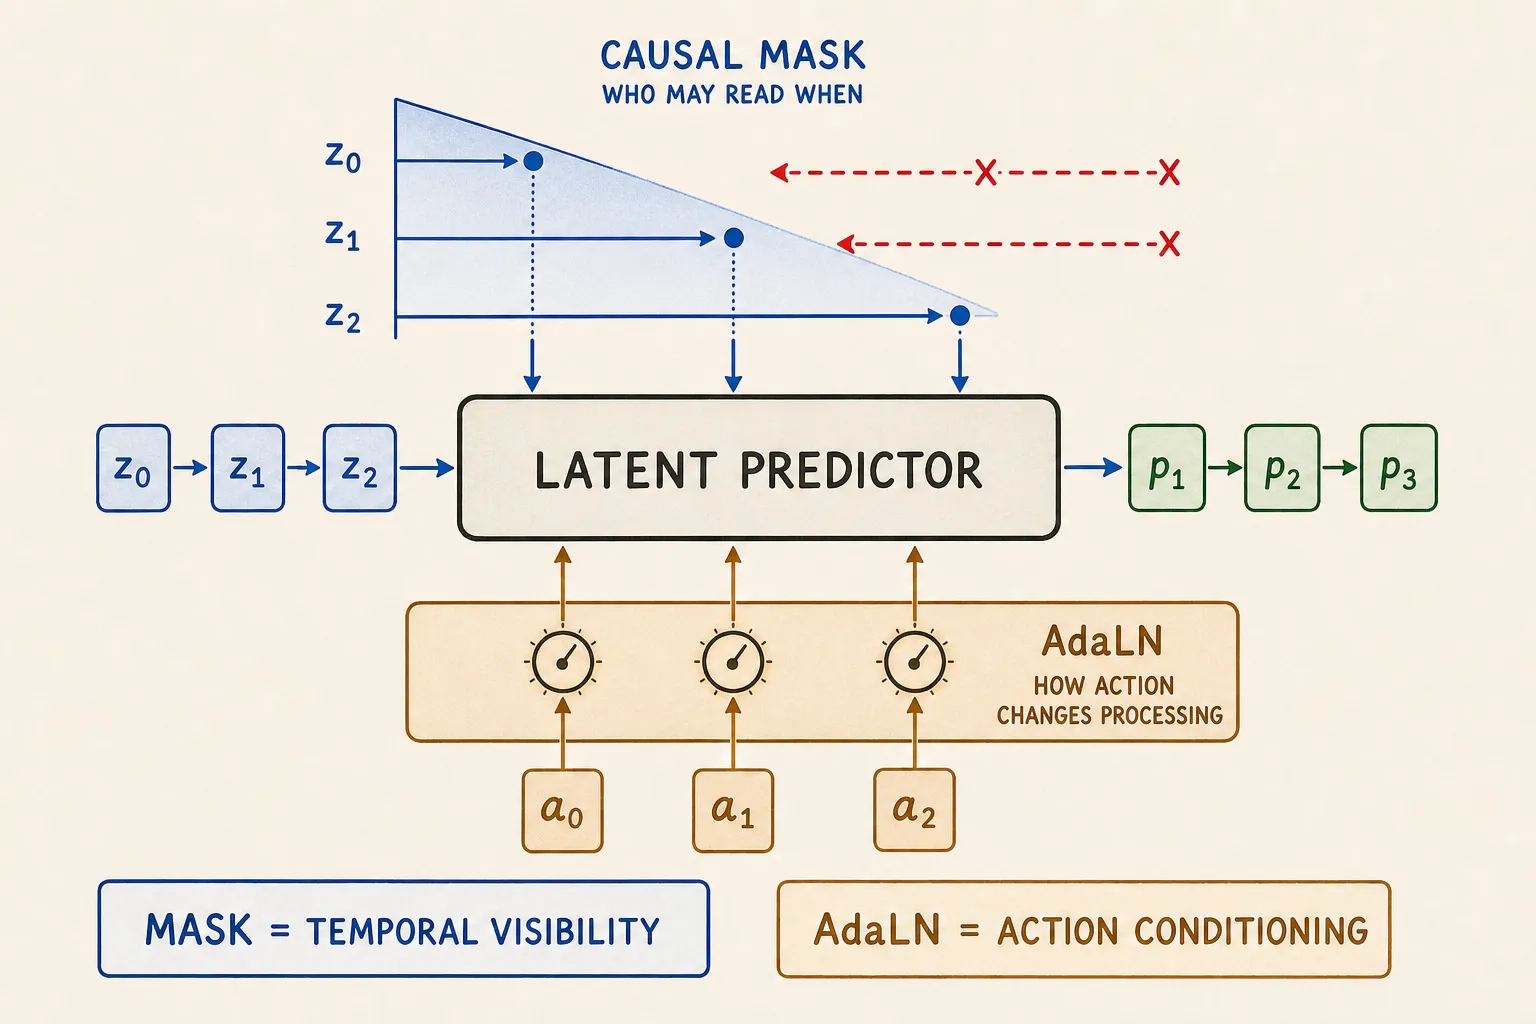
visibility = this position may read only itself and earlier positions
尺寸相等不代表角色相等。如果候选数和时间长度恰好都是 4,交换两条轴后打印出来的形状仍可能不变。做一次可丢弃的变形测试,让易辨认的回合、时间和候选标记一路穿过它。
掩码与动作条件化
因果掩码会阻止当前位置直接看到之后的 token。修改一个较晚的上下文 token,验证较早位置的输出保持不变。通过这项测试,证明的是计算可见性规则,而不是因果物理。
AdaLN 通过平移、缩放和门控调制,为动作提供一条进入 Transformer 块的路径。在冻结实现中,它最终的调制生成器通过零初始化从中性状态开始。这并不保证训练后的模型真的使用动作。固定潜在历史,交换会造成不同后果的动作,再检查预测。
原始 LeWM v3 使用一个共享且可训练的视觉编码器。移位后的下一观测目标仍与计算图连接:没有停止梯度、EMA 教师或预训练冻结编码器。一个将目标分离的重新实现会拥有相同的前向形状,却是另一套学习系统。
SIGReg 参考路径
把冻结的 SIGReg 实现读成五个房间:
collect projected observation embeddings
keep time positions separate; inspect each one across the batch
sample random one-dimensional directions
compare empirical fingerprints with the analytic standard-Gaussian fingerprint
average discrepancies into a differentiable training penalty
把批次和时间展平会改变总体问题。跨设备聚合会改变经验总体;而冻结的 LeWM 类明确是单 GPU 的。分离嵌入会改变梯度。把结果称作 p 值会改变它的用途。有限的方向、小批次和积分点意味着这只是近似,不是高斯性证书。记录这项惩罚时,还要同时记录坐标离散度、协方差谱、有效秩和留出近邻。
滚动与 CEM 路径
可以把候选计划堆叠起来,在 GPU 上并排评估。每个候选内部的时间仍是自回归的:第二步使用第一步预测出的状态。环境批次、候选、模型视界与潜在宽度必须保持区分。
sample sequences from the current action proposal
roll out candidates with the frozen world model
score terminal latents against the encoded goal
select the configured elite action sequences
refit only the action proposal, then repeat
精英索引必须仍指向真正获得对应分数的动作序列。CEM 改变的是提议分布,而不是编码器或预测器权重。连续且有界的动作需要明确声明裁剪/更新语义;离散动作则需要类别型提议分布。向量化节省执行时间,却不会消除时间依赖或模型漂移。
精度、检查点与可复现性
混合精度改变算术的执行方式,不改变预测损失或 SIGReg 的科学定义。监控非有限值,并与一次短暂的全精度冒烟运行比较。这项对照不必逐比特相同,但应能暴露不合理的尺度或脆弱的累积路径。
权重文件支持推理。用于恢复训练的检查点还应标识优化器、训练位置、组合后的配置,以及任何持续演化的调度器或梯度缩放器状态。如果连续性需要随机数生成器状态,就保存它;若没有,也要说明。此外还要记录数据身份、代码修订、软硬件、精度、窗口、预算、检查点规则、规划器设置、目标、随机种子和评估回合。
same data and preprocessing
same model, optimizer, and training budget
same planner and evaluation budget
same episodes and goal rule
declare every intentional difference before reading the score
骗过我们的把戏
两个实验室使用相同的提交、配置、随机种子、检查点和 GPU,损失也完全一致。后来他们发现,两边的采样器都会把一个回合的最后一次观测,与下一个回合的第一个动作配在一起。这个错误得到了完美复现。
重复只确认一套过程,并不认证它的含义。要主动挑战回合边界、单步移位、因果可见性、动作敏感性、梯度接收者、候选身份,以及世界模型训练与规划之间的分离。反过来,两次正确的随机运行也可能在数值上不同,却支持同一个有边界的结论。
证据凭据
PyTorch 文档和 Hydra 文档定义框架抽象。LeWorldModel v3 以及冻结的官方代码 8edfeb336732b5f3ce7b8b210d0ba370a09e2cac定义本课程检查过的计算图与接口。stable-worldmodel只为它后来提供的主动学习平台构成证据,不能倒过来证明原始 v3。
允许的说法是:在已记录的配置下,这些模式保留了具名的数据、形状、条件化、滚动、优化、精度和恢复不变量。它们并不表明加载器理解回合、因果掩码发现物理规律、AdaLN 保证动作得到使用、混合精度没有伤害,或一个随机种子就证明可复现。本节并未建立独立复现。
快速检查
- 哪一层必须拒绝跨越回合边界的窗口?
- “修改较晚 token”测试能证明什么,又留下了什么未决问题?
- CEM 期间,哪个对象会变化,模型的哪些部分保持冻结?