课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 观察像素 + 动作
- 压缩形成潜在状态
- 想象尝试动作的未来
- 行动搜索、移动、检查
这门课程只有一条主线:观察 → 压缩 → 想象 → 搜索 → 行动 → 诊断。后面出现的每个模块,都能在这条线上找到自己的位置。
一个小故事
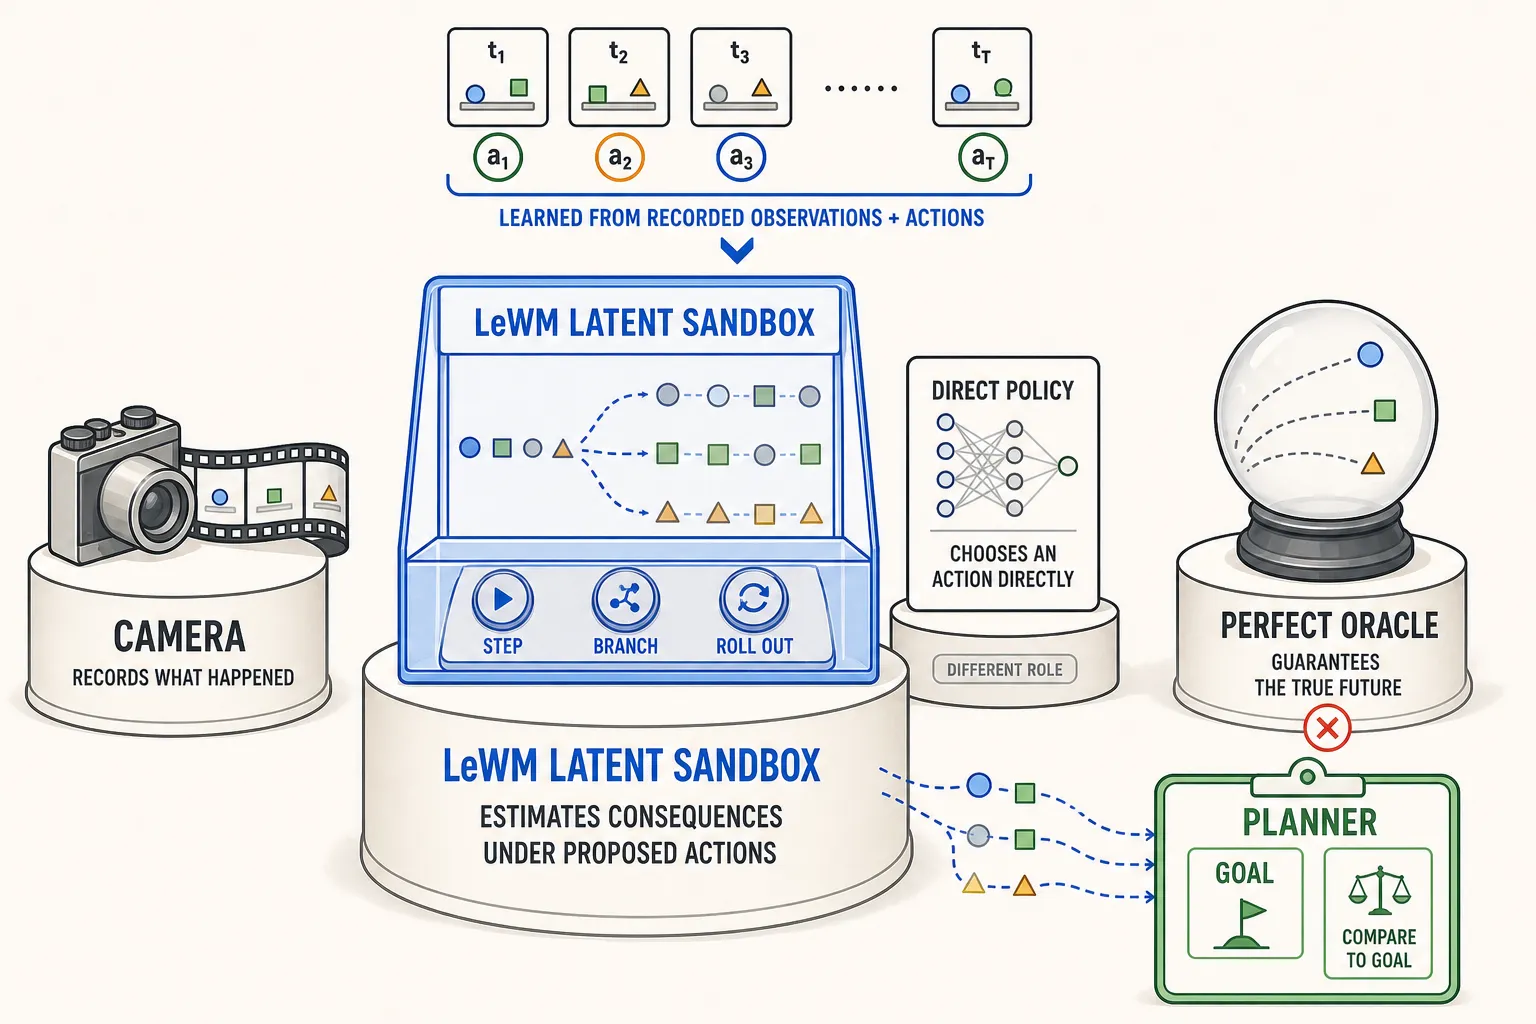
在机器人的工作台上放三种工具。摄像头记录一次真实旅程。**直接策略(direct policy)**可以利用丰富的记忆来选择动作,但在决策时并不会显式搜索许多种未来。**世界模型规划器(world-model planner)**则会先在学习到的模型内部排练候选动作,再作出选择。
LeWorldModel,简称 LeWM,就是第三种工具。它从有序的视觉—动作轨迹中学习。编码器把观测变成紧凑的潜在“通行证”,动作条件预测器让这些通行证随时间向前推进。训练完成后,CEM 在冻结的模型中搜索动作序列,MPC 执行预先设定的序列前缀,然后再次观察现实。
这张通行证并非字面意义上的地图。潜在空间中相近的两个点,在现实里可能位于一堵墙的两侧。一个紧凑状态也可能记住墙纸,却忘掉门口。
真正规则
请区分下面四个名称:
- **世界模型(world model)**描述的是一项任务:表示足够多的变化,使系统能够推理动作的后果。
- JEPA 是一种宽泛思想:根据上下文表征,预测一个学习得到的目标表征。
- LeJEPA 研究结合 SIGReg 与防崩塌机制的预测式表征学习。
- LeWM 在此基础上加入时间、动作、潜在动力学和规划循环。
本课程以 2026-06-03 修订的 LeWorldModel v3,以及冻结在 2026-05-22 的官方代码提交 8edfeb336732b5f3ce7b8b210d0ba370a09e2cac 为基准。LeJEPA v3 和 JEPA 立场论文 v0.9.2 解释的是相关思想,并不是可互换的实现。
原始 LeWM v3 使用一个共享且可训练的视觉编码器。下一观测的目标表征仍与该编码器保持梯度连接。它在训练时不使用 stop-gradient、EMA 教师或预训练视觉编码器。基准世界模型的训练不需要任务奖励或目标,但一定需要按顺序排列的动作。目标要到之后的规划阶段才会出现。
LEARN:     observations + actions -> latent dynamics + non-collapse pressure
FREEZE:    encoder and predictor
ACT:       current + goal -> CEM plans -> execute a prefix -> observe again
DIAGNOSE:  data -> representation -> dynamics -> cost -> search -> execution
容易骗过我们的把戏
设想一个“听不见”动作的预测器。记录下来的大多数 TwoRoom 行程都沿着同一条门口路线前进,因此只根据历史,也可能预测出常见的后续并得到看起来不错的损失。但到了规划阶段,“向上”“向右”和“停留”却都产生几乎一样的想象未来。此时的 CEM,就像在为一位戴着耳塞的评委举办选拔。
这个反例只能证明一点:仅仅预测常见的时间进程,还不足以构成一个动作条件规划模型。交换动作后得到不同预测,是必要证据;但这仍不能证明变化的方向、大小或长期影响是正确的。
证据凭据
本课程的证据截止日期是 2026-08-20。arXiv:2608.10145v1 独立重实现了一个单随机种子的 TwoRoom 系统,并复现了位置探针和按仓库协议执行的规划;它没有复现 PushT、OGBench-Cube 或多随机种子稳健性。arXiv:2608.12959v1 复用了同一系统,因此它是同一证据链上的后续工作,而不是第二次独立复现。
TwoRoom 让墙壁、绕路和错误代价变得容易观察。PushT 又加入接触、旋转和滑动。两个基准都无法证明模型掌握了通用物理,也不能证明它可安全控制真实机器人。教程里的故事和图示是在解释机制,并不是论文实验结果。
快速检查
- 为什么说 LeWM 是排练室,而不是摄像头或策略?
- 原始 v3 的哪些事实排除了 EMA 教师结构图?
- 为什么无奖励训练的世界模型在行动时仍可能需要目标?